上下文工程:利用会话进行短期记忆管理
技术背景
在AI代理的长时多轮交互中,上下文管理至关重要。模型上下文窗口有限(如GPT-5支持272k输入令牌),但未整理的历史记录、冗余工具结果或嘈杂检索会迅速填满窗口,导致模型分心、效率下降甚至失败。有效的上下文管理能保持连贯性、提高工具调用准确性、降低延迟成本、遏制错误幻觉,并简化调试。OpenAI Responses API提供基本记忆支持(previous_response_id),但缺乏自动管理。Agents SDK通过Session对象提供会话记忆,自动处理上下文长度和连续性。
核心原理
上下文工程核心是在有限上下文窗口内最大化信息效用。短期记忆通过会话管理,会话结构包含会话ID、消息列表和元数据。两种主要技术:上下文修剪(丢弃早期轮次,保留最近N轮)和上下文摘要(将早期对话压缩为结构化摘要)。修剪确定简单、零额外延迟,但可能丢失长期上下文;摘要紧凑保留长期记忆,但可能引入摘要偏差和延迟。选择取决于任务独立性、可预测性需求和长期记忆重要性。
架构分析
系统基于OpenAI Agents SDK,核心组件包括Agent、Runner和Session。Session实现SessionABC接口,提供get_items、add_items等方法。TrimmingSession使用deque存储消息,通过_max_turns控制保留轮次,在写入和读取时自动修剪。SummarizingSession在超过context_limit时,将早期内容通过LLMSummarizer生成摘要,并注入合成用户-助手消息对。设计上使用异步锁保证并发安全,摘要期间释放锁并重新检查条件,确保幂等性。
完整实战教程
上下文工程 - 利用会话进行短期记忆管理
在人工智能领域,上下文工程(Context Engineering)是优化模型性能的关键技术之一。它涉及如何有效地管理和利用输入给模型的信息,以确保模型能够生成准确、相关的响应。其中,短期记忆管理尤为重要,因为它直接影响模型在对话或任务中的连贯性和准确性。本文将重点介绍如何通过会话(Sessions)来实现短期记忆的有效管理。
什么是上下文工程?
上下文工程是指设计和优化AI模型输入上下文的过程。这包括选择、组织和呈现信息,以引导模型产生期望的输出。在大型语言模型(LLM)中,上下文窗口(Context Window)是模型可以处理的输入长度限制。因此,如何在这个有限的空间内最大化信息的效用,是上下文工程的核心挑战。
短期记忆与会话
短期记忆在AI中通常指模型在单次交互或短时间内保留的信息。会话(Session)是一种管理短期记忆的机制,它允许模型在多次交互中保持状态。通过会话,我们可以将对话历史、用户偏好或任务状态等信息存储起来,并在后续交互中引用。
会话的作用
- 保持连贯性:会话使得模型能够记住之前的对话内容,从而在后续回答中保持一致性。
- 减少重复:通过会话,用户无需重复提供相同的信息,提高了交互效率。
- 个性化体验:会话可以存储用户的历史行为,使模型能够提供更个性化的响应。
如何设计有效的会话
设计有效的会话需要考虑以下几个方面:
1. 会话结构
会话应该有一个清晰的结构,通常包括会话ID、消息列表和元数据。消息列表按时间顺序存储,每条消息包含角色(如用户或助手)和内容。
2. 上下文长度管理
由于上下文窗口有限,我们需要管理会话中的信息量。常见策略包括:
- 截断:当会话过长时,删除最早的消息。
- 摘要:将早期对话总结为简短摘要,保留关键信息。
- 关键信息提取:只保留与当前任务相关的信息。
3. 会话持久化
会话可以存储在内存中,也可以持久化到数据库。持久化允许跨请求恢复会话,但需要考虑存储成本和隐私问题。
最佳实践
- 明确会话目标:在设计会话时,明确其用途,避免存储无关信息。
- 定期清理:定期清理过期或无效的会话,释放资源。
- 安全与隐私:确保会话数据的安全,避免敏感信息泄露。
会话与长期记忆
短期记忆(会话)和长期记忆(如向量数据库)可以协同工作。短期记忆提供即时上下文,而长期记忆提供持久的知识。例如,在客服机器人中,会话可以存储当前对话的上下文,而长期记忆可以存储用户的历史订单信息。
结论
会话是管理短期记忆的有效工具,它能够提升AI应用的连贯性和用户体验。通过合理设计会话结构、管理上下文长度,并遵循最佳实践,我们可以充分发挥上下文工程的潜力。随着AI技术的不断发展,会话管理将成为构建智能应用的重要基石。
AI 代理通常运行在长时间、多轮交互中,保持上下文的正确平衡至关重要。如果携带过多信息,模型可能会分心、效率低下,甚至完全失败。如果保留太少,代理则会失去连贯性。
这里的上下文指的是模型一次可以关注的令牌总数(输入 + 输出)。对于 GPT-5,这一容量高达 272k 输入令牌和 128k 输出令牌,但即使如此大的窗口也可能被未整理的历史记录、冗余的工具结果或嘈杂的检索所淹没。这使得上下文管理不仅是一种优化,更是一种必要。
在本教程中,我们将探讨如何使用 OpenAI Agents SDK 中的 Session 对象有效管理上下文,重点介绍两种经过验证的上下文管理技术——修剪和压缩——以保持代理快速、可靠且经济高效。
为什么上下文管理很重要
* 在长线程中保持连贯性 – 让代理锚定在最新的用户目标上,而不拖累过时的细节。会话级别的修剪和摘要可以防止“昨天的计划”覆盖今天的请求。
* 提高工具调用准确性 – 聚焦的上下文可以改善函数选择和参数填充,减少多工具运行中的重试、超时和级联故障。
* 降低延迟和成本 – 更小、更精炼的提示减少了每轮令牌数和注意力负载。
* 遏制错误和幻觉 – 摘要充当“洁净室”,纠正或省略先前的错误;修剪避免逐轮放大错误事实(“上下文中毒”)。
* 简化调试和可观测性 – 稳定的摘要和有界的历史记录使日志具有可比性:你可以比较摘要、归因回归并可靠地重现失败。
* 多问题和交接的韧性 – 在多问题聊天中,每个问题的迷你摘要让代理可以暂停/恢复、升级给人类或移交给另一个代理,同时保持一致。
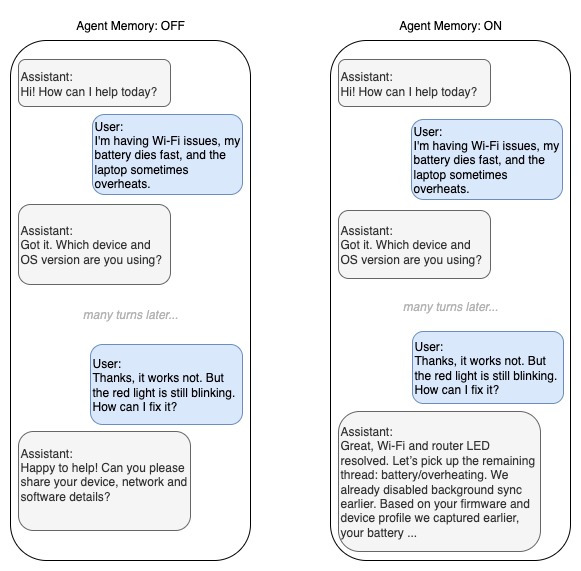
OpenAI Responses API 通过内置状态和 previous_response_id 消息链提供了基本记忆支持。
你可以通过将先前响应的 id 作为 previous_response_id 传递来继续对话,或者通过将输出收集到列表中并作为下一次响应的 input 重新提交来手动管理上下文。
你无法获得的是自动记忆管理。这正是 Agents SDK 的用武之地。它在 Responses 之上提供了会话记忆,因此你不再需要手动追加 response.output 或自己跟踪 ID。会话成为记忆对象:你反复调用 Runner.run(agent, "...", session=session),SDK 会处理上下文长度、历史和连续性——从而更容易构建连贯的多轮代理。
实际场景
我们将通过一个常见的长时间运行任务的实用示例来具体说明这些技术,例如:
* 多轮客户服务对话
在关于科技产品(涵盖硬件和软件)的长时间对话中,客户经常会提出多个问题。代理必须保持一致性并专注于目标,同时只保留关键信息,而不是携带所有过去的细节。
涵盖的技术
为了解决这些挑战,我们使用 OpenAI Agents SDK 介绍两种独立的、具体的方法:
- 上下文修剪 – 丢弃较早的轮次,同时保留最后 N 轮。
- 优点
* 确定且简单: 没有摘要器的可变性;易于推理状态并重现运行。
* 零额外延迟: 无需额外的模型调用来压缩历史记录。
* 近期工作的保真度: 最新的工具结果、参数和边缘情况保持原样——非常适合调试。
* 降低“摘要漂移”风险: 你永远不会重新解释或压缩事实。
缺点
* 突然遗忘长期上下文: 一旦超出 N 轮,重要的早期约束、ID 或决策可能会消失。
* 用户体验“失忆”: 在长时间会话中,代理可能看起来“忘记”了承诺或先前的偏好。
* 浪费信号: 较早的轮次可能包含可复用的知识(需求、约束),这些知识会被丢弃。
* 仍然可能出现令牌峰值: 如果最近的轮次包含巨大的工具负载,你的最后 N 轮仍然可能使上下文爆炸。
- 最佳适用场景
- 对话中的任务彼此独立,上下文不重叠,不需要携带先前的细节。
- 你需要可预测性、易于评估和低延迟(运维自动化、CRM/API 操作)。
- 对话的有用上下文是局部的(最近的步骤比遥远的历史重要得多)。
- 上下文摘要 – 将先前的消息(助手、用户、工具等)压缩成结构化的、较短的摘要,并注入到对话历史中。
- 优点
* 紧凑地保留长期记忆: 过去的需求、决策和理由可以超越 N 轮持续存在。
* 更流畅的用户体验: 代理在长时间会话中“记住”承诺和约束。
* 成本可控的规模: 一个简洁的摘要可以替代数百轮对话。
* 可搜索的锚点: 一条合成的助手消息成为稳定的“迄今为止的世界状态”。
缺点
* 摘要损失与偏差: 细节可能被丢弃或权重错误;微妙的约束可能消失。
* 延迟和成本峰值: 每次刷新都会增加模型工作(以及可能的工具修剪逻辑)。
* 复合错误: 如果错误的事实进入摘要,它可能毒害未来的行为(“上下文中毒”)。
* 可观测性复杂性: 你必须记录摘要提示/输出,以便审计和评估。
- 最佳适用场景
- 你的用例需要跨流程收集上下文,例如规划/辅导、RAG 密集型分析、政策问答。
- 你需要在长时间范围内保持连续性,并且必须保留重要细节以解决相关任务。
- 会话超过 N 轮,但必须可靠地保留决策、ID 和约束。
快速对比
| 维度 | 裁剪(最近N轮) | 摘要(旧内容 → 生成摘要) |
| ----------------- | ------------------------------- | ------------------------------------ |
| 延迟/成本 | 最低(无额外调用) | 摘要刷新时较高 |
| 长期记忆 | 弱(硬性截断) | 强(紧凑传递) |
| 风险类型 | 上下文丢失 | 上下文扭曲/污染 |
| 可观测性 | 简单日志 | 必须记录摘要提示/输出 |
| 评估稳定性 | 高 | 需要稳健的摘要评估 |
| 最适合 | 工具密集型操作、短工作流 | 分析师/客服、长线程 |
先决条件
在运行本教程之前,您必须设置以下账户并完成一些准备工作。这些先决条件对于与本项目中使用的 API 进行交互至关重要。
步骤0:OpenAI 账户和 OPENAI_API_KEY
- 目的:
您需要一个 OpenAI 账户才能访问语言模型并使用本教程中介绍的 Agents SDK。
- 操作:
如果您还没有账户,请注册 OpenAI 账户。拥有账户后,请访问 OpenAI API 密钥页面 创建 API 密钥。
在运行工作流之前,请设置你的环境变量:
# Your openai key
os.environ["OPENAI_API_KEY"] = "sk-proj-..."
或者,您可以通过导入 agents 库,使用 set_default_openai_key 函数为代理设置默认的 OpenAI API 密钥。
from agents import set_default_openai_key
set_default_openai_key("YOUR_API_KEY")
第一步:安装所需库
下面我们安装 openai-agents 库(OpenAI Agents SDK)。
%pip install openai-agents nest_asyncio
from openai import OpenAI

client = OpenAI()
from agents import set_tracing_disabled
set_tracing_disabled(True)
让我们通过定义并运行一个智能体来测试已安装的库。
import asyncio
from agents import Agent, Runner


agent = Agent(
    name="Assistant",
    instructions="Reply very concisely.",
)

result = await Runner.run(agent, "Tell me why it is important to evaluate AI agents.")
print(result.final_output)
定义智能体
我们首先从 Agents SDK 库中定义必要的组件。在创建智能体时,会根据具体用例添加相应的指令。
客户服务代理
support_agent = Agent(
    name="Customer Support Assistant",
    model="gpt-5",
    instructions=(
        "You are a patient, step-by-step IT support assistant. "
        "Your role is to help customers troubleshoot and resolve issues with devices and software. "
        "Guidelines:\n"
        "- Be concise and use numbered steps where possible.\n"
        "- Ask only one focused, clarifying question at a time before suggesting next actions.\n"
        "- Track and remember multiple issues across the conversation; update your understanding as new problems emerge.\n"
        "- When a problem is resolved, briefly confirm closure before moving to the next.\n"
    )
)
上下文裁剪
实现自定义会话对象
我们正在使用 OpenAI Agents Python SDK 中的 Session 对象。下面是一个 TrimmingSession 实现,它只保留最后 N 轮(“一轮” = 一条用户消息以及直到下一条用户消息之前的所有内容——包括助手回复和任何工具调用/结果)。它是内存中的,并在每次写入和读取时自动修剪。
from __future__ import annotations

import asyncio
from collections import deque
from typing import Any, Deque, Dict, List, cast

from agents.memory.session import SessionABC
from agents.items import TResponseInputItem  # dict-like item

ROLE_USER = "user"


def _is_user_msg(item: TResponseInputItem) -> bool:
    """Return True if the item represents a user message."""
    # Common dict-shaped messages
    if isinstance(item, dict):
        role = item.get("role")
        if role is not None:
            return role == ROLE_USER
        # Some SDKs: {"type": "message", "role": "..."}
        if item.get("type") == "message":
            return item.get("role") == ROLE_USER
    # Fallback: objects with a .role attr
    return getattr(item, "role", None) == ROLE_USER


class TrimmingSession(SessionABC):
    """
    Keep only the last N *user turns* in memory.

    A turn = a user message and all subsequent items (assistant/tool calls/results)
    up to (but not including) the next user message.
    """

    def __init__(self, session_id: str, max_turns: int = 8):
        self.session_id = session_id
        self.max_turns = max(1, int(max_turns))
        self._items: Deque[TResponseInputItem] = deque()  # chronological log
        self._lock = asyncio.Lock()

    # ---- SessionABC API ----

    async def get_items(self, limit: int | None = None) -> List[TResponseInputItem]:
        """Return history trimmed to the last N user turns (optionally limited to most-recent `limit` items)."""
        async with self._lock:
            trimmed = self._trim_to_last_turns(list(self._items))
            return trimmed[-limit:] if (limit is not None and limit >= 0) else trimmed

    async def add_items(self, items: List[TResponseInputItem]) -> None:
        """Append new items, then trim to last N user turns."""
        if not items:
            return
        async with self._lock:
            self._items.extend(items)
            trimmed = self._trim_to_last_turns(list(self._items))
            self._items.clear()
            self._items.extend(trimmed)

    async def pop_item(self) -> TResponseInputItem | None:
        """Remove and return the most recent item (post-trim)."""
        async with self._lock:
            return self._items.pop() if self._items else None

    async def clear_session(self) -> None:
        """Remove all items for this session."""
        async with self._lock:
            self._items.clear()

    # ---- Helpers ----

    def _trim_to_last_turns(self, items: List[TResponseInputItem]) -> List[TResponseInputItem]:
        """
        Keep only the suffix containing the last `max_turns` user messages and everything after
        the earliest of those user messages.

        If there are fewer than `max_turns` user messages (or none), keep all items.
        """
        if not items:
            return items

        count = 0
        start_idx = 0  # default: keep all if we never reach max_turns

        # Walk backward; when we hit the Nth user message, mark its index.
        for i in range(len(items) - 1, -1, -1):
            if _is_user_msg(items[i]):
                count += 1
                if count == self.max_turns:
                    start_idx = i
                    break

        return items[start_idx:]

    # ---- Optional convenience API ----

    async def set_max_turns(self, max_turns: int) -> None:
        async with self._lock:
            self.max_turns = max(1, int(max_turns))
            trimmed = self._trim_to_last_turns(list(self._items))
            self._items.clear()
            self._items.extend(trimmed)

    async def raw_items(self) -> List[TResponseInputItem]:
        """Return the untrimmed in-memory log (for debugging)."""
        async with self._lock:
            return list(self._items)
让我们定义我们实现的自定义会话对象,其中 max_turns=3。
# Keep only the last 8 turns (user + assistant/tool interactions)
session = TrimmingSession("my_session", max_turns=3)
如何选择合适的 max_turns?
确定这个参数通常需要根据你的对话历史进行实验。一种方法是提取所有对话的总轮数并分析其分布。另一种选择是使用 LLM 评估对话——识别每个对话包含多少任务或问题,并计算每个问题所需的平均轮数。
message = "There is a red light blinking on my laptop."
result = await Runner.run(
    support_agent,
    message,
    session=session
)
history = await session.get_items()
history
# Example flow
await session.add_items([{"role": "user", "content": "I am using a macbook pro and it has some overheating issues too."}])
await session.add_items([{"role": "assistant", "content": "I see. Let's check your firmware version."}])
await session.add_items([{"role": "user", "content": "Firmware v1.0.3; still failing."}])
await session.add_items([{"role": "assistant", "content": "Could you please try a factory reset?"}])
await session.add_items([{"role": "user", "content": "Reset done; error 42 now."}])
await session.add_items([{"role": "assistant", "content": "Leave it on charge for 30 minutes in case the battery is critically low. Is there any other error message?"}])
await session.add_items([{"role": "user", "content": "Yes, I see error 404 now."}])
await session.add_items([{"role": "assistant", "content": "Do you see it on the browser while accessing a website?"}])
# At this point, with max_turns=3, everything *before* the earliest of the last 3 user
# messages is summarized into a synthetic pair, and the last 3 turns remain verbatim.

history = await session.get_items()
# Pass `history` into your agent runner / responses call as the conversation context.
len(history)
history
下面你可以看到 max_turns=3 时修剪会话的工作方式。
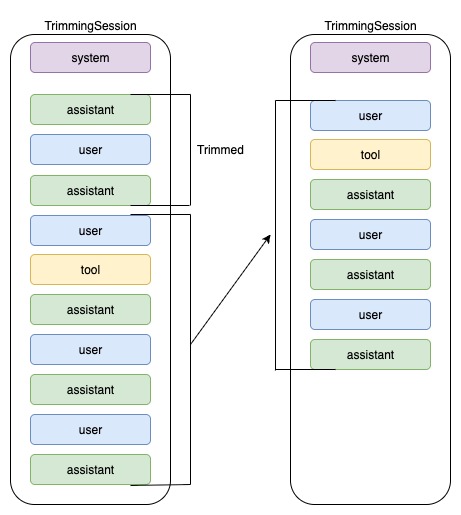
什么算作一个“轮次”
* 轮次 = 一条用户消息加上其后的所有内容(助手回复、推理、工具调用、工具结果)直到下一条用户消息。
何时进行裁剪
* 写入时:add_items(...) 追加新条目,然后立即裁剪存储的历史记录。
* 读取时:get_items(...) 返回裁剪后的视图(因此即使你绕过了写入,读取也不会泄露旧的轮次)。
它如何决定保留什么
- 将任何
role == "user"的条目视为用户消息(通过_is_user_msg)。 - 向后扫描历史记录,并收集最后 N 条用户消息(
max_turns)的索引。 - 在这 N 条用户消息中找到最早的索引。
- 保留从该索引到末尾的所有内容;丢弃其之前的所有内容。
这样就保留了每个完整的轮次边界:如果最早保留的用户消息位于索引 k,那么你也会保留 k 之后的所有助手/工具条目。
小示例
历史记录(旧 → 新):
0: user("Hi")
1: assistant("Hello!")
2: tool_call("lookup")
3: tool_result("…")
4: user("It didn't work")
5: assistant("Try rebooting")
6: user("Rebooted, now error 42")
7: assistant("On it")
使用 max_turns = 2 时,最后两条用户消息位于索引 4 和 6。
其中最早的是 4 → 保留项目 4..7,丢弃 0..3。
为什么这样效果好
* 你总是保留 完整的 轮次,因此助手保留了它需要的直接上下文(用户最后的请求以及中间的助手/工具步骤)。
* 它通过整体丢弃较旧的轮次(而不仅仅是消息)来防止上下文膨胀。
自定义选项
* 在初始化时更改 max_turns。
* 如果你的项目模式不同,调整 _is_user_msg(...)。
* 如果你更希望按 消息数量 或 令牌数 限制,替换 _trim_to_last_turns(...) 或添加一个测量令牌的第二遍处理。
上下文摘要
一旦历史记录超过 max_turns,它会保留最近的 N 个用户轮次不变,将更早的所有内容总结为两条合成消息:
* user: *“总结我们到目前为止的对话。”*
* assistant: *{生成的摘要}*
来自用户的影子提示用于请求总结,以保持对话的自然流畅,而不会混淆用户和助手之间的聊天流程。生成的摘要的最终版本被注入到助手消息中。
摘要提示词
精心设计的摘要提示词对于保留对话上下文至关重要,并且应始终针对特定用例进行定制。可以将其想象为客服人员将案例交接给下一位客服人员。他们需要哪些简洁而关键的信息才能顺利继续?提示词应达到适当的平衡:既不过度加载不必要的信息,也不至于过于稀疏而丢失关键上下文。实现这种平衡需要精心设计,并通过持续实验来微调细节程度。
SUMMARY_PROMPT = """
You are a senior customer-support assistant for tech devices, setup, and software issues.
Compress the earlier conversation into a precise, reusable snapshot for future turns.

Before you write (do this silently):
- Contradiction check: compare user claims with system instructions and tool definitions/logs; note any conflicts or reversals.
- Temporal ordering: sort key events by time; the most recent update wins. If timestamps exist, keep them.
- Hallucination control: if any fact is uncertain/not stated, mark it as UNVERIFIED rather than guessing.

Write a structured, factual summary ≤ 200 words using the sections below (use the exact headings):

• Product & Environment:
  - Device/model, OS/app versions, network/context if mentioned.

• Reported Issue:
  - Single-sentence problem statement (latest state).

• Steps Tried & Results:
  - Chronological bullets (include tool calls + outcomes, errors, codes).

• Identifiers:
  - Ticket #, device serial/model, account/email (only if provided).

• Timeline Milestones:
  - Key events with timestamps or relative order (e.g., 10:32 install → 10:41 error).

• Tool Performance Insights:
  - What tool calls worked/failed and why (if evident).

• Current Status & Blockers:
  - What’s resolved vs pending; explicit blockers preventing progress.

• Next Recommended Step:
  - One concrete action (or two alternatives) aligned with policies/tools.

Rules:
- Be concise, no fluff; use short bullets, verbs first.
- Do not invent new facts; quote error strings/codes exactly when available.
- If previous info was superseded, note “Superseded:” and omit details unless critical.
"""
设计记忆摘要提示词的关键原则
* 里程碑: 突出对话中的重要事件——例如,问题解决时、发现有价值的信息时,或已收集所有必要细节时。
* 用例特定性: 根据具体用例调整压缩提示词。思考人类在解决相同任务时如何在工作记忆中跟踪和回忆信息。
* 矛盾检查: 确保摘要不与自身、系统指令或工具定义冲突。这对于推理模型尤其重要,因为它们在上下文中更容易发生冲突。
* 时间戳与时间流: 在摘要中包含事件的时间。这有助于模型按顺序推理更新,并减少在时间线上忘记或记住最新记忆时的混淆。
* 分块: 将细节组织成类别或部分,而不是长段落。结构化分组能提高LLM理解信息之间关系的能力。
* 工具性能洞察: 从多轮、工具支持的交互中捕获经验教训——例如,记录哪些工具对特定查询有效以及原因。这些洞察对指导后续步骤很有价值。
* 指导与示例: 用清晰的指导来引导摘要。尽可能从对话历史中提取具体示例,使未来的轮次更加扎实和上下文丰富。
* 幻觉控制: 精确控制包含的内容。摘要中即使是轻微的幻觉也可能向前传播,用不准确的信息污染未来的上下文。
* 模型选择: 根据用例需求、摘要长度以及延迟和成本之间的权衡来选择摘要模型。在某些情况下,使用与AI代理相同的模型可能是有利的。
class LLMSummarizer:
    def __init__(self, client, model="gpt-4o", max_tokens=400, tool_trim_limit=600):
        self.client = client
        self.model = model
        self.max_tokens = max_tokens
        self.tool_trim_limit = tool_trim_limit

    async def summarize(self, messages: List[Item]) -> Tuple[str, str]:
        """
        Create a compact summary from `messages`.

        Returns:
            Tuple[str, str]: The shadow user line to keep dialog natural,
            and the model-generated summary text.
        """
        user_shadow = "Summarize the conversation we had so far."
        TOOL_ROLES = {"tool", "tool_result"}

        def to_snippet(m: Item) -> str | None:
            role = (m.get("role") or "assistant").lower()
            content = (m.get("content") or "").strip()
            if not content:
                return None
            # Trim verbose tool outputs to keep prompt compact
            if role in TOOL_ROLES and len(content) > self.tool_trim_limit:
                content = content[: self.tool_trim_limit] + " …"
            return f"{role.upper()}: {content}"

        # Build compact, trimmed history
        history_snippets = [s for m in messages if (s := to_snippet(m))]

        prompt_messages = [
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": "\n".join(history_snippets)},
        ]

        resp = await asyncio.to_thread(
            self.client.responses.create,
            model=self.model,
            input=prompt_messages,
            max_output_tokens=self.max_tokens,
        )

        summary = resp.output_text
        await asyncio.sleep(0)  # yield control
        return user_shadow, summary
import asyncio
from collections import deque
from typing import Optional, List, Tuple, Dict, Any

Record = Dict[str, Dict[str, Any]]  # {"msg": {...}, "meta": {...}}

class SummarizingSession:
    """
    Session that keeps only the last N *user turns* verbatim and summarizes the rest.

    - A *turn* starts at a real user message and includes everything until the next real user message.
    - When the number of real user turns exceeds `context_limit`, everything before the earliest
      of the last `keep_last_n_turns` user-turn starts is summarized into a synthetic user→assistant pair.
    - Stores full records (message + metadata). Exposes:
        • get_items():           model-safe messages only (no metadata)
        • get_full_history():    [{"message": msg, "metadata": meta}, ...]
    """

    # Only these keys are ever sent to the model; the rest live in metadata.
    _ALLOWED_MSG_KEYS = {"role", "content", "name"}

    def __init__(
        self,
        keep_last_n_turns: int = 3,
        context_limit: int = 3,
        summarizer: Optional["Summarizer"] = None,
        session_id: Optional[str] = None,
    ):
        assert context_limit >= 1
        assert keep_last_n_turns >= 0
        assert keep_last_n_turns <= context_limit, "keep_last_n_turns should not be greater than context_limit"

        self.keep_last_n_turns = keep_last_n_turns
        self.context_limit = context_limit
        self.summarizer = summarizer
        self.session_id = session_id or "default"

        self._records: deque[Record] = deque()
        self._lock = asyncio.Lock()

    # --------- public API used by your runner ---------
    async def get_items(self, limit: Optional[int] = None) -> List[Dict[str, Any]]:
        """Return model-safe messages only (no metadata)."""
        async with self._lock:
            data = list(self._records)
        msgs = [self._sanitize_for_model(rec["msg"]) for rec in data]
        return msgs[-limit:] if limit else msgs

    async def add_items(self, items: List[Dict[str, Any]]) -> None:
        """Append new items and, if needed, summarize older turns."""
        # 1) Ingest items
        async with self._lock:
            for it in items:
                msg, meta = self._split_msg_and_meta(it)
                self._records.append({"msg": msg, "meta": meta})

            need_summary, boundary = self._summarize_decision_locked()

        # 2) No summarization needed → just normalize flags and exit
        if not need_summary:
            async with self._lock:
                self._normalize_synthetic_flags_locked()
            return

        # 3) Prepare summary prefix (model-safe copy) outside the lock
        async with self._lock:
            snapshot = list(self._records)
            prefix_msgs = [r["msg"] for r in snapshot[:boundary]]

        user_shadow, assistant_summary = await self._summarize(prefix_msgs)

        # 4) Re-check and apply summary atomically
        async with self._lock:
            still_need, new_boundary = self._summarize_decision_locked()
            if not still_need:
                self._normalize_synthetic_flags_locked()
                return

            snapshot = list(self._records)
            suffix = snapshot[new_boundary:]  # keep-last-N turns live here

            # Replace with: synthetic pair + suffix
            self._records.clear()
            self._records.extend([
                {
                    "msg": {"role": "user", "content": user_shadow},
                    "meta": {
                        "synthetic": True,
                        "kind": "history_summary_prompt",
                        "summary_for_turns": f"< all before idx {new_boundary} >",
                    },
                },
                {
                    "msg": {"role": "assistant", "content": assistant_summary},
                    "meta": {
                        "synthetic": True,
                        "kind": "history_summary",
                        "summary_for_turns": f"< all before idx {new_boundary} >",
                    },
                },
            ])
            self._records.extend(suffix)

            # Ensure all real user/assistant messages explicitly have synthetic=False
            self._normalize_synthetic_flags_locked()

    async def pop_item(self) -> Optional[Dict[str, Any]]:
        """Pop the latest message (model-safe), if any."""
        async with self._lock:
            if not self._records:
                return None
            rec = self._records.pop()
            return dict(rec["msg"])

    async def clear_session(self) -> None:
        """Remove all records."""
        async with self._lock:
            self._records.clear()

    def set_max_turns(self, n: int) -> None:
        """
        Back-compat shim for old callers: update `context_limit`
        and clamp `keep_last_n_turns` if needed.
        """
        assert n >= 1
        self.context_limit = n
        if self.keep_last_n_turns > self.context_limit:
            self.keep_last_n_turns = self.context_limit

    # Full history (debugging/analytics/observability)

    async def get_full_history(self, limit: Optional[int] = None) -> List[Dict[str, Any]]:
        """
        Return combined history entries in the shape:
          {"message": {role, content[, name]}, "metadata": {...}}
        This is NOT sent to the model; for logs/UI/debugging only.
        """
        async with self._lock:
            data = list(self._records)
        out = [{"message": dict(rec["msg"]), "metadata": dict(rec["meta"])} for rec in data]
        return out[-limit:] if limit else out

    # Back-compat alias
    async def get_items_with_metadata(self, limit: Optional[int] = None) -> List[Dict[str, Any]]:
        return await self.get_full_history(limit)

    # Internals

    def _split_msg_and_meta(self, it: Dict[str, Any]) -> Tuple[Dict[str, Any], Dict[str, Any]]:
        """
        Split input into (msg, meta):
          - msg keeps only _ALLOWED_MSG_KEYS; if role/content missing, default them.
          - everything else goes under meta (including nested "metadata" if provided).
          - default synthetic=False for real user/assistant unless explicitly set.
        """
        msg = {k: v for k, v in it.items() if k in self._ALLOWED_MSG_KEYS}
        extra = {k: v for k, v in it.items() if k not in self._ALLOWED_MSG_KEYS}
        meta = dict(extra.pop("metadata", {}))
        meta.update(extra)

        msg.setdefault("role", "user")
        msg.setdefault("content", str(it))

        role = msg.get("role")
        if role in ("user", "assistant") and "synthetic" not in meta:
            meta["synthetic"] = False
        return msg, meta

    @staticmethod
    def _sanitize_for_model(msg: Dict[str, Any]) -> Dict[str, Any]:
        """Drop anything not allowed in model calls."""
        return {k: v for k, v in msg.items() if k in SummarizingSession._ALLOWED_MSG_KEYS}

    @staticmethod
    def _is_real_user_turn_start(rec: Record) -> bool:
        """True if record starts a *real* user turn (role=='user' and not synthetic)."""
        return (
            rec["msg"].get("role") == "user"
            and not rec["meta"].get("synthetic", False)
        )

    def _summarize_decision_locked(self) -> Tuple[bool, int]:
        """
        Decide whether to summarize and compute the boundary index.

        Returns:
            (need_summary, boundary_idx)

        If need_summary:
          • boundary_idx is the earliest index among the last `keep_last_n_turns`
            *real* user-turn starts.
          • Everything before boundary_idx becomes the summary prefix.
        """
        user_starts: List[int] = [
            i for i, rec in enumerate(self._records) if self._is_real_user_turn_start(rec)
        ]
        real_turns = len(user_starts)

        # Not over the limit → nothing to do
        if real_turns <= self.context_limit:
            return False, -1

        # Keep zero turns verbatim → summarize everything
        if self.keep_last_n_turns == 0:
            return True, len(self._records)

        # Otherwise, keep the last N turns; summarize everything before the earliest of those
        if len(user_starts) < self.keep_last_n_turns:
            return False, -1  # defensive (shouldn't happen given the earlier check)

        boundary = user_starts[-self.keep_last_n_turns]

        # If there is nothing before boundary, there is nothing to summarize
        if boundary <= 0:
            return False, -1

        return True, boundary

    def _normalize_synthetic_flags_locked(self) -> None:
        """Ensure all real user/assistant records explicitly carry synthetic=False."""
        for rec in self._records:
            role = rec["msg"].get("role")
            if role in ("user", "assistant") and "synthetic" not in rec["meta"]:
                rec["meta"]["synthetic"] = False

    async def _summarize(self, prefix_msgs: List[Dict[str, Any]]) -> Tuple[str, str]:
        """
        Ask the configured summarizer to compress the given prefix.
        Uses model-safe messages only. If no summarizer is configured,
        returns a graceful fallback.
        """
        if not self.summarizer:
            return ("Summarize the conversation we had so far.", "Summary unavailable.")
        clean_prefix = [self._sanitize_for_model(m) for m in prefix_msgs]
        return await self.summarizer.summarize(clean_prefix)
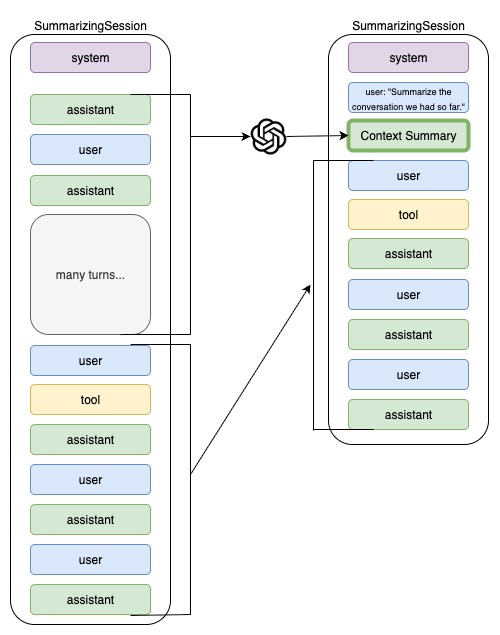
高层思路
* 一个回合 = 一条真实用户消息及其后所有内容(助手回复、工具调用/结果等)直到下一条真实用户消息。
* 你配置两个旋钮:
* context_limit:在总结之前,原始历史中允许的真实用户回合的最大数量。
* keep_last_n_turns:当进行总结时,保留最近多少个回合的原文。
* 不变式:keep_last_n_turns <= context_limit。
* 当真实用户回合数超过 context_limit 时,会话将:
- 总结在最后
keep_last_n_turns回合开始之前的所有内容, - 在保留区域顶部注入一个合成的用户→助手对:
* user:"Summarize the conversation we had so far."(影子提示)
* assistant:{生成的总结}
- 保留最后
keep_last_n_turns回合的原文。
这保证了最后 keep_last_n_turns 回合被精确保留,而所有更早的内容被压缩为两条合成消息。
session = SummarizingSession(
    keep_last_n_turns=2,
    context_limit=4,
    summarizer=LLMSummarizer(client)
)
# Example flow
await session.add_items([{"role": "user", "content": "Hi, my router won't connect. by the way, I am using Windows 10. I tried troubleshooting via your FAQs but I didn't get anywhere. This is my third tiem calling you. I am based in the US and one of Premium customers."}])
await session.add_items([{"role": "assistant", "content": "Let's check your firmware version."}])
await session.add_items([{"role": "user", "content": "Firmware v1.0.3; still failing."}])
await session.add_items([{"role": "assistant", "content": "Try a factory reset."}])
await session.add_items([{"role": "user", "content": "Reset done; error 42 now."}])
await session.add_items([{"role": "assistant", "content": "Try to install a new firmware."}])
await session.add_items([{"role": "user", "content": "I tried but I got another error now."}])
await session.add_items([{"role": "assistant", "content": "Can you please provide me with the error code?"}])
await session.add_items([{"role": "user", "content": "It says 404 not found when I try to access the page."}])
await session.add_items([{"role": "assistant", "content": "Are you connected to the internet?"}])
# At this point, with context_limit=4, everything *before* the earliest of the last 4 turns
# is summarized into a synthetic pair, and the last 2 turns remain verbatim.
history = await session.get_items()
# Pass `history` into your agent runner / responses call as the conversation context.
history
print(history[1]['content'])
你可以使用 get_items_with_metadata 方法获取会话的完整历史记录,包括用于调试和分析的元数据。
full_history = await session.get_items_with_metadata()
full_history
print(history[1]['content'])
注意事项与设计选择
* 在“新”侧保留轮次边界:keep_last_n_turns 用户轮次保持原样;更早的内容被压缩。
* 两条消息的摘要块:便于下游工具检测或显示(metadata.synthetic == True)。
* 异步与锁纪律:在(可能较慢的)摘要运行时释放锁;然后在应用摘要前重新检查条件,以避免竞争性合并。
* 幂等行为:如果在摘要期间有更多消息到达,await 后的重新检查可防止过时的重写。
评估
归根结底,评估才是上下文工程所需的一切。关键问题是:*我们如何知道模型没有“丢失上下文”或“混淆上下文”?*
虽然未来可能会有一本关于记忆的完整手册,但这里有一些轻量级评估框架的想法供你参考:
* 基线与增量: 继续运行你的核心评估集,并比较实验前后的结果,以衡量记忆改进的效果。
* LLM作为裁判: 使用一个带有精心设计的评分提示的模型来评估摘要质量。重点关注它是否以正确的格式捕获了最重要的细节。
* 对话回放: 重新运行长对话,并测量在有和没有上下文修剪的情况下的下一轮准确性。指标可以包括实体/ID的精确匹配以及基于评分标准的推理质量评分。
* 错误回归跟踪: 关注常见的失败模式——未回答的问题、遗漏的约束条件,或不必要的/重复的工具调用。
* 令牌压力检查: 标记令牌限制导致受保护上下文被丢弃的情况。记录前后的令牌数量,以检测关键细节何时被修剪。
3.2 数据预处理
在将数据输入模型之前,需要进行预处理。这包括:
- 清洗:去除无关字符、处理缺失值。
- 标准化:将数据缩放到统一范围,如 [0,1] 或标准化为均值 0、方差 1。
- 增强:对于图像或文本数据,通过旋转、裁剪、同义词替换等方法增加数据多样性。
预处理步骤直接影响模型的性能,因此必须仔细设计。
3.3 模型架构
模型架构是深度学习的核心。常见的架构包括:
- 卷积神经网络(CNN):适用于图像数据,通过卷积层提取局部特征。
- 循环神经网络(RNN):适用于序列数据,如时间序列或文本,通过循环单元捕捉时间依赖。
- Transformer:基于自注意力机制,适用于自然语言处理,能够并行处理序列。
选择架构时,需考虑数据特性、任务类型和计算资源。
3.4 训练与验证
训练过程包括前向传播、损失计算、反向传播和参数更新。验证集用于监控模型泛化能力,防止过拟合。
- 损失函数:衡量预测与真实值的差异,如均方误差(MSE)或交叉熵。
- 优化器:如 SGD、Adam,用于更新参数。
- 正则化:如 Dropout、权重衰减,减少过拟合。
训练时需调整超参数,如学习率、批量大小和训练轮数。
3.5 评估与部署
模型训练完成后,需在测试集上评估性能,使用准确率、精确率、召回率等指标。部署时,需将模型转换为适合生产环境的格式,并考虑推理速度和资源占用。
- --
4. 实践案例
本节通过一个图像分类任务,演示完整的深度学习流程。
4.1 数据准备
使用 CIFAR-10 数据集,包含 10 类彩色图像。加载数据并划分为训练集和测试集。
import tensorflow as tf

(x_train, y_train), (x_test, y_test) = tf.keras.datasets.cifar10.load_data()
4.2 预处理
将像素值归一化到 [0,1],并对标签进行 one-hot 编码。
x_train = x_train.astype('float32') / 255.0
x_test = x_test.astype('float32') / 255.0

y_train = tf.keras.utils.to_categorical(y_train, 10)
y_test = tf.keras.utils.to_categorical(y_test, 10)
4.3 构建模型
使用卷积神经网络,包含卷积层、池化层和全连接层。
model = tf.keras.Sequential([
    tf.keras.layers.Conv2D(32, (3,3), activation='relu', input_shape=(32,32,3)),
    tf.keras.layers.MaxPooling2D((2,2)),
    tf.keras.layers.Conv2D(64, (3,3), activation='relu'),
    tf.keras.layers.MaxPooling2D((2,2)),
    tf.keras.layers.Flatten(),
    tf.keras.layers.Dense(128, activation='relu'),
    tf.keras.layers.Dense(10, activation='softmax')
])
4.4 编译与训练
编译模型,指定优化器、损失函数和评估指标,然后训练。
model.compile(optimizer='adam',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

history = model.fit(x_train, y_train, epochs=10, batch_size=64, validation_split=0.2)
4.5 评估
在测试集上评估模型性能。
test_loss, test_acc = model.evaluate(x_test, y_test)
print(f'Test accuracy: {test_acc}')
- --
5. 总结
本文介绍了深度学习的基本概念、流程和实践案例。深度学习在图像识别、自然语言处理等领域取得了显著成果,但仍有挑战,如数据需求、计算资源和可解释性。未来,深度学习将朝着更高效、更智能的方向发展。
常见问题
常见错误:1) max_turns设置不当导致上下文丢失或冗余,需根据对话分布实验调整。2) 摘要提示词设计不佳导致关键信息丢失,应包含里程碑、矛盾检查、时间戳等。3) 并发写入时未正确使用锁导致数据竞争,需在add_items和get_items中使用异步锁。4) 摘要模型选择不当导致延迟高或质量差,需权衡模型大小和成本。排查方法:使用get_full_history检查元数据,记录摘要提示和输出,进行对话回放和错误回归跟踪。
企业应用扩展
生产环境优化:1) 使用持久化存储(如Redis)保存会话,支持跨请求恢复。2) 定期清理过期会话,释放资源。3) 结合长期记忆(向量数据库)存储用户历史偏好,短期会话提供即时上下文。4) 监控令牌使用和延迟,设置告警。5) 对摘要质量进行持续评估,使用LLM-as-judge或人工抽查。6) 考虑多级摘要策略,根据对话长度动态调整摘要粒度。7) 实现会话版本控制,便于回滚和调试。
总结
本文深入探讨上下文工程中的短期记忆管理,重点介绍如何使用OpenAI Agents SDK的Session对象实现上下文修剪与摘要两种技术。通过实际代码示例,展示如何设计自定义会话类来控制上下文长度,保持对话连贯性,降低延迟和成本,并避免上下文中毒。文章还涵盖评估框架、常见错误排查及生产环境优化建议,帮助开发者构建高效、可靠的AI代理。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:S_CANDIDATE
- 难度:中级
- 验证等级:V1
- 原文作者:emreokcular
- 原文日期:2025-09-09
- 来源许可:MIT
- 来源版本:
a67c435eac66b999f5d1c65d242772b95bf74920 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员