使用Claude托管代理构建数据分析代理
技术背景
在数据驱动决策的背景下,团队中常有人需要快速分析CSV文件并提炼洞察。传统手动分析耗时且易出错,而构建定制化数据分析管道又需要大量基础设施。Claude托管代理提供了一种托管运行时,支持有状态、工具使用的代理,使开发者无需管理底层基础设施即可构建强大的数据分析应用。它解决了环境配置复杂、工具集成繁琐、上下文管理困难等问题,适用于需要快速迭代、可复用分析流程的场景。主要限制包括网络访问需谨慎配置、文件持久化仅限特定目录、以及依赖Anthropic平台。
核心原理
Claude托管代理基于四个核心概念:代理(模型、系统提示、工具、MCP服务器和技能)、环境(容器模板,含包和网络配置)、会话(代理在环境中的实例,执行任务并生成输出)、事件(应用与代理间交换的消息)。代理与环境组合成会话,数据作为资源挂载到会话中,通过发送事件驱动代理执行,并读取事件流监控进度。系统提示词对输出质量至关重要,它指导代理采用叙事结构、以具体数字为依据,并正确嵌入多个plotly图表。工具集提供bash、read、write等八个工具,可配置权限策略。文件持久化通过Files API实现,写入/mnt/session/outputs/的文件可被检索。
架构分析
系统架构分为三层:控制平面(Anthropic API)、执行平面(托管容器)和数据平面(Files API)。控制平面负责创建环境、代理、会话,并发送事件;执行平面运行代理,执行工具调用,生成输出;数据平面管理文件上传、挂载和下载。环境定义容器规格,包括Python包(pandas、plotly)和网络策略(unrestricted或主机允许列表)。代理绑定模型、系统提示和工具集,工具集通过default_config和configs精细控制启用与权限。会话将代理与环境绑定,并通过resources挂载文件到容器路径。事件流提供实时状态更新,包括agent.message、agent.tool_use和session.status_idle等。设计决策包括:将环境与代理分离以实现复用,使用版本化代理确保一致性,通过scope_id隔离文件,以及使用流式API避免阻塞。
完整实战教程
简介
每个团队中都有一个人会拿到一个CSV文件,然后被问到“这里面有什么有趣的?”在本教程中,您将构建一个代理来替他们回答:上传CSV,返回带有交互式图表的叙述性HTML报告。
您将在Claude托管代理上运行它,这是Anthropic为有状态、使用工具的代理提供的托管运行时,基于四个核心概念构建:
- 代理:模型、系统提示、工具、MCP服务器和技能
- 环境:配置好的容器模板(包、网络访问)
- 会话:环境中运行的代理实例,执行特定任务并生成输出
- 事件:您的应用程序与代理之间交换的消息(用户轮次、工具结果、状态更新)
代理加上环境就构成了会话。您将数据作为资源附加到会话中,然后通过发送事件并读取流来驱动它。
Anthropic为您处理沙箱、工具执行和上下文管理。如果您需要完全控制代理循环和部署,请改用Claude Agent SDK。
您将学到什么
完成本教程后,您将能够:
- 为数据分析设置可重用的环境和代理
- 将数据集交给代理处理
- 观察代理运行时的进度
- 下载报告及其生成的其他文件
先决条件
- Python 3.11+
- 来自控制台的Anthropic API密钥,设置为
ANTHROPIC_API_KEY
安装依赖:
%%capture
%pip install -q "anthropic>=0.91.0" python-dotenv
from pathlib import Path

from anthropic import Anthropic
from dotenv import load_dotenv, set_key

load_dotenv()
client = Anthropic()
MODEL = "claude-sonnet-4-6"
1. 创建环境
环境是一个可复用的容器规格。在这里声明 pandas 和 plotly 意味着每个会话都会预装它们,因此代理可以立即开始分析,而不必先运行 pip install。
这里的网络是 unrestricted(不受限制)的,因此代理可以从其 CDN 加载 plotly——但这也会让它访问互联网上的任何地方,因此对于生产环境,请改用主机允许列表。
env = client.beta.environments.create(
    name="cookbook-data-analyst-env",
    config={
        "type": "cloud",
        "networking": {"type": "unrestricted"},
        "packages": {
            "type": "packages",
            "pip": ["pandas", "plotly"],
        },
    },
)
2. 创建代理
代理将模型与系统提示词和一组工具配对。大部分输出质量来自系统提示词;这个提示词强调叙事结构、以具体数字为依据的发现,以及在一个 HTML 文件中嵌入多个 plotly 图表的正确模式。
agent_toolset_20260401 提供了八个工具:bash、read、write、edit、glob、grep、web_fetch 和 web_search。这里它们都在 always_allow 下运行,并且禁用了两个网络工具,因为此分析是离线的。
ANALYST_SYSTEM_PROMPT = """\
You are a senior data analyst producing a publication-quality report.

## Style
- Professional and precise. Let the data speak with concrete numbers.
- Short paragraphs (2-3 sentences) between charts.
- Lead with the most actionable finding.

## Execution
- Write .py scripts and run them with `python3 script.py`.
- Sample large tables (`nrows=` / `.sample()`) instead of loading everything.
- Sanity-check key metrics before building narrative around them.

## Charts
- Build each chart as its own `go.Figure()`, embed with
  `fig.to_html(include_plotlyjs=False, full_html=False)`, and load plotly
  from the CDN once in <head>.
- Always set `marker_color` and `template='simple_white'`.

## Output
Write a single self-contained `report.html` to /mnt/session/outputs/
with inline CSS, 3+ embedded plotly charts, and a closing section of
actionable recommendations. Confirm "Saved: report.html" when done.
"""

agent = client.beta.agents.create(
    name="cookbook-data-analyst",
    model=MODEL,
    system=ANALYST_SYSTEM_PROMPT,
    tools=[
        {
            "type": "agent_toolset_20260401",
            # default_config applies to every tool in the set;
            # entries in configs override specific tools.
            "default_config": {
                "enabled": True,
                "permission_policy": {"type": "always_allow"},
            },
            "configs": [
                {"name": "web_search", "enabled": False},
                {"name": "web_fetch", "enabled": False},
            ],
        }
    ],
)
3. 上传数据集
附带的示例 CSV 有 50 行,因此分析只需几分钟即可完成。在此处替换为任何 CSV(或 CSV 的 zip 文件);流程的其余部分完全相同。
DATA_PATH = Path("example_data/data_analyst_agent/sales_data.csv")

with DATA_PATH.open("rb") as f:
    dataset = client.beta.files.upload(file=(DATA_PATH.name, f, "text/csv"))

print(f"Uploaded {DATA_PATH.name} ({dataset.size_bytes} bytes) as {dataset.id}")
4. 创建会话并发送任务
会话将代理绑定到环境以及任何挂载的文件。传递 {"type": "agent", "id": ..., "version": ...} 会复用你上面创建的版本化代理。resources 将上传的文件挂载到容器内的给定绝对路径。
创建会话后,发送一个带有任务的 user.message 事件。代理将立即开始工作。
MOUNT_PATH = f"/mnt/session/uploads/{DATA_PATH.name}"

session = client.beta.sessions.create(
    environment_id=env.id,
    agent={"type": "agent", "id": agent.id, "version": agent.version},
    resources=[{"type": "file", "file_id": dataset.id, "mount_path": MOUNT_PATH}],
    title="Sales analysis",
)

ANALYSIS_PROMPT = f"""\
Analyze the e-commerce orders in {MOUNT_PATH}.

Columns: order_id, customer_id, product, category, price, quantity,
order_date, region.

Focus on revenue by category and region, repeat-customer behavior, and
one surprising pattern. Produce report.html per your system instructions.
"""

client.beta.sessions.events.send(
    session.id,
    events=[
        {"type": "user.message", "content": [{"type": "text", "text": ANALYSIS_PROMPT}]},
    ],
)
print(f"Session {session.id} running")
5. 流式运行
在 控制台 的 会话 下打开该会话,即可实时查看每个事件、工具调用和令牌计数:
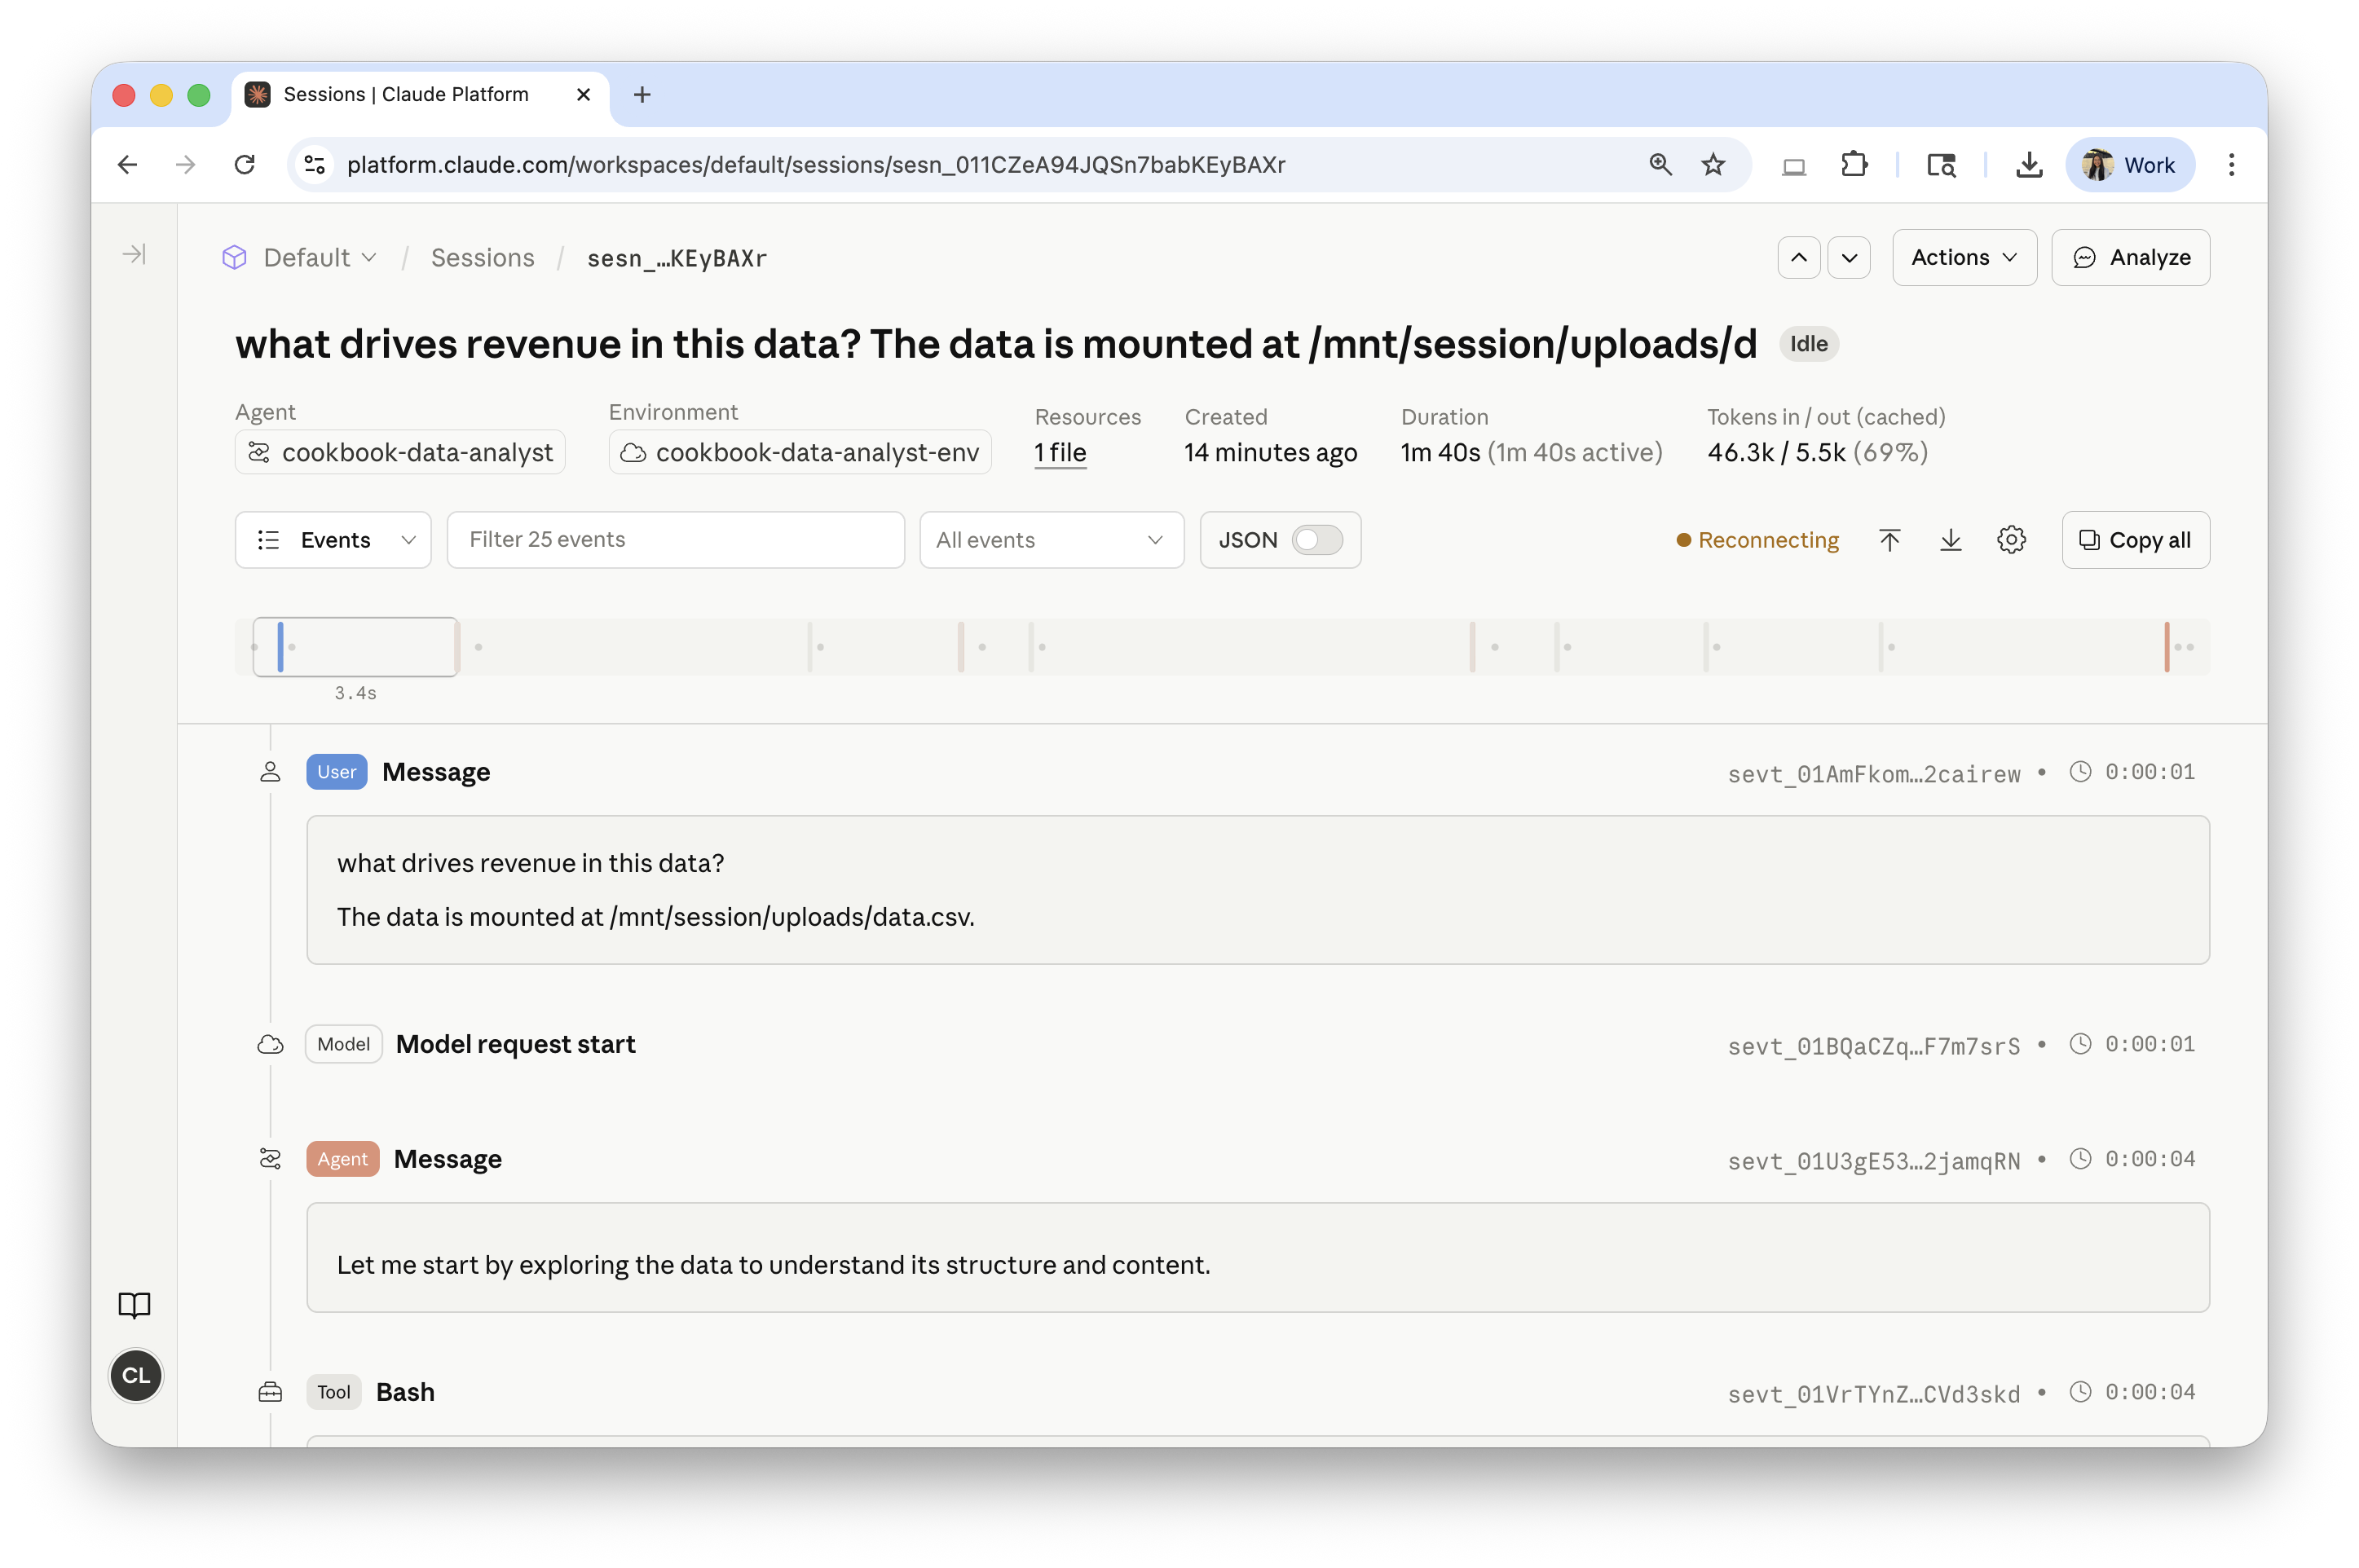 下面的辅助函数会跟踪相同的事件流,在事件到达时打印
agent.message 文本和 agent.tool_use 调用,并在 session.status_idle 时返回。
def wait_for_idle(session_id: str) -> None:
    for ev in client.beta.sessions.events.stream(session_id):
        t = ev.type
        if t == "agent.message":
            for block in ev.content:
                if block.type == "text":
                    text = block.text
                    print(text[:300] + ("..." if len(text) > 300 else ""))
        elif t in ("agent.tool_use", "agent.mcp_tool_use"):
            print(f"  [{ev.name}]")
        elif t == "session.status_idle":
            return
        elif t == "session.status_terminated":
            raise RuntimeError(
                "Session terminated before going idle. "
                f"Trace: https://platform.claude.com/sessions/{session_id}"
            )


wait_for_idle(session.id)
6. 获取报告
代理写入 /mnt/session/outputs/ 的任何内容都会被持久化,并通过 Files API 以 scope_id=<session_id> 的形式呈现。写入容器其他位置的文件不会被持久化。
Files API 是另一个处于测试阶段的功能,因此要在此处使用 scope_id,您还需要传递 Managed Agents 测试版标头。
outputs = client.beta.files.list(scope_id=session.id, betas=["managed-agents-2026-04-01"])
for f in outputs.data:
    print(f.filename, f.size_bytes)

# The list also includes the mounted input CSV; pick out the report.
report = next((f for f in outputs.data if f.filename == "report.html"), None)
if report is None:
    raise RuntimeError(f"report.html not found. Files: {[f.filename for f in outputs.data]}")
content = client.beta.files.download(report.id)
Path("report.html").write_bytes(content.read())
print("Downloaded report.html")
7. 清理与后续步骤
你只需创建一次代理和环境,并在多次运行中复用它们;每次对话则需新建一个会话。现在你已获得报告,请归档此会话以释放其容器。以下代码行将代理和环境 ID 保存到 .env 文件中,以便 slack_data_bot.ipynb 能使用它们启动新会话。
警告: 在运行下一个单元格之前,请确保.env已列入.gitignore中——切勿提交该文件。
client.beta.sessions.archive(session.id)

set_key(".env", "ANALYST_ENV_ID", env.id)
set_key(".env", "ANALYST_AGENT_ID", agent.id)
set_key(".env", "ANALYST_AGENT_VERSION", str(agent.version))
print("Saved ANALYST_ENV_ID, ANALYST_AGENT_ID, ANALYST_AGENT_VERSION to .env")
你已经端到端地构建并运行了一个数据分析代理:一个可复用的环境和代理,一个挂载了 CSV 的会话,一个实时事件流,以及一个下载的 HTML 报告。
接下来:
- 打开下载的
report.html查看叙述和图表。 - 在 Console 中打开会话,检查令牌使用情况和完整事件日志。
- 继续阅读
slack_data_bot.ipynb,从 Slack 驱动此代理。
常见问题
常见错误包括:1) 未设置ANTHROPIC_API_KEY导致认证失败,需确保环境变量正确。2) 网络受限导致plotly CDN加载失败,可改用主机允许列表或预装包。3) 文件未持久化,因为写入非/mnt/session/outputs/路径,需确保输出到正确目录。4) 会话提前终止,可能因工具执行错误或超时,需检查事件流中的错误信息。5) 文件列表包含输入CSV,需过滤出报告文件。排查方法:使用控制台查看会话日志和令牌使用,检查事件流中的异常事件,验证文件挂载路径。生产优化:使用主机允许列表限制网络,设置资源限制,使用版本化代理管理更新,定期归档会话释放资源,监控API调用成本。
企业应用扩展
本教程可扩展为Slack机器人(如slack_data_bot.ipynb),通过Slack命令触发分析。可增加更多工具如数据库连接、自定义MCP服务器。可集成CI/CD管道,自动化报告生成。可添加错误处理与重试机制,优化系统提示词以适应不同数据域。可结合Claude Agent SDK实现完全自定义的代理循环。可扩展文件类型支持(如Excel、JSON),并增加数据可视化模板。可部署为Web服务,提供API接口。
总结
本教程指导开发者使用Anthropic的Claude托管代理构建一个数据分析代理,该代理接收CSV文件并生成包含交互式图表的叙述性HTML报告。教程涵盖环境、代理、会话和事件四个核心概念,详细演示了如何创建可复用的环境与代理、上传数据集、创建会话、流式监控执行过程以及下载报告。通过本教程,读者将掌握托管代理的完整工作流,并了解其架构设计、工具配置、文件持久化机制及生产环境优化建议。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:中级
- 验证等级:V1
- 原文作者:charmaine, jyan-anthropic
- 原文日期:2026-04-08
- 来源许可:MIT
- 来源版本:
37d1c8c8608a7d50066e2748b8bcfe4c67d31ffa - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员