OpenAI Agents API教程:构建AI数据分析师
技术背景
传统 BI 或手写 SQL 调查通常需要多次查询、追问和人工串联上下文,难以在一次会话中完成。Agents API 的价值在于把多轮调查保留在同一会话里,并允许模型调用应用侧工具,而数据库访问权限、可见上下文和可保存修正都由应用决定。该示例借鉴 OpenAI 内部数据代理思路:先基于真实 schema,再提供业务上下文,暴露只读 SQL,并复用团队明确保存的修正。适用场景是内部数据分析问答、指标口径核对和可追溯的临时调查;限制在于结果依赖仓库数据质量,且不附带固定业务数据集。
核心原理
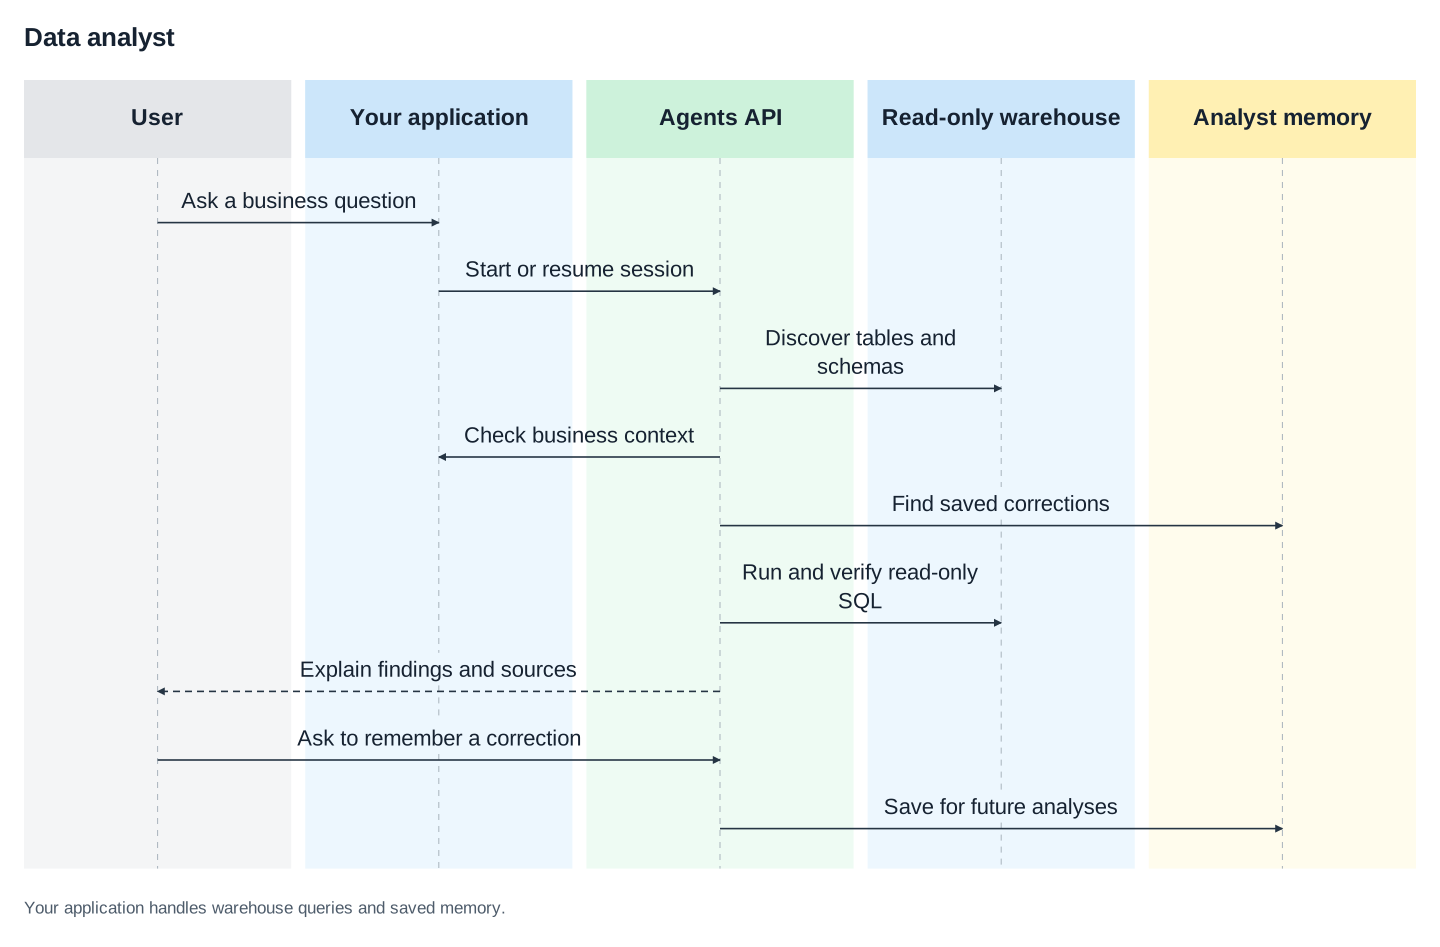
核心原理是会话 + 工具调度循环。应用注册四个工具:search_tables 查找相关表并读取真实列;search_context 检索指标定义、历史查询、文档和已保存修正;query_warehouse 执行只读 SQL 且最多返回 100 行;save_memory 仅在明确请求时写入个人或团队范围备注。save_memory 通过 tool_search 按需发现,程序化工具调用让模型在回答前组合元数据、业务上下文、已保存修正和多个已验证查询。数据流为:创建会话并流式读取事件,遇到 requires_action 时把函数调用分派给 handler,再用 tool_result 回传结果,直到协调器轮次完成。关键设计决策是模型永远拿不到 WAREHOUSE_URL,查询执行留在应用侧,并以只读角色、查询超时和 SQL 展示控制风险。
架构分析
系统分为四层:入口层 main.py 提供 Web 路由、UI 和命令行入口;代理层 agent.py 负责 Agent 配置、工具 schema、调度循环、错误处理和清理;仓库层 warehouse.py 封装只读查询、schema 发现和业务上下文;记忆层 memory.py 将修正持久化到 memories.json。会话历史只保留当前对话,跨会话记忆由应用负责,多用户时应迁移到应用数据库并从身份验证层获取分析师身份,而不是从请求体或查询参数获取。后续请求通过 client.beta.agents.sessions.stream 复用 session_id,SDK 辅助函数会自动分派函数处理器。
完整实战教程
询问有关你自己业务数据的问题。该智能体会查找相关的仓库表、检查指标定义和历史分析、运行只读 SQL,并记住有用的修正以供未来调查使用。
为什么使用 Agents API?
一次有用的调查通常需要多次查询和后续问题。
Agents API 将这些工作保留在一个会话中,并允许模型调用你应用程序的工具。你的应用程序拥有数据库访问权限,并决定分析师可以看到哪些上下文和已保存的修正。
此示例借鉴了 OpenAI 的内部数据代理:将分析建立在真实模式上,提供业务上下文,暴露 SQL,并复用团队明确保存的修正。
 ## 你需要准备什么
- Python 3.14+ 和
uv。 - 一个 OpenAI API 密钥。
- 对 PostgreSQL 兼容数据仓库的只读访问权限。
不需要执行沙箱。该智能体使用不带环境的 Agents API 会话,你的应用程序控制每一次数据仓库查询。
连接你的数据仓库
从仓库根目录开始:
cp examples/agents_api/apps/data_analyst/.env.example examples/agents_api/apps/data_analyst/.env
将你的 OpenAI API 密钥和只读的 WAREHOUSE_URL 添加到 examples/agents_api/apps/data_analyst/.env。应用程序会自动加载此文件。
可选地,取消 .env 中 DATA_AGENT_CONTEXT 的注释,并根据你团队的表格描述、指标定义、历史查询和公司文档调整示例上下文文件。保存的分析师修正记录存储在 examples/agents_api/apps/data_analyst/memories.json。
运行数据代理
uv run examples/agents_api/apps/data_analyst/main.py
打开 http://127.0.0.1:8000 并提问:
Why did paid conversions drop last week?
然后继续同样的调查:
Only include enterprise customers.
或者从终端提出单个问题:
uv run examples/agents_api/apps/data_analyst/main.py --prompt \
"Why did paid conversions drop last week?"
工作原理
该智能体有四个专注的工具:
search_tables查找相关表并读取其实际列。search_context检索指标定义、先前的查询、文档和已保存的更正。query_warehouse执行一次只读查询,最多返回 100 行。save_memory存储明确请求的更正以供后续使用。
save_memory 工具通过 tool_search 按需发现。程序化工具调用让智能体在响应之前能够组合元数据、业务上下文、已保存的更正以及多个已验证的查询。
使用只读仓库角色。应用程序还会以只读模式启动 PostgreSQL 连接,应用查询超时,并显示每个已执行的查询。包含的浏览器界面代表单个本地分析师。在多用户应用程序中,应从你的身份验证层获取分析师身份,而不是从请求体或查询参数中获取。
跟随实现
以下摘录解释了 agent.py 和 warehouse.py。
上述应用程序包含工具调度循环、错误处理和清理。
1. 在编写 SQL 之前发现表
加载示例的环境,然后创建仓库适配器。发现过程返回实际的表列,以及你在上下文文件中提供的任何所有权和新鲜度说明。
from dotenv import load_dotenv
from examples.agents_api.apps.data_analyst.warehouse import Warehouse

load_dotenv("examples/agents_api/apps/data_analyst/.env")
warehouse = Warehouse()
tables = warehouse.search_tables({"query": "paid conversion"})
for table in tables["tables"]:
    print(table["columns"])
2. 添加定义和可信查询
使用 DATA_AGENT_CONTEXT 指向一个包含 tables、metrics、documents 和 query_history 的 JSON 文件。例如,一条指标记录可以同时定义计算方式以及团队期望的筛选条件:
{
"metrics": [{
"name": "paid_conversion_rate",
"definition": "Paid subscriptions divided by eligible signups.",
"filters": [
"Exclude employees and test accounts.",
"Exclude the current incomplete day."
]
}],
"documents": [{
"title": "Checkout tracking migration",
"text": "Mobile checkout tracking changed on August 18."
}]
}
用团队审核过的定义替换那些示例性定义。query_history 记录将 description 与经过审核的 sql 查询配对,这样智能体就能复用已建立的连接。之前的历史全量查询在回答每周问题时,仍然需要显式的日期范围。
3. 注册四个工具
agent.py 为每个工具定义了一个 schema,然后启用工具搜索和程序化工具调用。记忆写入会推迟到智能体需要时再进行:
from examples.agents_api.apps.data_analyst.agent import define_tool

tools = [
    define_tool("search_tables", "Find tables and inspect schemas.",
                {"query": {"type": "string"}}),
    define_tool("search_context", "Find definitions, previous queries, and memories.",
                {"query": {"type": "string"}}),
    define_tool("query_warehouse", "Run read-only SQL.",
                {"sql": {"type": "string"}}),
    define_tool("save_memory", "Save a correction only when explicitly requested.",
                {"note": {"type": "string"},
                 "scope": {"type": "string", "enum": ["personal", "team"]}},
                defer_loading=True),
    {"type": "tool_search"},
    {"type": "programmatic_tool_calling", "enabled": True},
]

handlers = {
    "search_tables": warehouse.search_tables,
    "search_context": warehouse.search_context,
    "query_warehouse": warehouse.query,
    "save_memory": warehouse.memory.save,
}
模型可以在回答之前结合发现、上下文和多个查询。
它永远不会收到 WAREHOUSE_URL。查询执行保留在你的应用程序中,
在只读数据库角色下进行。
4. 在没有沙箱的情况下开始调查
仅对话会话在创建请求中通过输入启动:
from openai import AsyncOpenAI

client = AsyncOpenAI()
instructions = """\
Find relevant tables and metric definitions.
Check previous analyses and saved corrections.
Run read-only queries and explain your findings, assumptions, and SQL.
Save memory only when the user explicitly asks.
"""

events = await client.beta.agents.sessions.create(
    agent={
        "model": "gpt-5.6-luna",
        "instructions": instructions,
        "reasoning": {"effort": "high"},
        "tools": tools,
    },
    environment={"type": "none"},
    input="Why did paid conversions drop last week?",
    stream=True,
)
读取 agent.session.created 以保存 event.session.id。当创建流发出 agent.session.requires_action 时,将每个待处理的函数调用分派给其处理程序并返回结果:
import json

arguments = action.arguments
if isinstance(arguments, str):
    arguments = json.loads(arguments)
output = handlers[action.name](arguments)
await client.beta.agents.sessions.events.create(
    session_id,
    events=[{
        "type": "agent.session.input.tool_result",
        "turn_id": action.turn_id,
        "call_id": action.call_id,
        "success": True,
        "output": json.dumps(output),
    }],
)
继续消费流,直到协调器的轮次完成。应用程序按轮次和调用 ID 对调用进行去重,在工具失败时返回通用错误,并将每个执行的 SQL 查询与答案一起记录。
要使用该完整循环而无需重新构建它:
from examples.agents_api.apps.data_analyst.agent import DataAnalyst

analyst = DataAnalyst(client, warehouse)
result = await analyst.answer("Why did paid conversions drop last week?")
print(result["answer"])
print(result["queries"])
使用低层流程或 DataAnalyst 之一,不要对同一请求同时使用两者。
5. 继续同一调查
应用程序将 conversation_id 映射到已保存的 API 会话。将其传回以进行后续操作:
follow_up = await analyst.answer(
    "Only include enterprise customers.",
    conversation_id=result["conversation_id"],
)
print(follow_up["answer"])
在内部,后续请求使用 `client.beta.agents.sessions.stream(session_id,
input=question, tool_handlers=handlers)`。与创建流不同,这个 SDK
辅助函数会为你分派函数处理器。
6. 保存显式更正
让智能体记住一条规则,例如:“记住企业转化不包括手动配置的账户。”save_memory 工具会以个人或团队范围写入该备注:
warehouse.memory.save({
    "note": "Enterprise conversion excludes manually provisioned accounts.",
    "scope": "team",
})
remembered = warehouse.search_context({"query": "enterprise conversion"})
print(remembered["memories"])
会话历史保留当前对话。跨会话记忆由应用负责:memory.py 将修正保存到 memories.json 中。在为多个用户提供服务时,请将该存储迁移到你的应用数据库中。
7. 检查证据并清理
有用的答案包括结果、查询过的表、SQL 以及任何假设。请将叙述视为需要对照这些记录进行验证的结论,而不是它们的替代品。结果取决于你的数据仓库;本示例不附带固定的业务数据集。
分析师完成后,删除会话并关闭数据仓库:
try:
    await analyst.close()
finally:
    await client.close()
浏览器应用在关闭时会执行此清理操作。它将活跃的对话映射保存在内存中,而保存的修正则在重启后依然保留。
文件
- main.py:Web 路由、UI 以及命令行入口点。
- agent.py:Agent 配置、工具以及对话流程。
- warehouse.py:只读查询、schema 以及业务上下文。
- memory.py:保存的个人和团队修正。
常见问题
常见错误包括:未复制 .env 或未设置只读 WAREHOUSE_URL 导致连接失败;DATA_AGENT_CONTEXT 未指向包含 tables、metrics、documents、query_history 的 JSON 文件导致上下文缺失;历史全量查询在回答每周问题时缺少显式日期范围;重复处理同一 turn_id 和 call_id 造成重复执行;工具失败时未返回通用错误;同时使用低层流程和 DataAnalyst 导致重复请求。排查时先确认只读角色权限、查询超时和返回行数限制,再检查事件流中 requires_action 的分派与 tool_result 回传是否匹配。生产环境应把 memories.json 迁移到数据库,增加身份认证、审计日志、查询限流和结果脱敏。
企业应用扩展
可扩展方向包括:把记忆存储替换为应用数据库并支持团队级共享;增加更多只读工具如指标血缘查询或数据质量检查;为 query_warehouse 增加更细粒度的行级权限和列级脱敏;将浏览器界面从单本地分析师扩展为多用户服务;引入查询缓存和成本监控;把 DataAnalyst 封装为可复用的服务组件,并接入现有身份验证与审计体系。
总结
本文面向有编程基础的开发者,讲解如何用 Agents API 构建一个能查询业务数据仓库的数据分析师智能体。文章覆盖环境准备、只读仓库连接、四个核心工具(search_tables、search_context、query_warehouse、save_memory)的注册与调度、程序化工具调用与工具搜索、会话续接、显式修正记忆的持久化,以及证据检查与资源清理。重点说明为什么把查询执行留在应用侧、如何用只读角色和超时控制风险,并给出常见错误排查与生产优化方向。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:中级
- 验证等级:V1
- 原文作者:alfozan
- 原文日期:2026-09-10
- 来源许可:MIT
- 来源版本:
d31fce070c91ceb04a558c83bf290db484059790 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员