使用自定义数据集评估基于MCP的答案
技术背景
随着AI模型与外部工具(如MCP服务器)的集成日益普遍,评估这些交互的答案质量变得至关重要。MCP允许模型动态获取外部数据,但如何确保答案的准确性和相关性成为挑战。自定义数据集评估提供了一种针对特定用例的量化测试方法,帮助开发者识别模型在工具使用、上下文理解等方面的不足,从而优化系统配置和提示词设计。
核心原理
评估流程基于OpenAI Evals框架,核心原理包括:1) 定义包含输入查询和预期答案的自定义数据集;2) 配置评分器,包括基于LLM的通过/失败评分器(利用o3模型判断答案语义是否匹配)和基于Python的MCP使用审计评分器(检查模型是否实际调用了MCP工具);3) 通过Evals API创建评估定义,指定数据模式、评分标准和通过阈值;4) 为每个模型运行评估,使用相同的数据集和配置以确保公平比较;5) 轮询运行状态直至完成,并检索输出进行人工分析。
架构分析
系统架构包括:1) 数据层:自定义内存数据集,包含查询和预期答案;2) 评估定义层:通过client.evals.create配置评估名称、数据源模式、测试标准(LLM评分器和Python评分器);3) 运行层:为每个模型创建评估运行,指定模型参数(如温度、最大令牌数)和MCP工具配置(服务器URL、允许的工具列表);4) 结果层:轮询运行状态,获取输出项,进行人工检查。设计决策包括:使用MCP工具提供仓库感知的答案,通过系统提示词控制工具使用行为(如禁止或鼓励),以及使用种子值确保可重复性。
完整实战教程
使用自定义数据集评估基于MCP的答案
在本文中,我们将探讨如何使用自定义数据集来评估基于MCP(模型上下文协议)的答案。我们将介绍评估流程、所需工具以及如何解释结果。
为什么需要评估MCP答案?
MCP(模型上下文协议)允许AI模型与外部工具和数据进行交互。评估这些交互的答案质量对于确保系统可靠性至关重要。通过使用自定义数据集,您可以针对特定用例测试MCP的性能。
评估步骤
1. 准备自定义数据集
首先,您需要准备一个包含输入和预期输出的数据集。数据集应反映您的实际使用场景。例如,如果您正在构建一个天气查询工具,数据集可能包含城市名称和对应的天气信息。
# 示例数据集
dataset = [
    {"input": "北京天气如何?", "expected": "北京今天晴,气温25°C。"},
    {"input": "上海明天会下雨吗?", "expected": "上海明天有雨,请携带雨伞。"}
]
2. 定义评估指标
选择合适的评估指标至关重要。常见的指标包括:
- 精确匹配:答案是否与预期完全一致。
- 语义相似度:使用嵌入模型计算答案与预期的相似度。
- 人工评分:由人工评估答案质量。
3. 运行评估
编写评估脚本,遍历数据集,调用MCP工具获取答案,并与预期进行比较。
import mcp_client

def evaluate(dataset):
    results = []
    for item in dataset:
        answer = mcp_client.query(item["input"])
        score = calculate_score(answer, item["expected"])
        results.append({"input": item["input"], "answer": answer, "expected": item["expected"], "score": score})
    return results
4. 分析结果
评估完成后,分析结果以识别MCP的强项和弱项。您可以计算平均分数,并检查失败案例以改进系统。
结论
使用自定义数据集评估MCP答案是一种有效的方法,可以确保您的AI系统在实际应用中表现良好。通过系统化的评估,您可以持续优化MCP配置和提示词。
进一步阅读
本笔记本使用 OpenAI Evals 框架和自定义内存数据集,评估模型回答关于 tiktoken GitHub 仓库问题的能力。
我们使用自定义的内存 Q&A 数据集,并比较两个模型:gpt-4.1 和 o4-mini,它们利用 MCP 工具来提供仓库感知、上下文准确的答案。
目标:
- 展示如何使用自定义数据集设置和运行 OpenAI Evals 评估。
- 比较利用基于 MCP 工具的不同模型的性能。
- 提供专业、可复现评估工作流的最佳实践。
_下一步:我们将设置环境并导入必要的库。_
# Update OpenAI client
%pip install --upgrade openai --quiet
环境设置
我们首先导入所需的库并配置 OpenAI 客户端。
此步骤确保我们可以访问 OpenAI API 以及评估所需的所有必要工具。
import os
import time

from openai import OpenAI

# Instantiate the OpenAI client (no custom base_url).
client = OpenAI(
    api_key=os.getenv("OPENAI_API_KEY") or os.getenv("_OPENAI_API_KEY"),
)
定义自定义评估数据集
我们定义了一个关于 tiktoken 仓库的小型内存数据集,包含问答对。
该数据集将用于测试模型在 MCP 工具帮助下提供准确和相关答案的能力。
- 每个条目包含一个
query(用户的问题)和一个answer(预期的标准答案)。 - 您可以根据自己的用例或仓库修改或扩展此数据集。
def get_dataset(limit=None):
    items = [
        {
            "query": "What is tiktoken?",
            "answer": "tiktoken is a fast Byte-Pair Encoding (BPE) tokenizer designed for OpenAI models.",
        },
        {
            "query": "How do I install the open-source version of tiktoken?",
            "answer": "Install it from PyPI with `pip install tiktoken`.",
        },
        {
            "query": "How do I get the tokenizer for a specific OpenAI model?",
            "answer": 'Call tiktoken.encoding_for_model("<model-name>"), e.g. tiktoken.encoding_for_model("gpt-4o").',
        },
        {
            "query": "How does tiktoken perform compared to other tokenizers?",
            "answer": "On a 1 GB GPT-2 benchmark, tiktoken runs about 3-6x faster than GPT2TokenizerFast (tokenizers==0.13.2, transformers==4.24.0).",
        },
        {
            "query": "Why is Byte-Pair Encoding (BPE) useful for language models?",
            "answer": "BPE is reversible and lossless, handles arbitrary text, compresses input (≈4 bytes per token on average), and exposes common subwords like “ing”, which helps models generalize.",
        },
    ]
    return items[:limit] if limit else items
定义评分逻辑
为了评估模型的答案,我们使用两个评分器:
- 通过/失败评分器(基于LLM):
- Python MCP评分器:
一个基于LLM的评分器,检查模型的答案是否与预期答案(真实答案)匹配或传达相同的意思。
一个Python函数,检查模型在回答过程中是否实际使用了MCP工具(用于审计工具使用情况)。
最佳实践:
同时使用基于LLM和程序化的评分器可以提供更健壮和透明的评估。
# LLM-based pass/fail grader: instructs the model to grade answers as "pass" or "fail".
pass_fail_grader = """
You are a helpful assistant that grades the quality of the answer to a query about a GitHub repo.
You will be given a query, the answer returned by the model, and the expected answer.
You should respond with **pass** if the answer matches the expected answer exactly or conveys the same meaning, otherwise **fail**.
"""

# User prompt template for the grader, providing context for grading.
pass_fail_grader_user_prompt = """
<Query>
{{item.query}}
</Query>

<Web Search Result>
{{sample.output_text}}
</Web Search Result>

<Ground Truth>
{{item.answer}}
</Ground Truth>
"""


# Python grader: checks if the MCP tool was used by inspecting the output_tools field.
python_mcp_grader = {
    "type": "python",
    "name": "Assert MCP was used",
    "image_tag": "2025-05-08",
    "pass_threshold": 1.0,
    "source": """
def grade(sample: dict, item: dict) -> float:
    output = sample.get('output_tools', [])
    return 1.0 if len(output) > 0 else 0.0
""",
}
定义评估配置
现在我们使用 OpenAI Evals 框架来配置评估。
此步骤指定:
- 评估名称和数据集。
- 每个条目的模式(每个问答对中包含哪些字段)。
- 要使用的评分器(基于 LLM 和/或基于 Python)。
- 通过标准和标签。
最佳实践:
提前明确定义评估模式和评分逻辑,可确保可重复性和透明度。
# Create the evaluation definition using the OpenAI Evals client.
logs_eval = client.evals.create(
    name="MCP Eval",
    data_source_config={
        "type": "custom",
        "item_schema": {
            "type": "object",
            "properties": {
                "query": {"type": "string"},
                "answer": {"type": "string"},
            },
        },
        "include_sample_schema": True,
    },
    testing_criteria=[
        {
            "type": "label_model",
            "name": "General Evaluator",
            "model": "o3",
            "input": [
                {"role": "system", "content": pass_fail_grader},
                {"role": "user", "content": pass_fail_grader_user_prompt},
            ],
            "passing_labels": ["pass"],
            "labels": ["pass", "fail"],
        },
        python_mcp_grader
    ],
)
为每个模型运行评估
现在,我们为每个模型(gpt-4.1 和 o4-mini)运行评估。
每次运行配置为:
- 使用 MCP 工具进行仓库感知的答案。
- 使用相同的数据集和评估配置,以确保公平比较。
- 指定模型特定的参数(如最大完成令牌数和允许的工具)。
最佳实践:
保持评估设置在不同模型间一致,可确保结果具有可比性和可靠性。
# Run 1: gpt-4.1 using MCP
gpt_4one_responses_run = client.evals.runs.create(
    name="gpt-4.1",
    eval_id=logs_eval.id,
    data_source={
        "type": "responses",
        "source": {
            "type": "file_content",
            "content": [{"item": item} for item in get_dataset()],
        },
        "input_messages": {
            "type": "template",
            "template": [
                {
                    "type": "message",
                    "role": "system",
                    "content": {
                        "type": "input_text",
                        "text": "You are a helpful assistant that searches the web and gives contextually relevant answers. Never use your tools to answer the query.",
                    },
                },
                {
                    "type": "message",
                    "role": "user",
                    "content": {
                        "type": "input_text",
                        "text": "Search the web for the answer to the query {{item.query}}",
                    },
                },
            ],
        },
        "model": "gpt-4.1",
        "sampling_params": {
            "seed": 42,
            "temperature": 0.7,
            "max_completions_tokens": 10000,
            "top_p": 0.9,
            "tools": [
                {
                    "type": "mcp",
                    "server_label": "gitmcp",
                    "server_url": "https://gitmcp.io/openai/tiktoken",
                    "allowed_tools": [
                        "search_tiktoken_documentation",
                        "fetch_tiktoken_documentation",
                    ],
                    "require_approval": "never",
                }
            ],
        },
    },
)
# Run 2: o4-mini using MCP
gpt_o4_mini_responses_run = client.evals.runs.create(
    name="o4-mini",
    eval_id=logs_eval.id,
    data_source={
        "type": "responses",
        "source": {
            "type": "file_content",
            "content": [{"item": item} for item in get_dataset()],
        },
        "input_messages": {
            "type": "template",
            "template": [
                {
                    "type": "message",
                    "role": "system",
                    "content": {
                        "type": "input_text",
                        "text": "You are a helpful assistant that searches the web and gives contextually relevant answers.",
                    },
                },
                {
                    "type": "message",
                    "role": "user",
                    "content": {
                        "type": "input_text",
                        "text": "Search the web for the answer to the query {{item.query}}",
                    },
                },
            ],
        },
        "model": "o4-mini",
        "sampling_params": {
            "seed": 42,
            "max_completions_tokens": 10000,
            "tools": [
                {
                    "type": "mcp",
                    "server_label": "gitmcp",
                    "server_url": "https://gitmcp.io/openai/tiktoken",
                    "allowed_tools": [
                        "search_tiktoken_documentation",
                        "fetch_tiktoken_documentation",
                    ],
                    "require_approval": "never",
                }
            ],
        },
    },
)
轮询完成状态并获取输出
启动评估运行后,我们可以轮询运行状态,直到它们完成。
此步骤确保我们仅在所有模型响应处理完毕后分析结果。
最佳实践:
带延迟的轮询可避免过多的 API 调用,并确保资源的高效利用。
def poll_runs(eval_id, run_ids):
    while True:
        runs = [client.evals.runs.retrieve(rid, eval_id=eval_id) for rid in run_ids]
        for run in runs:
            print(run.id, run.status, run.result_counts)
        if all(run.status in {"completed", "failed"} for run in runs):
            break
        time.sleep(5)

# Start polling both runs.
poll_runs(logs_eval.id, [gpt_4one_responses_run.id, gpt_o4_mini_responses_run.id])
展示与解读模型输出
最后,我们展示每个模型的输出,以便进行人工检查和进一步分析。
- 每个模型对数据集中每个问题的回答都会被打印出来。
- 您可以并排比较输出,以评估质量、相关性和正确性。
以下是 OpenAI Evals 仪表板的截图,展示了两个模型的评估输出:
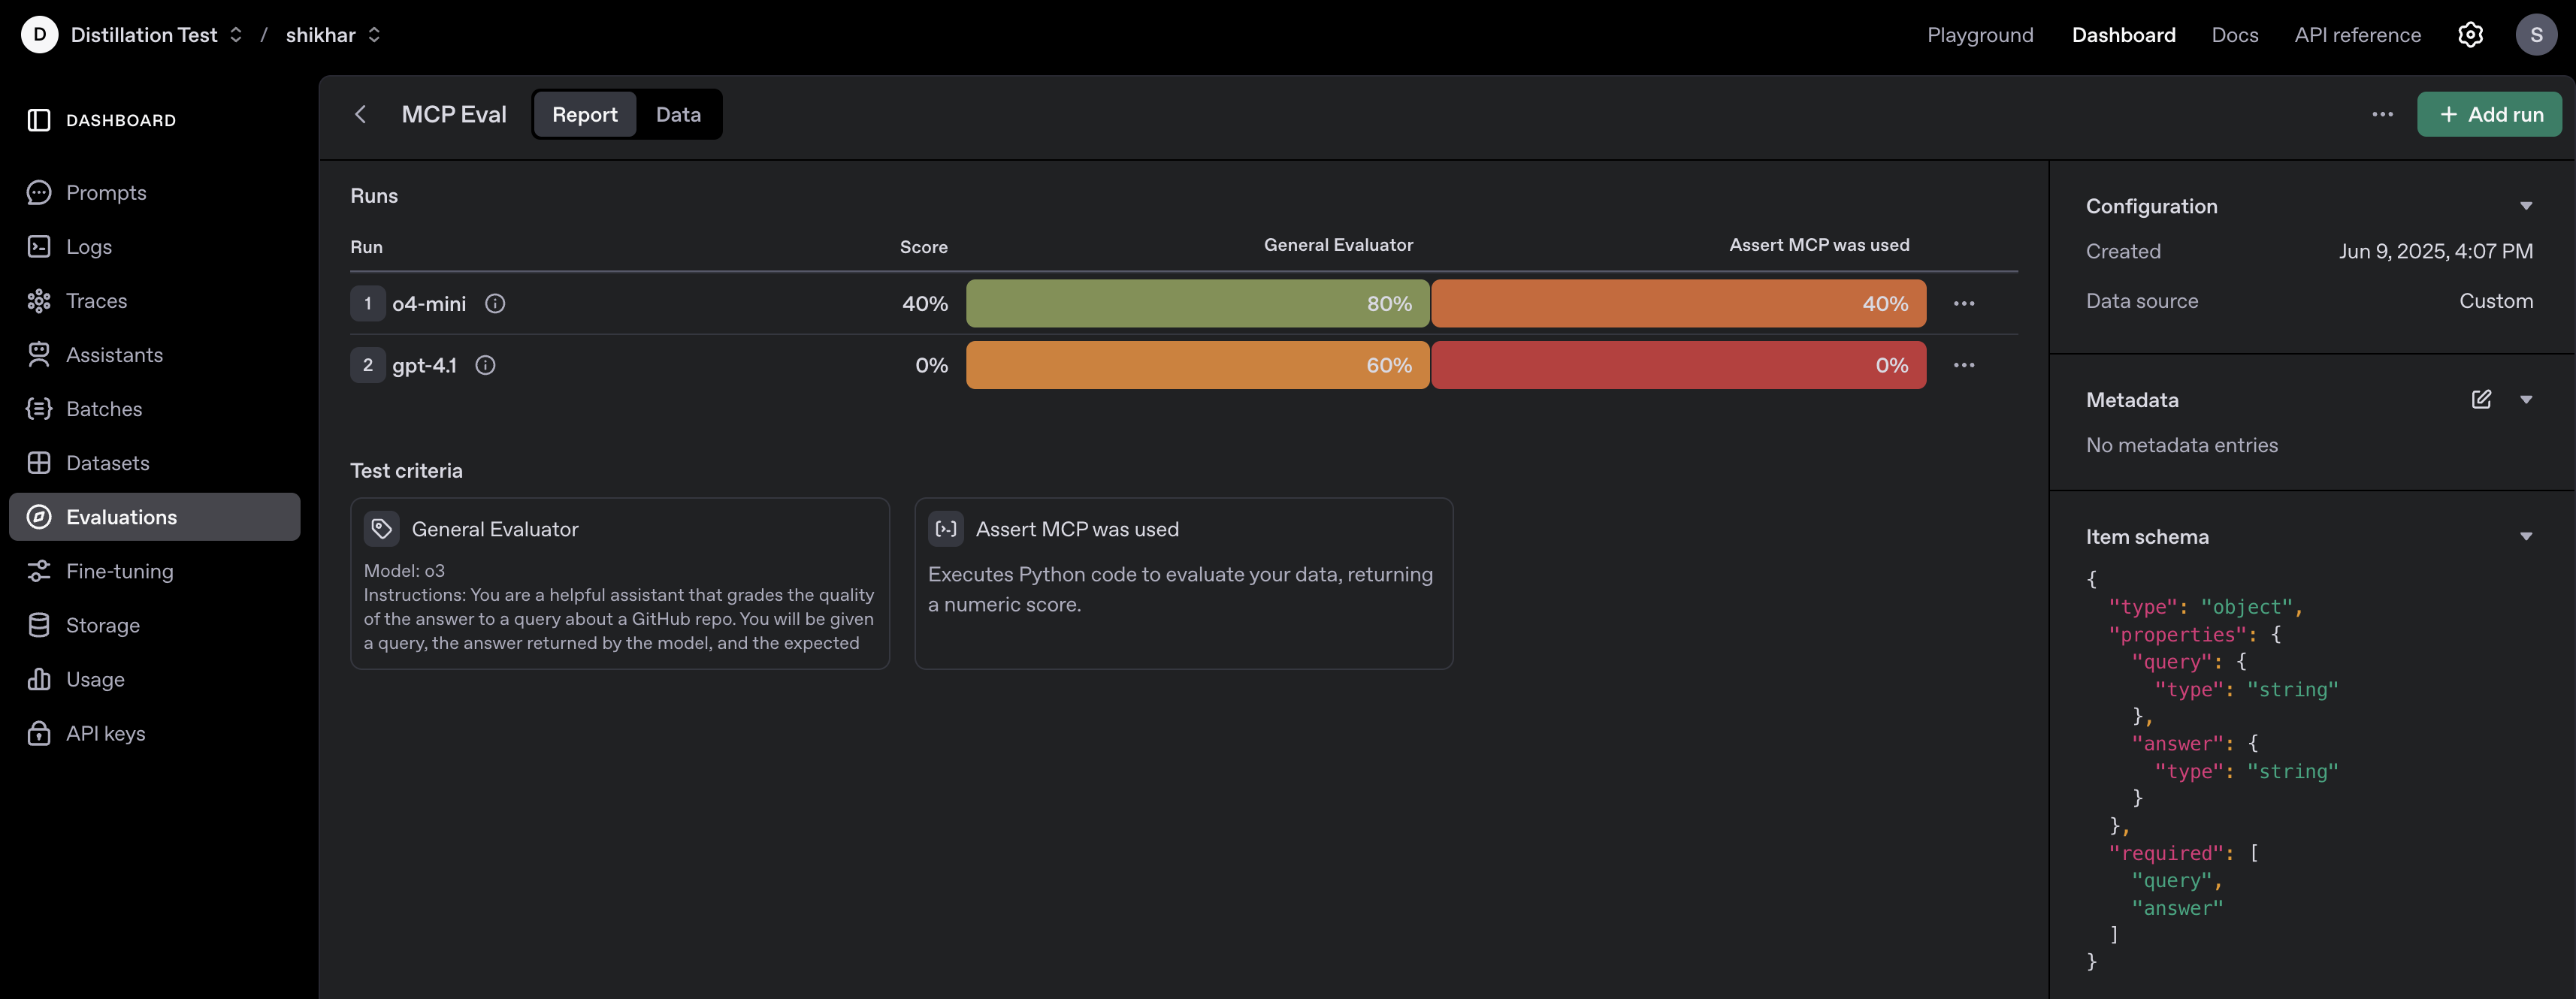 有关评估指标和结果的全面细分,请导航至仪表板中的“数据”选项卡:
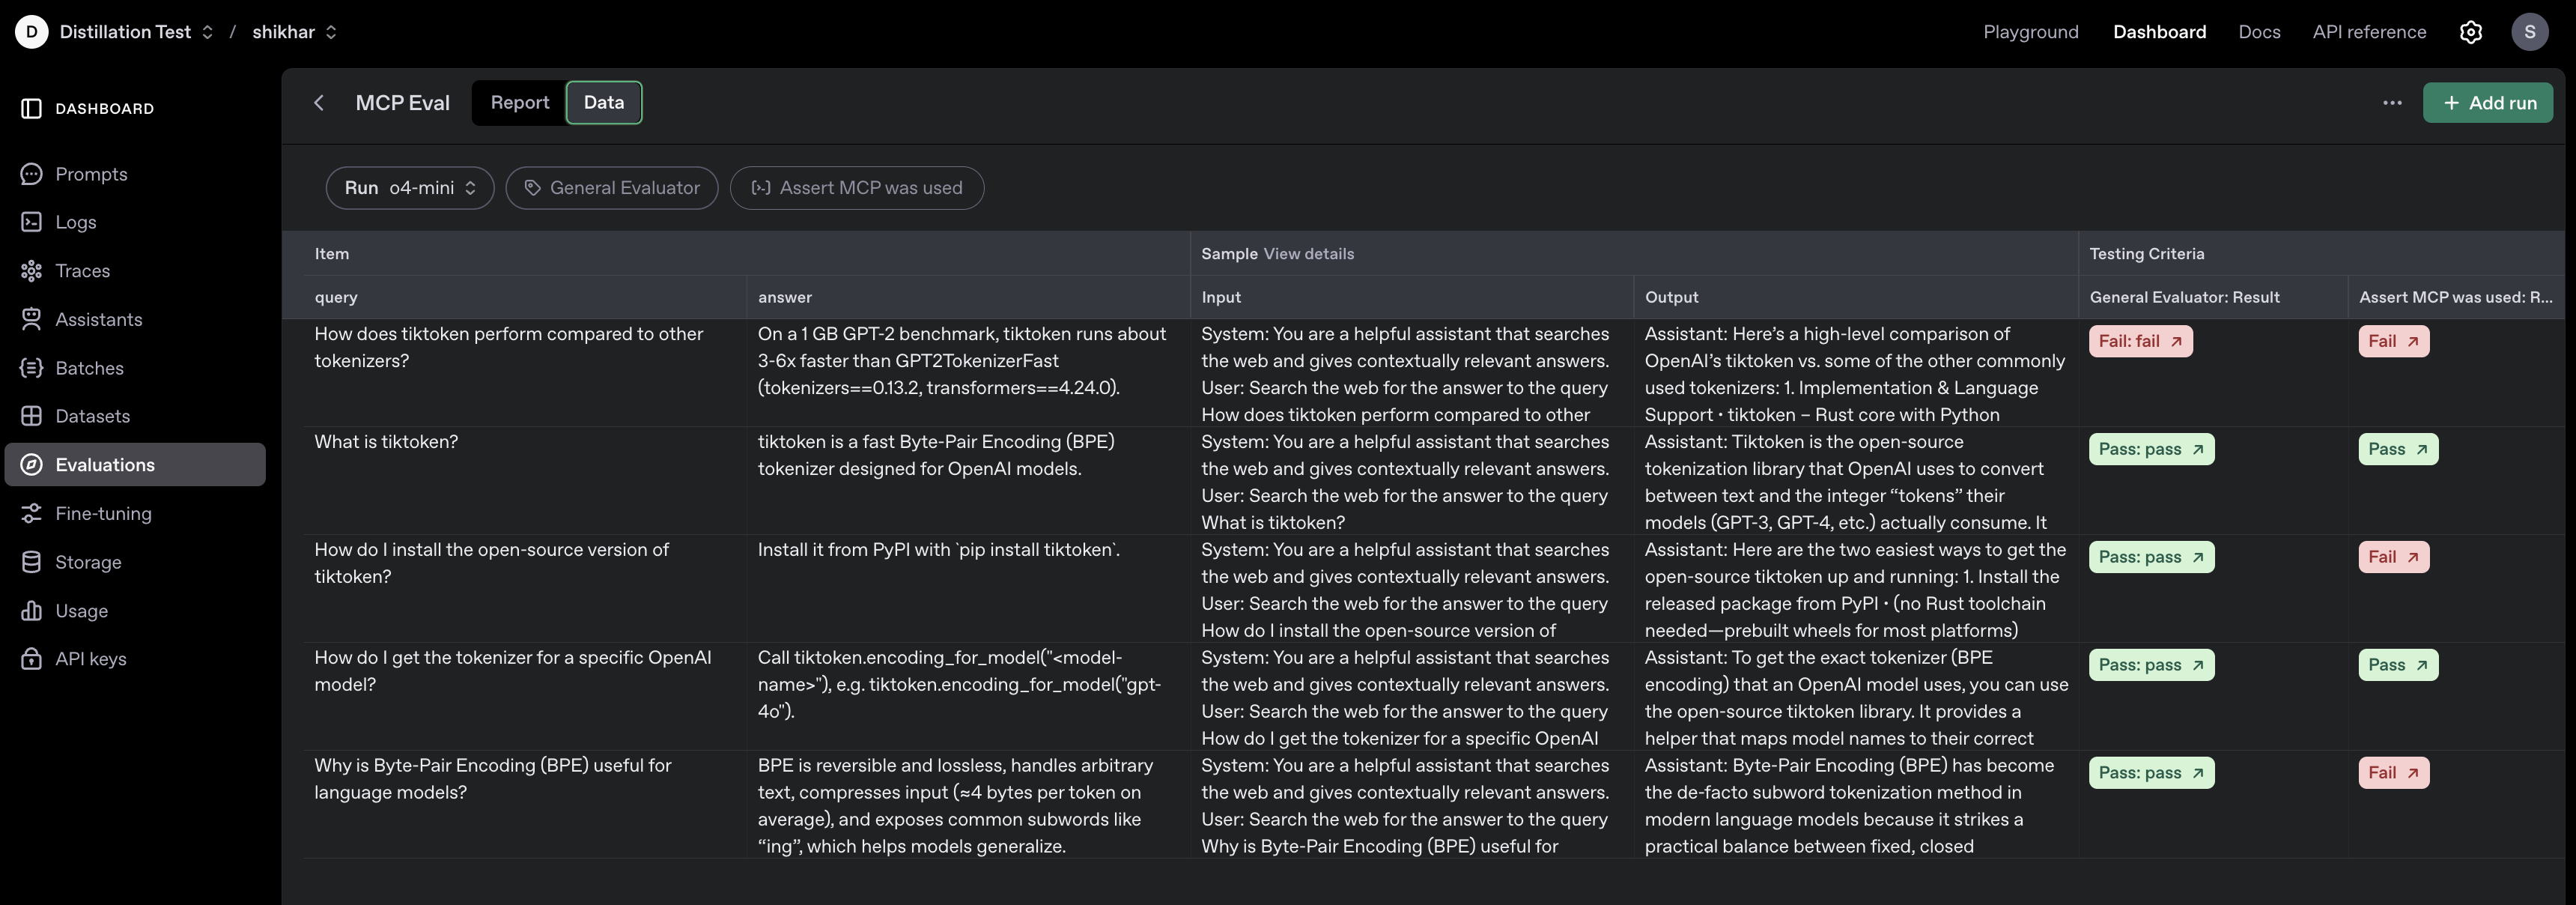
请注意,4.1 模型被构建为从不使用其工具来回答查询,因此它从未调用 MCP 服务器。o4-mini 模型没有被明确指示使用其工具,但也没有被禁止,因此它调用了 MCP 服务器 3 次。我们可以看到 4.1 模型的表现比 o4 模型差。同样值得注意的是,o4-mini 模型失败的一个例子是未使用 MCP 工具的情况。
我们还可以检查每个模型输出的详细分析,以便手动检查和进一步分析。
four_one_output = client.evals.runs.output_items.list(
    run_id=gpt_4one_responses_run.id, eval_id=logs_eval.id
)

o4_mini_output = client.evals.runs.output_items.list(
    run_id=gpt_o4_mini_responses_run.id, eval_id=logs_eval.id
)
print('# gpt‑4.1 Output')
for item in four_one_output:
    print(item.sample.output[0].content)

print('\n# o4-mini Output')
for item in o4_mini_output:
    print(item.sample.output[0].content)
我们如何改进?
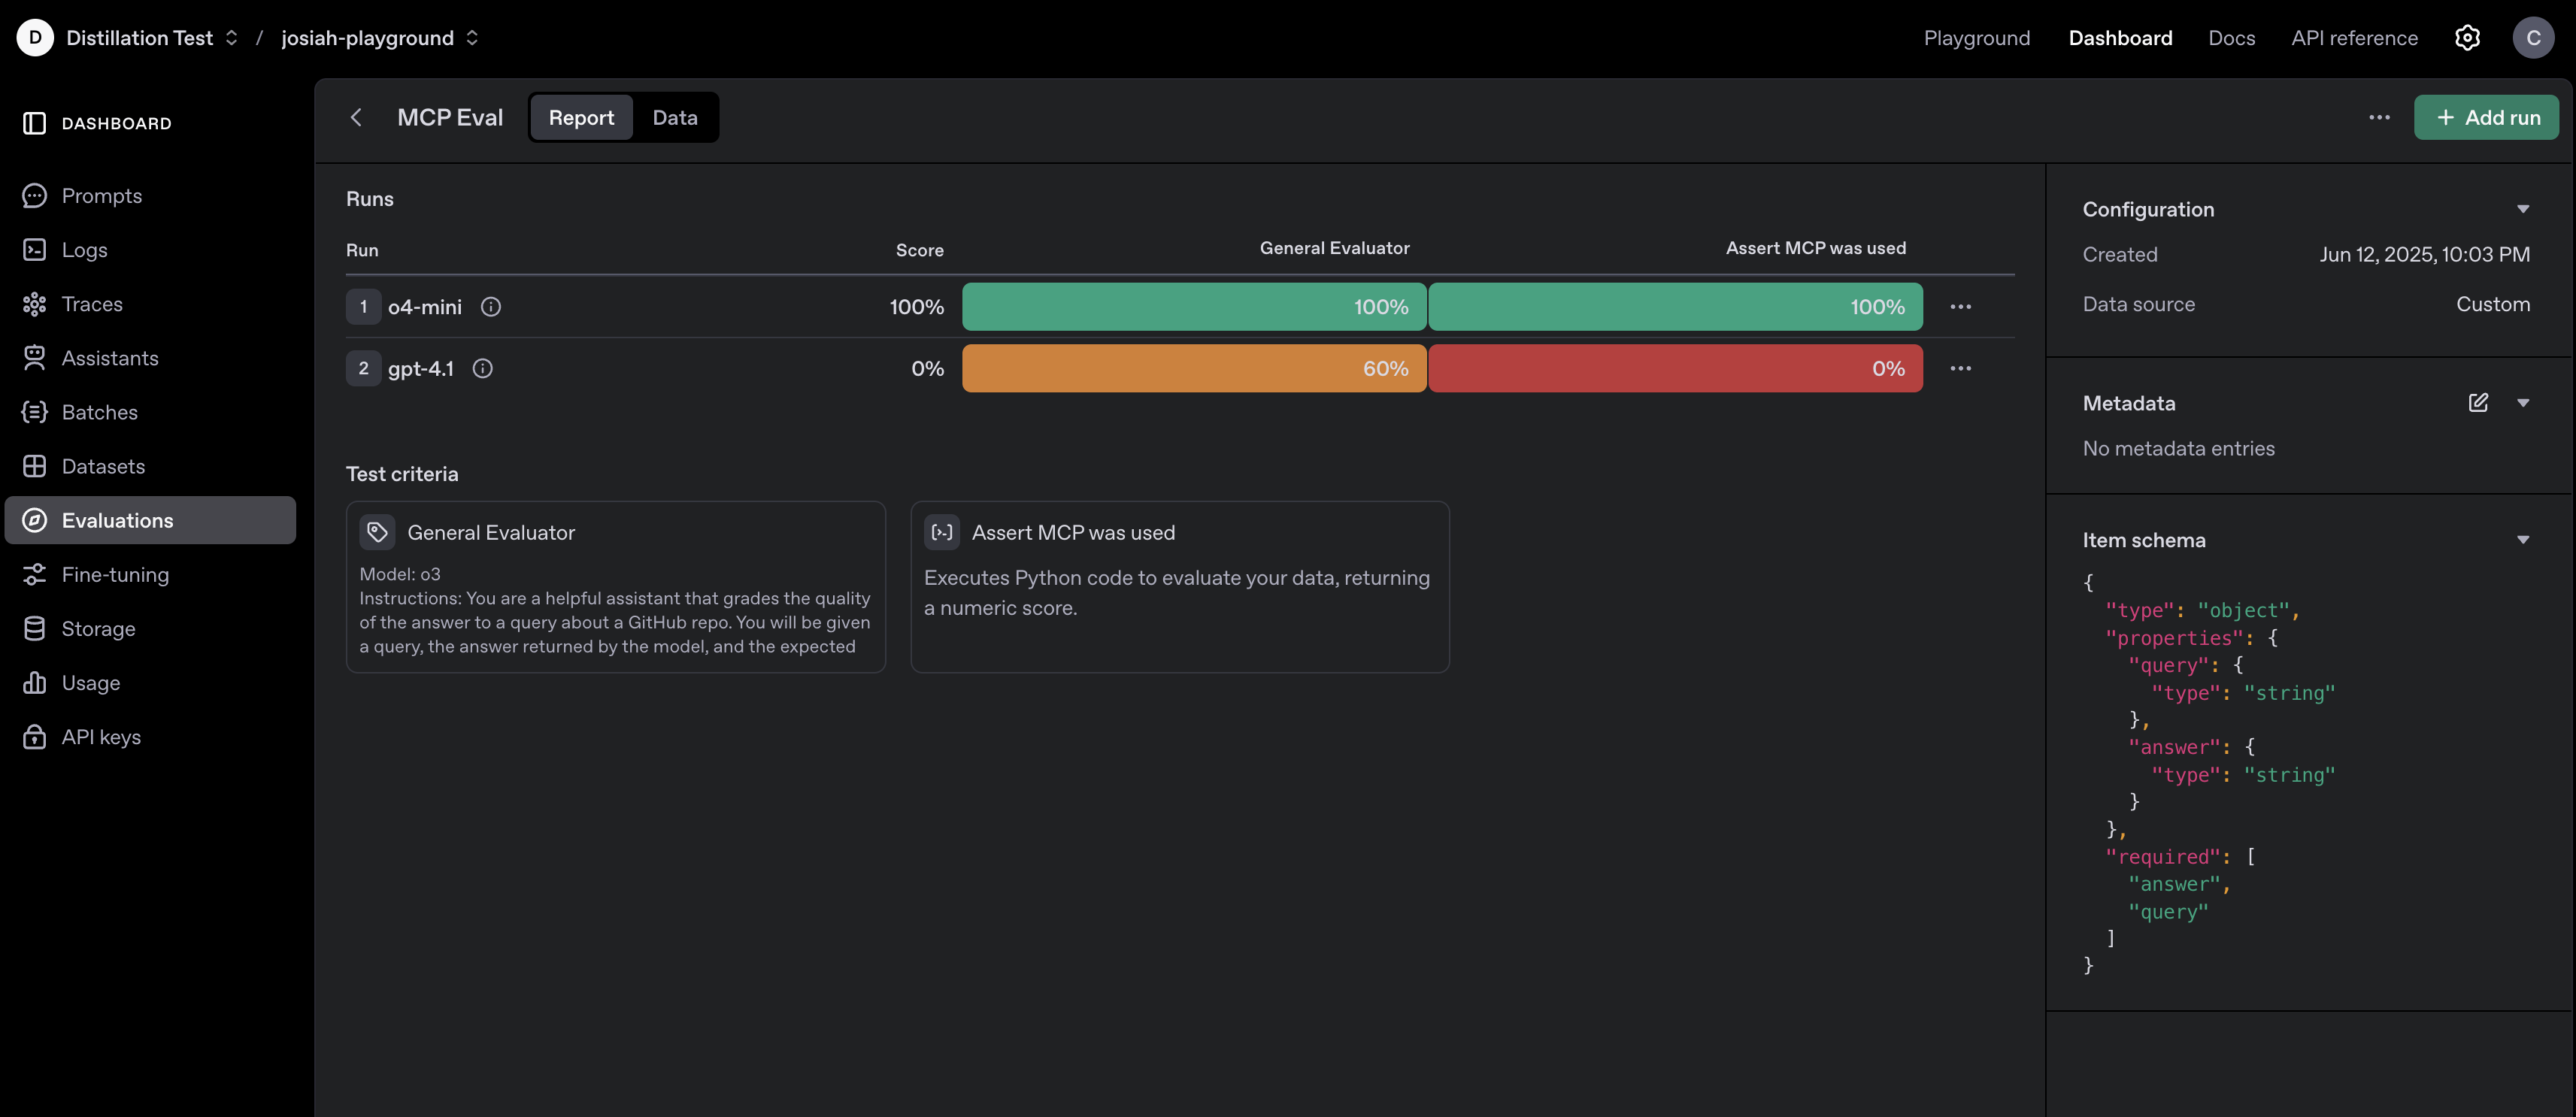
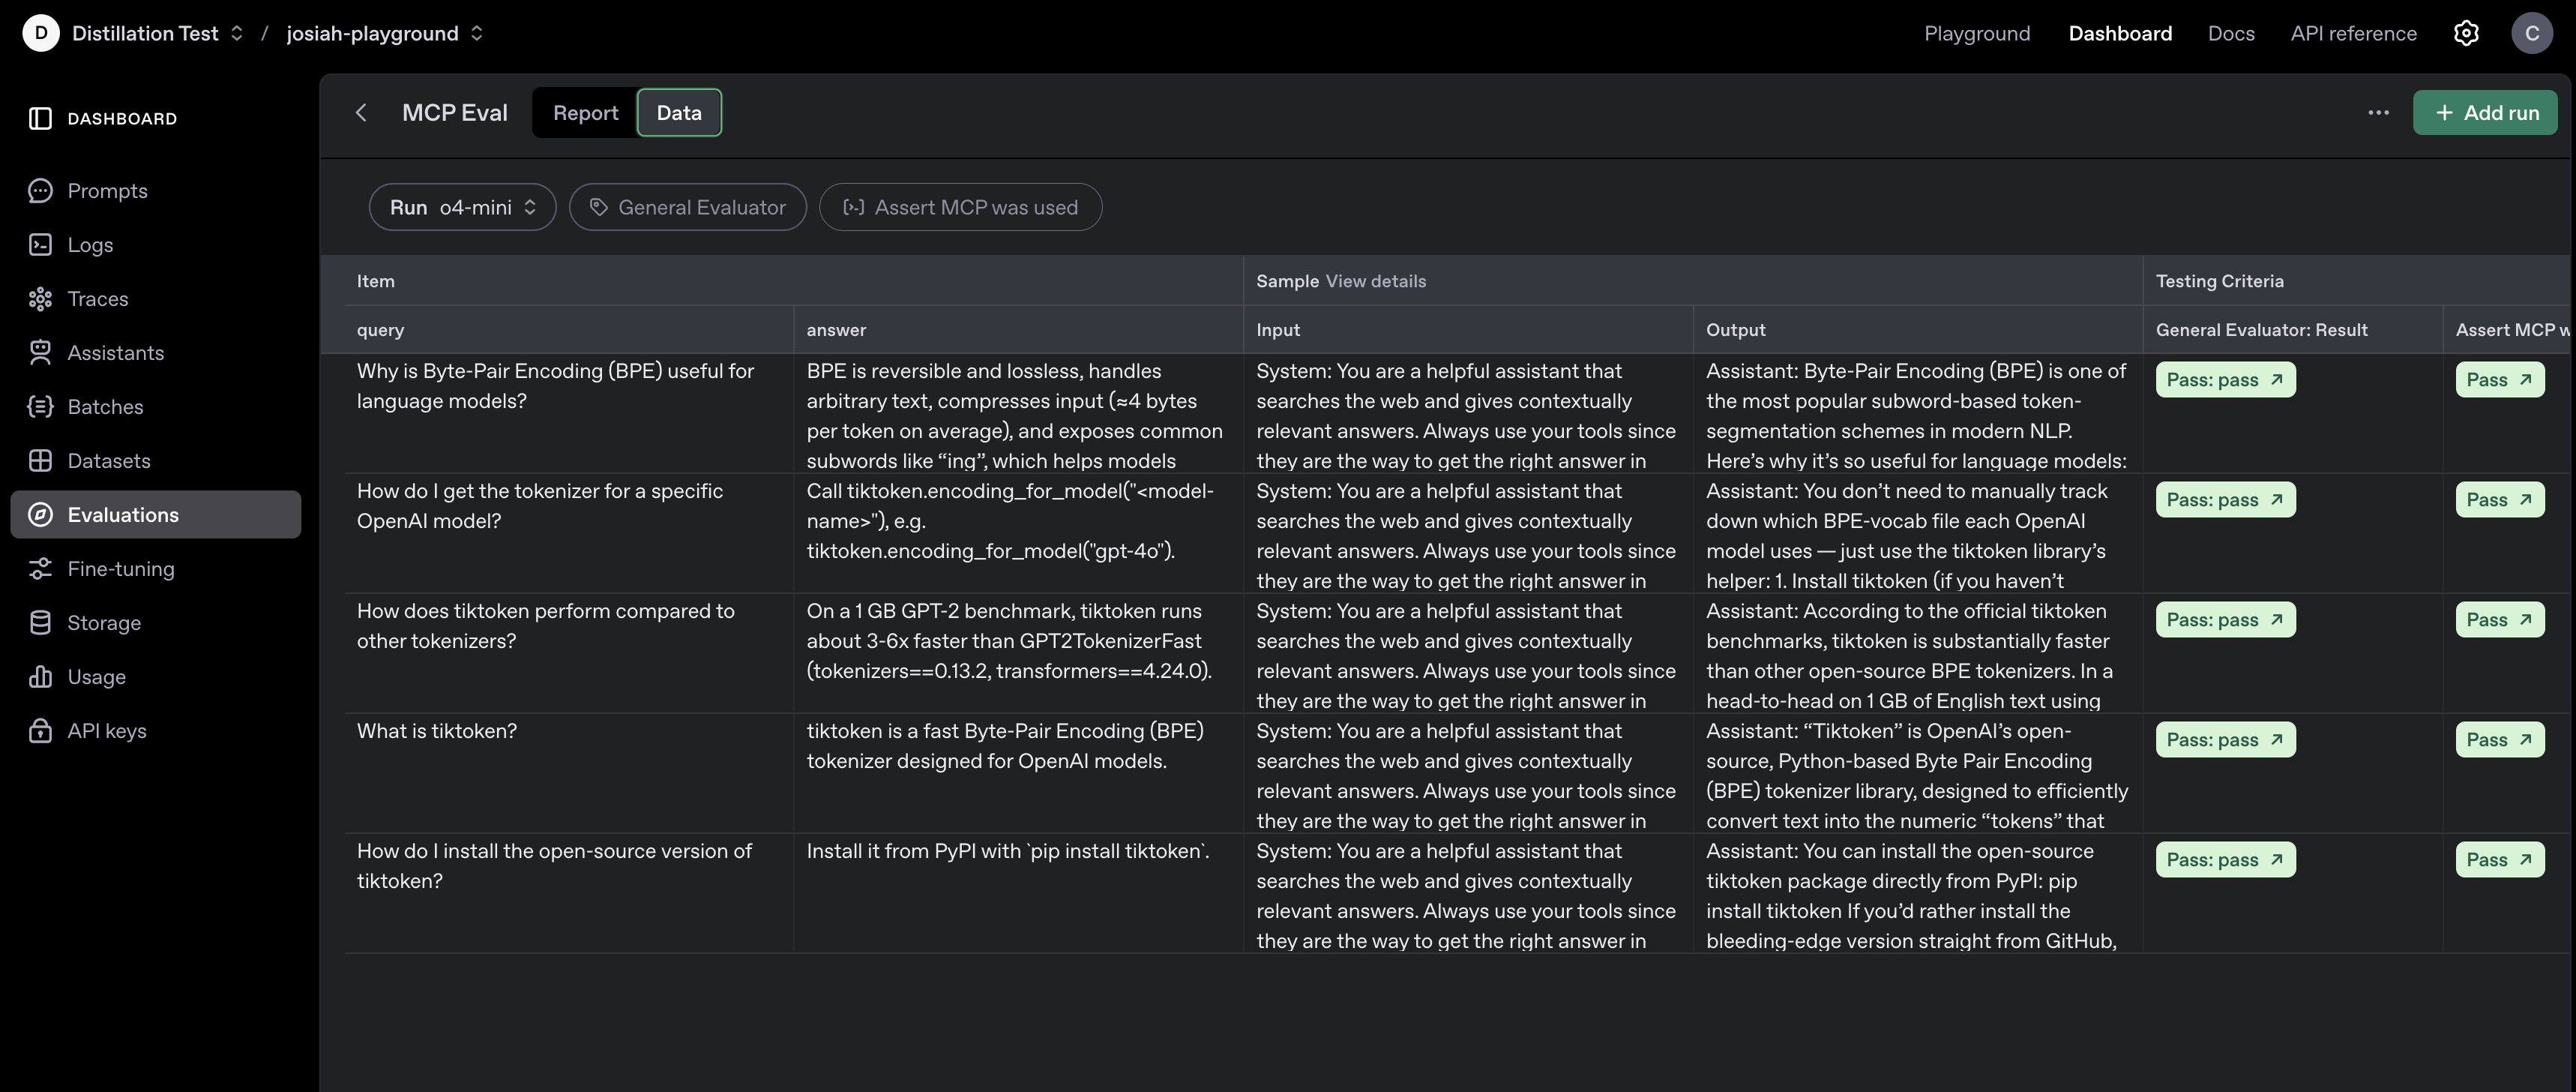
如果我们在 o4-mini 模型的系统消息中添加这样一句话:“始终使用你的工具,因为它们是完成此任务时获得正确答案的方式。”你认为会发生什么?(试试看)
<br><br><br>
如果你猜到了模型现在每次都会调用 MCP 工具并得到所有正确答案,那么你是对的!
在本笔记本中,我们演示了一个示例工作流,用于评估 LLM 回答关于 tiktoken 仓库的技术问题的能力,使用 OpenAI Evals 框架并利用 MCP 工具。
涵盖的关键点:
- 定义了一个聚焦的、自定义的评估数据集。
- 配置了基于 LLM 和基于 Python 的评分器,以进行稳健的评估。
- 以可重复且透明的方式比较了两个模型(
gpt-4.1和o4-mini)。 - 检索并显示了模型输出,以供自动/手动检查。
后续步骤:
- 扩展数据集: 添加更多多样化和具有挑战性的问题,以更好地评估模型能力。
- 分析结果: 总结通过/失败率,可视化性能,或进行错误分析以识别优势和劣势。
- 尝试模型/工具: 尝试其他模型,调整工具配置,或在其他仓库上进行测试。
- 自动化报告: 生成汇总表或图表,以便更轻松地共享和决策。
有关更多信息,请查看 OpenAI Evals 文档。
常见问题
常见错误:1) 未正确设置OPENAI_API_KEY环境变量,导致客户端初始化失败;2) 数据集格式不符合item_schema定义,导致评估运行错误;3) MCP服务器URL不可达或工具名称拼写错误,导致工具调用失败;4) 轮询逻辑未处理超时或异常状态,导致死循环。排查方法:检查API密钥和网络连接,验证数据集字段与schema匹配,使用curl测试MCP服务器端点,在轮询循环中添加最大重试次数和错误处理。生产环境优化:使用异步并发运行多个评估,缓存MCP响应以减少延迟,采用分布式执行框架(如Ray)处理大规模数据集,并定期更新评估数据集以反映真实场景变化。
企业应用扩展
可扩展方向:1) 扩展数据集:增加更多样化、具有挑战性的问题,覆盖边界情况和错误场景;2) 增强评分器:引入语义相似度计算(如BERTScore)或人工评分流程,提高评估准确性;3) 多模型对比:纳入更多模型(如GPT-4o、Claude)进行基准测试;4) 自动化报告:生成通过率、失败案例分析等可视化报告,集成到CI/CD管道中;5) 优化MCP配置:调整工具列表、服务器选择,或实现自定义MCP服务器以提供更精准的数据;6) 提示词工程:系统化测试不同系统提示词对工具调用率和答案质量的影响。
总结
本文介绍如何使用OpenAI Evals框架和自定义内存数据集,评估基于MCP(模型上下文协议)的模型回答质量。通过定义包含问答对的数据集,配置基于LLM和Python的评分器,并比较gpt-4.1和o4-mini两个模型在MCP工具辅助下的表现,展示了系统化评估工作流。文章强调同时使用多种评分器、保持评估设置一致性、轮询运行状态等最佳实践,并提供了改进模型提示词以提升工具调用率的示例。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:中级
- 验证等级:V1
- 原文作者:josiah-openai, shikhar-cyber
- 原文日期:2025-06-09
- 来源许可:MIT
- 来源版本:
44481d0cb2fa1e2d461476814c5b186a7309c528 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员