使用LlamaIndex评估RAG:全面指南
技术背景
大型语言模型(LLM)在海量通用数据上训练,但缺乏特定领域或私有数据。RAG通过动态检索外部知识源,将相关信息注入生成过程,从而提升回答的准确性和时效性。评估RAG系统至关重要,因为其性能直接影响应用可靠性。常见问题包括检索结果不相关、生成内容幻觉、响应质量不稳定等。LlamaIndex提供了一套完整的评估工具,帮助开发者量化检索和生成的质量,识别瓶颈并优化系统。适用场景包括问答系统、聊天机器人、企业知识库等。主要限制是评估依赖LLM,成本较高,且评估指标可能受模型偏见影响。
核心原理
RAG系统由检索器和生成器组成。检索器将用户查询转换为向量,在索引中查找最相关的文档片段;生成器(LLM)结合查询和检索到的上下文生成回答。LlamaIndex的评估模块基于LLM作为评判者,通过对比生成响应与标准答案或检索上下文,计算多个指标。检索评估指标包括命中率(Hit Rate)和平均倒数排名(MRR),衡量检索结果的相关性和排序质量。响应评估指标包括忠实度(Faithfulness)和相关性(Relevancy),分别衡量响应是否忠实于检索上下文(无幻觉)以及是否与查询相关。评估流程:首先构建评估数据集(问题-上下文对),然后运行检索器和查询引擎,最后使用评估器计算指标。
架构分析
LlamaIndex的评估架构分为三层:数据层、评估层和应用层。数据层负责加载文档、解析节点、构建索引(如VectorStoreIndex)。评估层包含RetrieverEvaluator(用于检索评估)和ResponseEvaluator(如FaithfulnessEvaluator、RelevancyEvaluator),以及BatchEvalRunner用于批量评估。应用层是QueryEngine,封装了检索和生成逻辑。关键设计决策包括:使用OpenAI的GPT-4作为评估LLM,确保评估质量;使用gpt-3.5-turbo生成响应,以模拟实际应用;通过ServiceContext隔离不同LLM配置。评估流程:生成问题-上下文对(generate_question_context_pairs),创建检索器,运行RetrieverEvaluator得到检索指标;创建查询引擎,生成响应,使用FaithfulnessEvaluator和RelevancyEvaluator评估响应质量。BatchEvalRunner支持并行评估,提高效率。
完整实战教程
使用LlamaIndex评估RAG
检索增强生成(RAG)系统通过结合检索器和生成器,能够从外部知识源中获取信息并生成回答。然而,评估这类系统的性能至关重要,以确保其准确性和可靠性。LlamaIndex提供了多种评估工具,帮助开发者衡量RAG系统的效果。
为什么评估RAG?
评估RAG系统有助于:
- 衡量回答的准确性和相关性
- 识别检索环节的薄弱点
- 优化提示词和索引结构
- 比较不同配置的性能
LlamaIndex评估模块
LlamaIndex提供了以下评估模块:
- 响应评估:评估生成的回答质量,包括正确性、相关性和忠实度。
- 检索评估:评估检索器返回的文档相关性。
- 集成评估:结合检索和生成,评估端到端性能。
构建评估数据集
评估需要一组问题及其标准答案。您可以使用自己的数据集,或使用LlamaIndex的合成数据生成功能。
from llama_index.evaluation import generate_question_context_pairs

# 生成问题-上下文对
qa_pairs = generate_question_context_pairs(
    nodes, llm=llm, num_questions_per_chunk=2
)
运行评估
使用ResponseEvaluator和RetrievalEvaluator进行评估。
from llama_index.evaluation import ResponseEvaluator, RetrievalEvaluator

# 初始化评估器
evaluator = ResponseEvaluator(llm=llm)
retrieval_evaluator = RetrievalEvaluator(llm=llm)

# 评估响应
result = evaluator.evaluate_response(
    query=query, response=response, contexts=contexts
)

# 评估检索
retrieval_result = retrieval_evaluator.evaluate(
    query=query, retrieved_nodes=retrieved_nodes
)
解读评估结果
评估结果通常包含分数和反馈。例如,ResponseEvaluator返回correctness、relevancy和faithfulness分数。您可以根据这些指标调整RAG系统。
最佳实践
- 使用多样化的评估数据集
- 定期评估以跟踪改进
- 结合人工评估和自动评估
- 关注失败案例,进行针对性优化
通过LlamaIndex的评估工具,您可以系统地提升RAG系统的性能,确保其在实际应用中表现可靠。
在本笔记本中,我们将探讨如何使用LlamaIndex构建RAG管道并对其进行评估。它包含以下3个部分。
- 理解检索增强生成(RAG)。
- 使用LlamaIndex构建RAG。
- 使用LlamaIndex评估RAG。
检索增强生成(RAG)
大型语言模型在海量数据集上进行训练,但这些数据集不会包含你的特定数据。检索增强生成(RAG)通过在生成过程中动态整合你的数据来解决这一问题。这并非通过改变LLM的训练数据来实现,而是允许模型实时访问和利用你的数据,以提供更具针对性和上下文相关性的响应。
在RAG中,你的数据会被加载并准备用于查询或“索引”。用户查询作用于索引,将你的数据筛选为最相关的上下文。然后,该上下文和你的查询连同提示词一起发送给LLM,LLM据此生成响应。
即使你正在构建的是聊天机器人或智能体,你也会需要了解RAG技术,以便将数据引入你的应用程序。
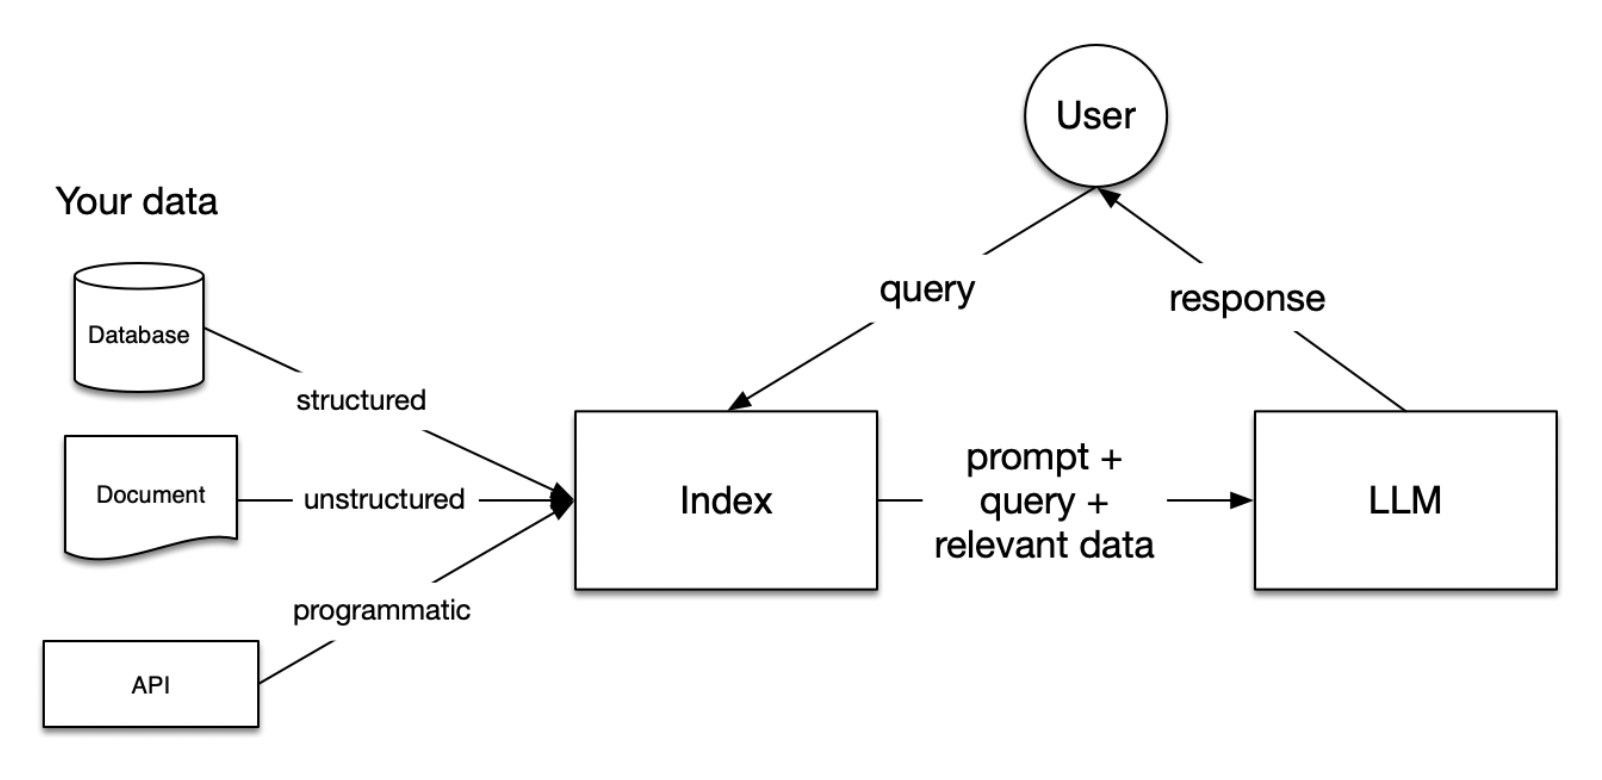
RAG 中的阶段
RAG 中有五个关键阶段,它们将是你构建的任何大型应用的一部分。这些阶段是:
加载: 这指的是将你的数据从它所在的位置——无论是文本文件、PDF、其他网站、数据库还是 API——导入到你的管道中。LlamaHub 提供了数百个连接器供你选择。
索引: 这意味着创建一个允许查询数据的数据结构。对于 LLM 来说,这几乎总是意味着创建向量嵌入,即数据含义的数值表示,以及许多其他元数据策略,以便轻松准确地找到上下文相关的数据。
存储: 一旦你的数据被索引,你将希望存储你的索引以及任何其他元数据,以避免需要重新索引。
查询: 对于任何给定的索引策略,有许多方法可以利用 LLM 和 LlamaIndex 数据结构进行查询,包括子查询、多步查询和混合策略。
评估: 任何管道中的关键步骤是检查它相对于其他策略的有效性,或者当你做出更改时。评估提供了关于你的查询响应准确性、忠实度和速度的客观衡量标准。
构建 RAG 系统。
既然我们已经理解了 RAG 系统的重要性,那么让我们构建一个简单的 RAG 流水线。
!pip install llama-index
# The nest_asyncio module enables the nesting of asynchronous functions within an already running async loop.
# This is necessary because Jupyter notebooks inherently operate in an asynchronous loop.
# By applying nest_asyncio, we can run additional async functions within this existing loop without conflicts.
import nest_asyncio

nest_asyncio.apply()

from llama_index.evaluation import generate_question_context_pairs
from llama_index import VectorStoreIndex, SimpleDirectoryReader, ServiceContext
from llama_index.node_parser import SimpleNodeParser
from llama_index.evaluation import generate_question_context_pairs
from llama_index.evaluation import RetrieverEvaluator
from llama_index.llms import OpenAI

import os
import pandas as pd
设置你的OpenAI API密钥
os.environ['OPENAI_API_KEY'] = 'YOUR OPENAI API KEY'
让我们使用 Paul Graham 的文章文本 来构建 RAG 流水线。
下载数据
!mkdir -p 'data/paul_graham/'
!curl 'https://raw.githubusercontent.com/run-llama/llama_index/main/docs/examples/data/paul_graham/paul_graham_essay.txt' -o 'data/paul_graham/paul_graham_essay.txt'
加载数据并构建索引。
documents = SimpleDirectoryReader("./data/paul_graham/").load_data()

# Define an LLM
llm = OpenAI(model="gpt-4")

# Build index with a chunk_size of 512
node_parser = SimpleNodeParser.from_defaults(chunk_size=512)
nodes = node_parser.get_nodes_from_documents(documents)
vector_index = VectorStoreIndex(nodes)
构建一个 QueryEngine 并开始查询。
query_engine = vector_index.as_query_engine()
response_vector = query_engine.query("What did the author do growing up?")
检查响应。
response_vector.response
默认情况下,它会检索两个相似的节点/块。你可以在vector_index.as_query_engine(similarity_top_k=k)中修改这个数量。
让我们检查这些检索到的节点中的文本。
# First retrieved node
response_vector.source_nodes[0].get_text()
# Second retrieved node
response_vector.source_nodes[1].get_text()
我们已经构建了一个 RAG 流水线,现在需要评估其性能。我们可以使用 LlamaIndex 的核心评估模块来评估我们的 RAG 系统/查询引擎。让我们探讨如何利用这些工具来量化我们检索增强生成系统的质量。
评估
评估应作为衡量 RAG 应用的主要指标。它决定了流水线是否能根据数据源和一系列查询生成准确的响应。
虽然在一开始检查单个查询和响应是有益的,但随着边缘案例和失败数量的增加,这种方法可能变得不切实际。相反,建立一套汇总指标或自动化评估可能更有效。这些工具可以提供对整体系统性能的洞察,并指出可能需要更仔细审查的特定领域。
在 RAG 系统中,评估侧重于两个关键方面:
* 检索评估: 这评估系统检索到的信息的准确性和相关性。
* 响应评估: 这衡量系统根据检索到的信息生成的响应的质量和适当性。
问题-上下文对生成:
为了评估 RAG 系统,拥有能够获取正确上下文并随后生成适当响应的查询至关重要。LlamaIndex 提供了一个 generate_question_context_pairs 模块,专门用于构建问题和上下文对,可用于评估 RAG 系统的检索和响应评估。有关问题生成的更多详细信息,请参阅文档。
qa_dataset = generate_question_context_pairs(
    nodes,
    llm=llm,
    num_questions_per_chunk=2
)
检索评估:
我们现在准备进行检索评估。我们将使用生成的评估数据集来执行我们的 RetrieverEvaluator。
首先,我们创建 Retriever,然后定义两个函数:get_eval_results,它在数据集上运行我们的检索器,以及 display_results,它展示评估结果。
让我们创建检索器。
retriever = vector_index.as_retriever(similarity_top_k=2)
定义 RetrieverEvaluator。我们使用 命中率 和 MRR 指标来评估我们的检索器。
命中率:
命中率计算在检索到的前 k 个文档中找到正确答案的查询比例。简而言之,它衡量的是系统在前几个猜测中正确获取答案的频率。
平均倒数排名(MRR):
对于每个查询,MRR 通过查看最高相关文档的排名来评估系统的准确性。具体来说,它是所有查询中这些排名的倒数的平均值。因此,如果第一个相关文档是排名第一的结果,则倒数排名为 1;如果排名第二,则倒数排名为 1/2,依此类推。
让我们检查这些指标以评估我们检索器的性能。
retriever_evaluator = RetrieverEvaluator.from_metric_names(
    ["mrr", "hit_rate"], retriever=retriever
)
# Evaluate
eval_results = await retriever_evaluator.aevaluate_dataset(qa_dataset)
让我们定义一个函数,以表格形式显示检索评估结果。
def display_results(name, eval_results):
    """Display results from evaluate."""

    metric_dicts = []
    for eval_result in eval_results:
        metric_dict = eval_result.metric_vals_dict
        metric_dicts.append(metric_dict)

    full_df = pd.DataFrame(metric_dicts)

    hit_rate = full_df["hit_rate"].mean()
    mrr = full_df["mrr"].mean()

    metric_df = pd.DataFrame(
        {"Retriever Name": [name], "Hit Rate": [hit_rate], "MRR": [mrr]}
    )

    return metric_df
display_results("OpenAI Embedding Retriever", eval_results)
观察:
使用 OpenAI Embedding 的检索器表现出 0.7586 的命中率,而 MRR 为 0.6206,这表明在确保最相关结果排在顶部方面还有改进空间。观察到 MRR 低于命中率,说明排名靠前的结果并不总是最相关的。提升 MRR 可能涉及使用重排序器,它可以优化检索文档的顺序。要更深入地了解重排序器如何优化检索指标,请参阅我们 博客文章 中的详细讨论。
响应评估:
- FaithfulnessEvaluator:衡量查询引擎的响应是否与任何源节点匹配,这对于衡量响应是否产生幻觉非常有用。
- Relevancy Evaluator:衡量响应与源节点是否与查询匹配。
# Get the list of queries from the above created dataset

queries = list(qa_dataset.queries.values())
忠实度评估器
让我们从 FaithfulnessEvaluator 开始。
我们将使用 gpt-3.5-turbo 为给定查询生成响应,并使用 gpt-4 进行评估。
让我们分别为 gpt-3.5-turbo 和 gpt-4 创建 service_context。
# gpt-3.5-turbo
gpt35 = OpenAI(temperature=0, model="gpt-3.5-turbo")
service_context_gpt35 = ServiceContext.from_defaults(llm=gpt35)

# gpt-4
gpt4 = OpenAI(temperature=0, model="gpt-4")
service_context_gpt4 = ServiceContext.from_defaults(llm=gpt4)
使用 gpt-3.5-turbo 的 service_context 创建一个 QueryEngine,以生成查询的响应。
vector_index = VectorStoreIndex(nodes, service_context = service_context_gpt35)
query_engine = vector_index.as_query_engine()
创建一个 FaithfulnessEvaluator。
from llama_index.evaluation import FaithfulnessEvaluator
faithfulness_gpt4 = FaithfulnessEvaluator(service_context=service_context_gpt4)
让我们用一个问题来评估。
eval_query = queries[10]

eval_query
首先,生成响应,然后使用忠实度评估器。
response_vector = query_engine.query(eval_query)
# Compute faithfulness evaluation

eval_result = faithfulness_gpt4.evaluate_response(response=response_vector)
# You can check passing parameter in eval_result if it passed the evaluation.
eval_result.passing
相关性评估器
RelevancyEvaluator 用于衡量响应和源节点(检索到的上下文)是否与查询匹配。它有助于判断响应是否真正回答了查询。
使用 gpt-4 实例化 RelevancyEvaluator 以进行相关性评估。
from llama_index.evaluation import RelevancyEvaluator

relevancy_gpt4 = RelevancyEvaluator(service_context=service_context_gpt4)
让我们对其中一个查询进行相关性评估。
# Pick a query
query = queries[10]

query
# Generate response.
# response_vector has response and source nodes (retrieved context)
response_vector = query_engine.query(query)

# Relevancy evaluation
eval_result = relevancy_gpt4.evaluate_response(
    query=query, response=response_vector
)
# You can check passing parameter in eval_result if it passed the evaluation.
eval_result.passing
# You can get the feedback for the evaluation.
eval_result.feedback
批量评估器:
现在我们已经分别完成了忠实度和相关性评估。LlamaIndex 提供了 BatchEvalRunner 来以批量方式计算多个评估。
from llama_index.evaluation import BatchEvalRunner

# Let's pick top 10 queries to do evaluation
batch_eval_queries = queries[:10]

# Initiate BatchEvalRunner to compute FaithFulness and Relevancy Evaluation.
runner = BatchEvalRunner(
    {"faithfulness": faithfulness_gpt4, "relevancy": relevancy_gpt4},
    workers=8,
)

# Compute evaluation
eval_results = await runner.aevaluate_queries(
    query_engine, queries=batch_eval_queries
)
# Let's get faithfulness score

faithfulness_score = sum(result.passing for result in eval_results['faithfulness']) / len(eval_results['faithfulness'])

faithfulness_score
# Let's get relevancy score

relevancy_score = sum(result.passing for result in eval_results['relevancy']) / len(eval_results['relevancy'])

relevancy_score
观察:
忠实度评分为 1.0 表示生成的答案没有幻觉,完全基于检索到的上下文。
相关性评分为 1.0 表明生成的答案始终与检索到的上下文和查询保持一致。
结论
在本笔记本中,我们探讨了如何使用LlamaIndex构建和评估RAG流水线,特别关注流水线中检索系统和生成响应的评估。
LlamaIndex还提供了许多其他评估模块,您可以在此处进一步探索。
常见问题
常见错误及排查方法:1. 未设置OPENAI_API_KEY导致调用失败,需在环境变量中配置。2. 数据加载失败,检查文件路径和格式。3. 索引构建慢或内存不足,可调整chunk_size或使用更高效的索引。4. 评估结果不理想,如命中率低,可尝试调整similarity_top_k或使用重排序器。5. 评估器返回错误,检查LLM模型是否可用,或降低并发workers数。6. 批量评估时出现异步冲突,需使用nest_asyncio。生产环境优化:使用缓存减少重复计算;采用异步评估提升吞吐量;使用更便宜的模型进行初步筛选;定期更新索引以反映数据变化;结合人工评估验证自动评估的准确性。
企业应用扩展
进一步优化RAG系统:1. 使用重排序器(Reranker)提升检索排序质量,如BGE-reranker。2. 调整索引策略,如使用混合检索(稀疏+稠密)。3. 优化提示词,引导LLM更好地利用上下文。4. 引入查询转换(Query Transform)处理复杂查询。5. 使用LlamaIndex的更多评估模块,如CorrectnessEvaluator、SemanticSimilarityEvaluator。6. 结合人工反馈进行强化学习。7. 监控系统性能,建立评估流水线,持续迭代。
总结
本教程面向有编程基础的开发者,深入讲解如何使用LlamaIndex构建和评估RAG(检索增强生成)系统。内容涵盖RAG的核心概念、五个关键阶段(加载、索引、存储、查询、评估),并通过实际代码演示如何构建RAG管道。重点介绍LlamaIndex的评估模块,包括检索评估(命中率、MRR)和响应评估(忠实度、相关性),以及如何使用BatchEvalRunner进行批量评估。教程还提供了环境准备、安装步骤、实践操作和常见问题排查,帮助开发者系统性地优化RAG系统性能。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:中级
- 验证等级:V1
- 原文作者:Ravi Theja
- 原文日期:2023-11-06
- 来源许可:MIT
- 来源版本:
5cf279a7ff76744948f08e788f704cc1f3ca0a77 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员