使用 Responses API 提升推理模型性能
技术背景
推理模型(如 o3、o4-mini)通过内部思维链逐步解决问题,但出于安全考虑,推理令牌仅以摘要形式暴露。在多步对话中,推理令牌默认被丢弃,这可能导致模型在工具调用等场景中丢失关键上下文,影响性能。传统 Completions API 无法有效管理这些推理状态,而 Responses API 作为新一代接口,提供有状态会话、推理项持久化、加密推理项和推理摘要等功能,旨在解决这些问题。适用场景包括多轮对话、智能体工具使用、合规要求严格的零数据保留环境,以及需要优化成本和延迟的生产系统。主要限制是推理令牌不直接暴露,且缓存仅对超过 1024 个令牌的提示生效。
核心原理
推理模型生成两类令牌:推理令牌(内部思维链)和完成令牌(最终输出)。推理令牌以推理项(reasoning item)形式返回,并带有唯一 ID。Responses API 是有状态的,通过 previous_response_id 或显式将推理项加入 input,可在后续请求中复用这些推理项。在工具调用场景中,模型需要基于之前的推理结果决定下一步动作,因此保留推理项至关重要。缓存机制区分推理令牌和完成令牌:推理令牌不参与缓存,但包含推理项可避免重复计算,提高缓存命中率。加密推理项通过 include=["reasoning.encrypted_content"] 获取,在客户端持久化,服务端不存储,满足零数据保留要求。推理摘要则提供推理过程的文本概述,增强可解释性。
架构分析
Responses API 采用有状态会话架构,核心组件包括:客户端(OpenAI SDK)、API 端点、推理引擎(模型)、工具执行环境。数据流:用户输入 → API 调用 → 模型生成推理项和输出 → 返回响应对象 → 客户端解析并可能调用外部工具 → 将工具结果和推理项追加到上下文 → 再次调用 API。关键设计决策:1) 使用 previous_response_id 自动携带历史推理项,简化上下文管理;2) 显式将 response.output 追加到 context,保留推理项和工具调用;3) 加密推理项支持无状态工作流,平衡合规与性能;4) 推理摘要提供中间过程可见性。架构优势在于减少重复推理、提升缓存利用率、降低延迟和成本。
完整实战教程
使用 Responses API 提升推理模型性能
概述
通过将 Responses API 与 OpenAI 最新的推理模型结合使用,您可以在应用中解锁更高的智能水平、更低的成本和更高效的 token 使用。该 API 还支持访问推理摘要,支持托管工具使用等功能,并旨在适应未来的增强功能,以提供更大的灵活性和性能。
我们最近发布了两个新的最先进的推理模型 o3 和 o4-mini,它们在结合推理能力与智能体工具使用方面表现出色。许多人不知道的是,通过充分利用我们(相对)新的 Responses API,可以提升它们的性能。本手册展示了如何充分利用这些模型,并深入探讨了推理和函数调用在后台的工作方式。通过让模型访问之前的推理项,我们可以确保它以最高的智能和最低的成本运行。
我们通过单独的cookbook和API参考介绍了Responses API。主要要点:Responses API与Completions API类似,但有所改进并增加了功能。我们还为Responses推出了加密内容,使其对于无法以有状态方式使用API的用户更加有用!
推理模型的工作原理
在深入探讨 Responses API 如何提供帮助之前,让我们快速回顾一下推理模型的工作原理。像 o3 和 o4-mini 这样的模型会逐步分解问题,产生一个内部思维链,编码其推理过程。出于安全考虑,这些推理令牌仅以摘要形式向用户展示。
在多步对话中,推理令牌在每一轮之后被丢弃,而每一步的输入和输出令牌则被输入到下一轮中。
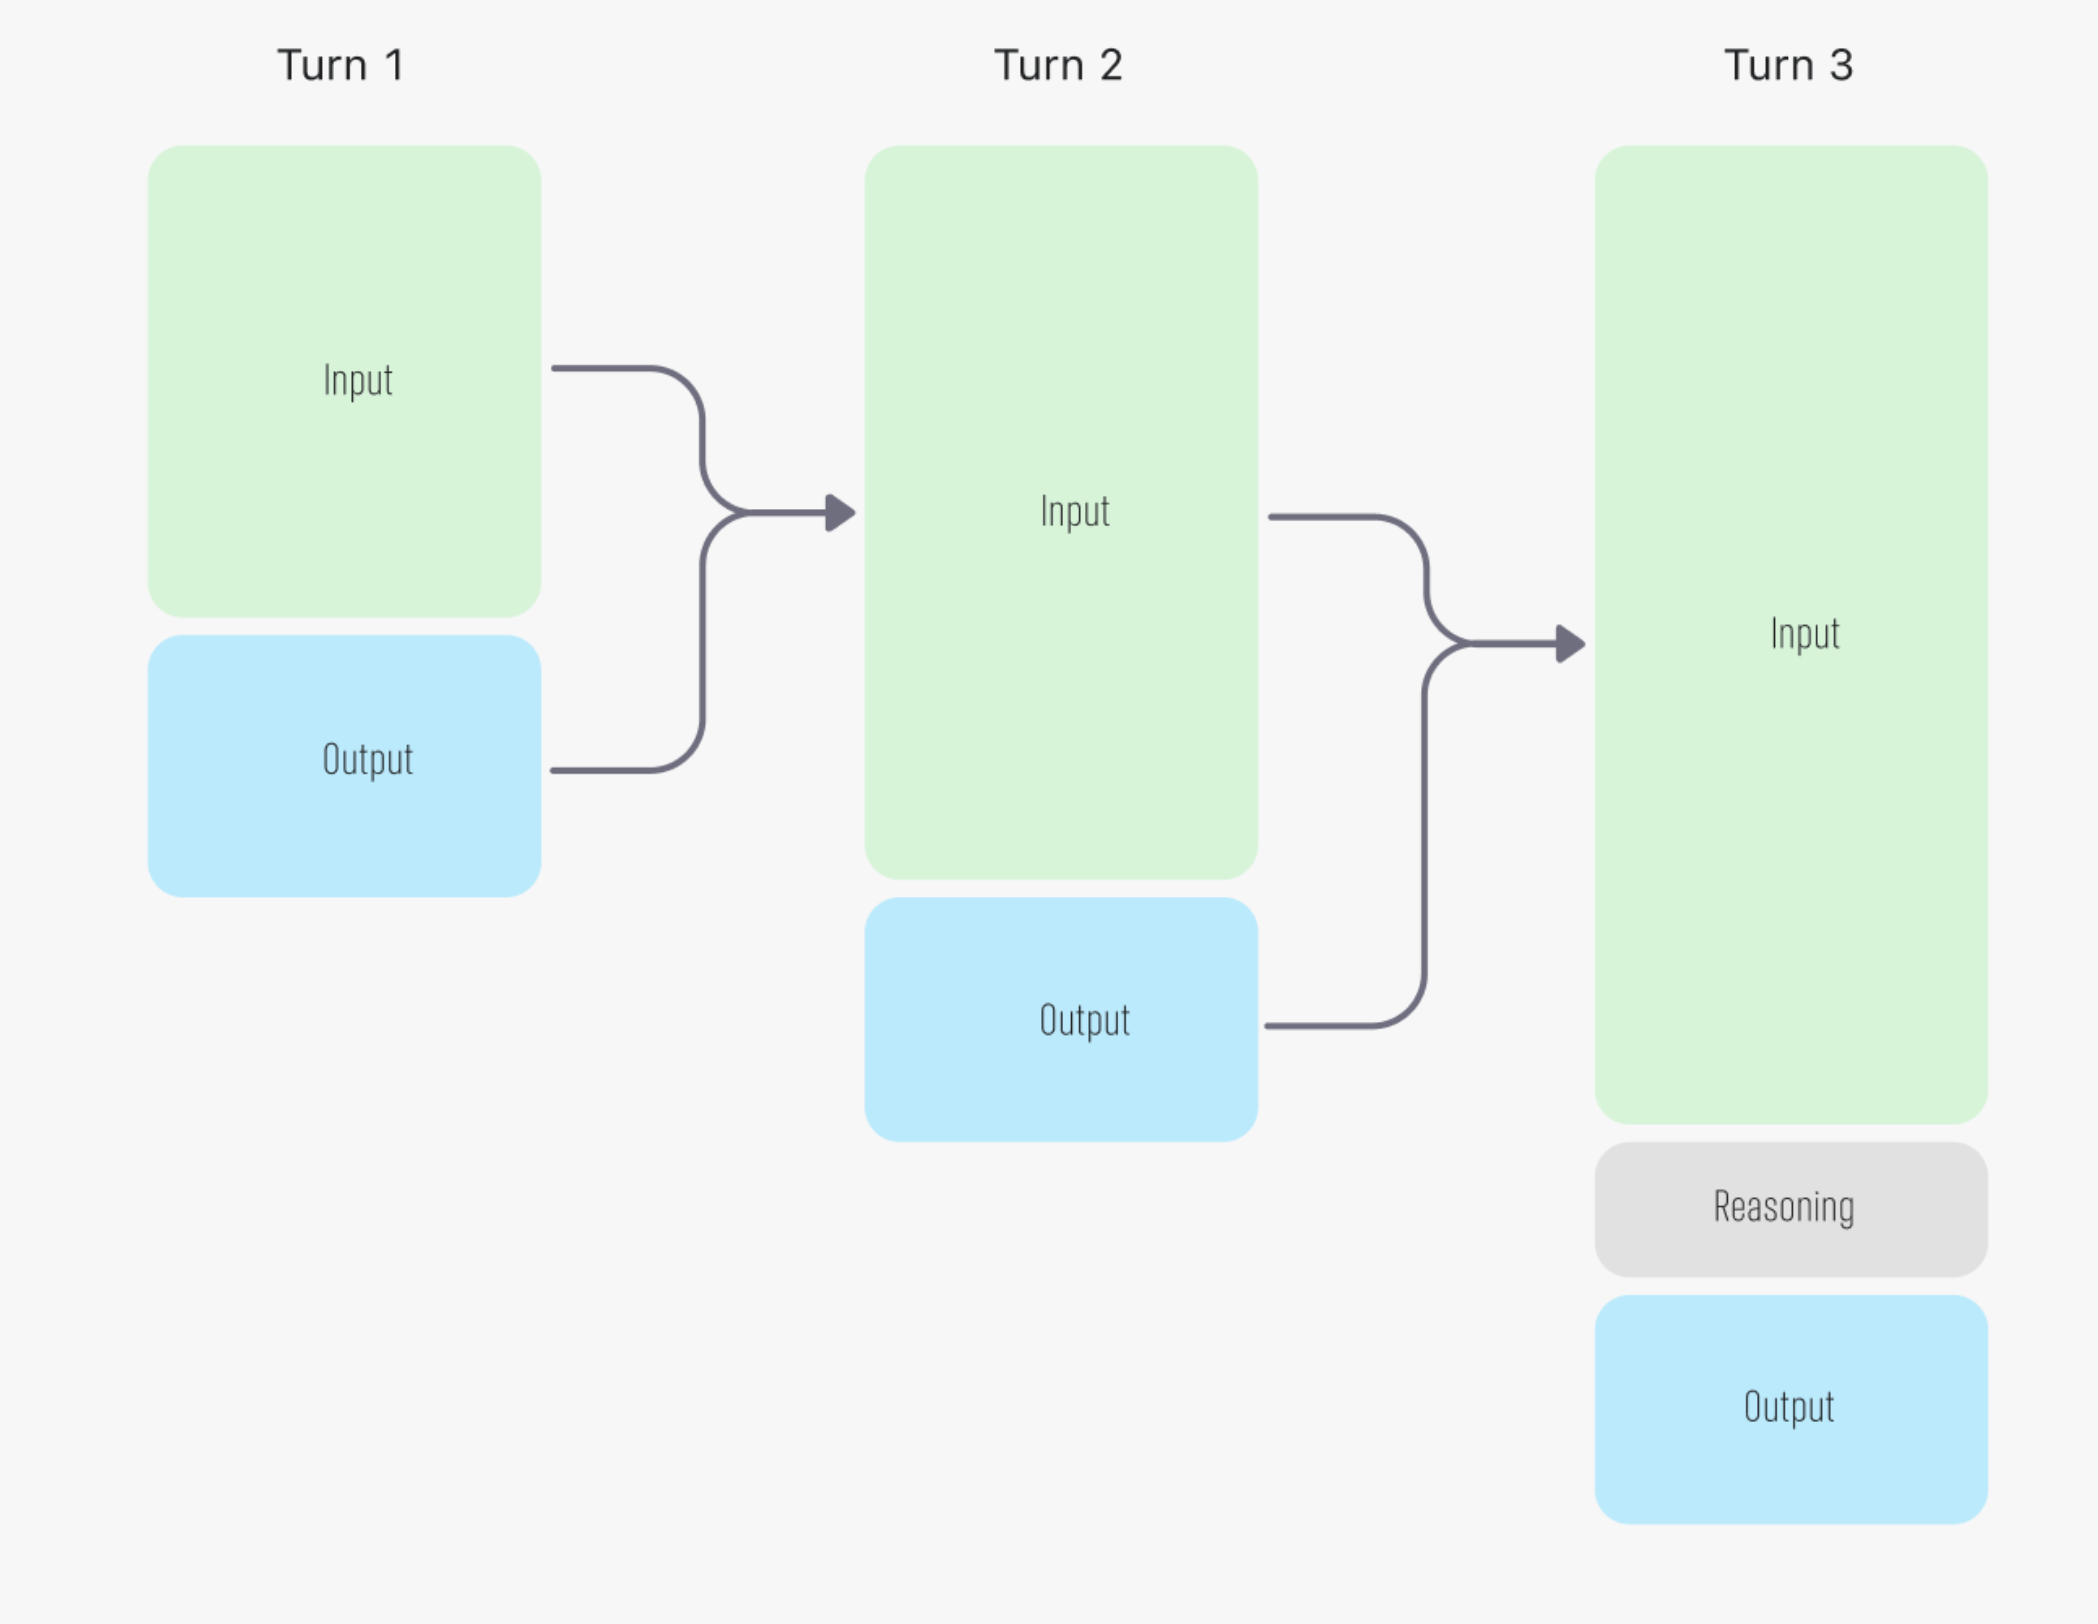 图表摘自我们的文档
让我们检查一下返回的响应对象:
from openai import OpenAI
import os
client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
response = client.responses.create(
    model="o4-mini",
    input="tell me a joke",
)
import json

print(json.dumps(response.model_dump(), indent=2))
从响应对象的 JSON 转储中可以看到,除了 output_text 之外,模型还会生成一个推理项。该项代表模型的内部推理令牌,并以 ID 形式暴露——例如这里的 rs_6820f383d7c08191846711c5df8233bc0ac5ba57aafcbac7。由于 Responses API 是有状态的,这些推理令牌会持久化:只需在后续消息中包含它们的 ID,即可让未来的响应访问相同的推理项。如果你在多轮对话中使用 previous_response_id,模型将自动访问所有先前生成的推理项。
你还可以看到模型生成了多少推理令牌。例如,输入 10 个令牌时,响应包含 148 个输出令牌——其中 128 个是推理令牌,未显示在最终的助手消息中。
等等——图表不是显示之前的推理会被丢弃吗?那为什么在后续轮次中还要把它传回去呢?
好问题!在典型的多轮对话中,你不需要包含推理项或推理token——模型经过训练,即使没有它们也能产生最佳输出。然而,当涉及工具使用时,情况就不同了。如果某一轮包含函数调用(这可能需要API之外的额外往返),你确实需要包含推理项——要么通过previous_response_id,要么显式地将推理项添加到input中。让我们通过一个快速的函数调用示例来看看这是如何工作的。
import requests
def get_weather(latitude, longitude):
response = requests.get(f"https://api.open-meteo.com/v1/forecast?latitude={latitude}&longitude={longitude}¤t=temperature_2m,wind_speed_10m&hourly=temperature_2m,relative_humidity_2m,wind_speed_10m")
data = response.json()
return data['current']['temperature_2m']
tools = [{
"type": "function",
"name": "get_weather",
"description": "Get current temperature for provided coordinates in celsius.",
"parameters": {
"type": "object",
"properties": {
"latitude": {"type": "number"},
"longitude": {"type": "number"}
},
"required": ["latitude", "longitude"],
"additionalProperties": False
},
"strict": True
}]
context = [{"role": "user", "content": "What's the weather like in Paris today?"}]
response = client.responses.create(
model="o4-mini",
input=context,
tools=tools,
)
response.output
经过一番推理,o4-mini 模型确定需要更多信息,并调用函数来获取。我们可以调用该函数并将其输出返回给模型。关键在于,为了最大化模型的智能,我们应该通过简单地将所有输出添加回下一轮的上下文来包含推理项。
context += response.output # Add the response to the context (including the reasoning item)

tool_call = response.output[1]
args = json.loads(tool_call.arguments)


# calling the function
result = get_weather(args["latitude"], args["longitude"])

context.append({
    "type": "function_call_output",
    "call_id": tool_call.call_id,
    "output": str(result)
})

# we are calling the api again with the added function call output. Note that while this is another API call, we consider this as a single turn in the conversation.
response_2 = client.responses.create(
    model="o4-mini",
    input=context,
    tools=tools,
)

print(response_2.output_text)
虽然这个玩具示例可能无法清楚展示其好处——因为无论是否包含推理项,模型的表现可能都很好——但我们自己的测试却发现并非如此。在像 SWE-bench 这样更严格的基准测试中,包含推理项在相同的提示和设置下带来了约 3% 的提升。
缓存
如上所示,推理模型会生成推理令牌和完成令牌,API 对它们的处理方式不同。这种区别会影响缓存的工作方式,并影响性能和延迟。下图说明了这些概念:
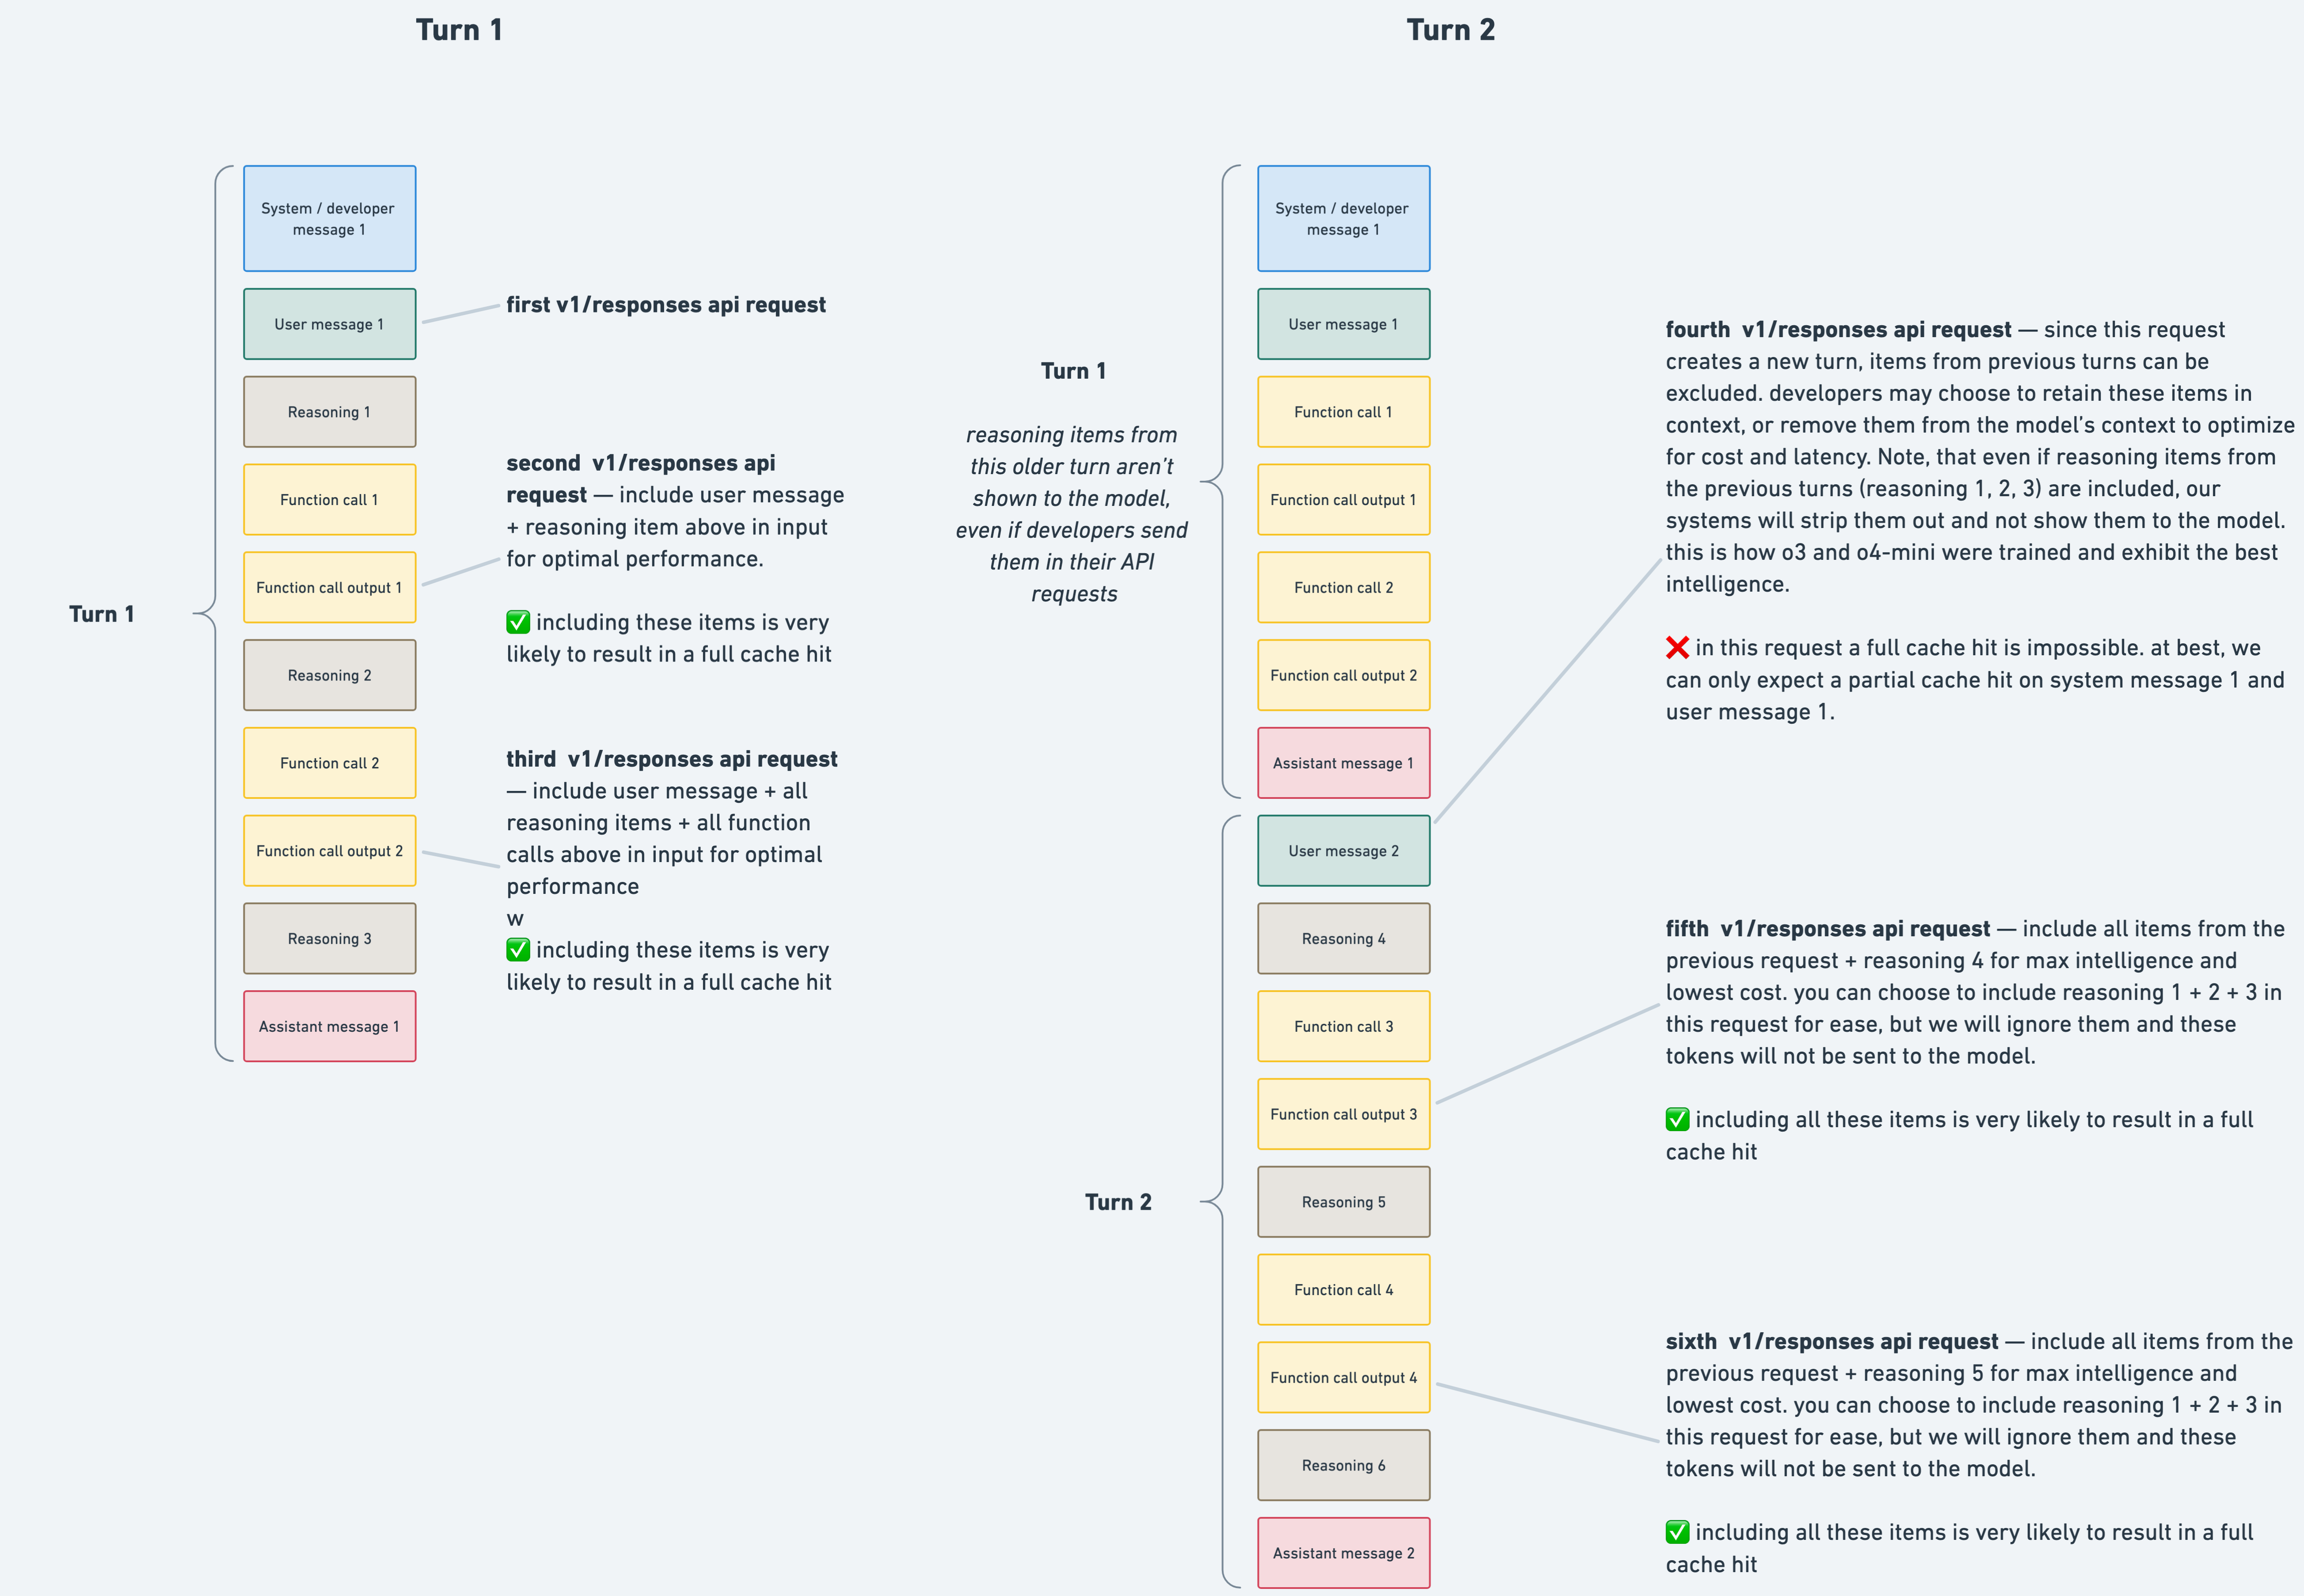
在第二轮中,第一轮的任何推理项都会被忽略并移除,因为模型不会复用前几轮的推理项。因此,图中第四次API调用无法实现完全缓存命中,因为提示中缺少这些推理项。然而,包含它们是无害的——API会简单地丢弃与当前轮次不相关的任何推理项。请记住,缓存仅影响超过1024个令牌的提示。在我们的测试中,从Completions API切换到Responses API将缓存利用率从40%提升到了80%。更高的缓存利用率会降低成本(例如,o4-mini的缓存输入令牌比未缓存的便宜75%)并改善延迟。
加密推理项
一些组织——例如有零数据保留 (ZDR) 要求的组织——由于合规或数据保留政策,无法以有状态方式使用 Responses API。为了支持这些情况,OpenAI 提供了加密推理项,允许您保持工作流无状态,同时仍然受益于推理项。
要使用加密推理项:
- 在 API 调用的
include字段中添加["reasoning.encrypted_content"]。 - API 将返回推理令牌的加密版本,您可以像常规推理项一样在后续请求中传回。
对于 ZDR 组织,OpenAI 会自动强制 store=false。当请求包含 encrypted_content 时,它会在内存中解密(从不写入磁盘),用于生成下一个响应,然后安全丢弃。任何新的推理令牌都会立即加密并返回给您,确保不会持久化任何中间状态。
以下是一个快速代码更新,以展示其工作原理:
context = [{"role": "user", "content": "What's the weather like in Paris today?"}]

response = client.responses.create(
    model="o3",
    input=context,
    tools=tools,
    store=False, #store=false, just like how ZDR is enforced
    include=["reasoning.encrypted_content"] # Encrypted chain of thought is passed back in the response
)
# take a look at the encrypted reasoning item
print(response.output[0])
设置 include=["reasoning.encrypted_content"] 后,我们现在可以看到返回的推理项中有一个 encrypted_content 字段。这个加密内容代表了模型的推理状态,完全在客户端持久化,OpenAI 不保留任何数据。然后我们可以像之前处理推理项一样将其传递回去。
context += response.output # Add the response to the context (including the encrypted chain of thought)
tool_call = response.output[1]
args = json.loads(tool_call.arguments)


result = 20 #mocking the result of the function call

context.append({
    "type": "function_call_output",
    "call_id": tool_call.call_id,
    "output": str(result)
})

response_2 = client.responses.create(
    model="o3",
    input=context,
    tools=tools,
    store=False,
    include=["reasoning.encrypted_content"]
)

print(response_2.output_text)
只需对 include 字段做一处简单修改,我们现在就能返回加密的推理项,并利用它来提升模型在智能、成本和延迟方面的性能。
现在,你应该已经掌握了充分利用我们最新推理模型所需的知识!
推理摘要
Responses API 中的另一个有用功能是支持推理摘要。虽然我们不暴露原始的思维链令牌,但用户可以访问其摘要。
# Make a hard call to o3 with reasoning summary included

response = client.responses.create(
    model="o3",
    input="What are the main differences between photosynthesis and cellular respiration?",
    reasoning={"summary": "auto"},


)

# Extract the first reasoning summary text from the response object
first_reasoning_item = response.output[0]  # Should be a ResponseReasoningItem
first_summary_text = first_reasoning_item.summary[0].text if first_reasoning_item.summary else None
print("First reasoning summary text:\n", first_summary_text)
推理摘要文本让您能够向用户展示模型的思考过程。例如,在包含多个函数调用的对话中,用户可以看到调用了哪些函数以及每次调用背后的推理,而无需等待最终的助手消息。这为您的应用程序用户体验增添了透明度和互动性。
结论
通过利用 OpenAI Responses API 和最新的推理模型,您可以在应用中释放更高的智能、提升透明度并提高效率。无论您是使用推理摘要、用于合规的加密推理项,还是优化成本和延迟,这些工具都能帮助您构建更强大、更具交互性的 AI 体验。
祝您构建愉快!
常见问题
常见错误:1) 忘记在后续请求中包含推理项,导致模型失去上下文,性能下降。解决:使用 previous_response_id 或手动追加 response.output。2) 在工具调用后未正确传递 function_call_output,导致模型无法获取工具结果。解决:确保 call_id 匹配,并正确构造输出。3) 缓存未生效,可能因为提示长度不足 1024 令牌或推理项被丢弃。解决:检查提示长度,确保包含推理项。4) 加密推理项使用错误,未设置 store=false 或 include 字段。解决:按文档设置。5) 推理摘要提取失败,可能因为 summary 字段为空。解决:检查模型是否支持摘要,并设置 reasoning={"summary": "auto"}。生产环境优化:使用流式响应减少延迟;批量处理工具调用;监控 token 使用和缓存命中率;根据任务复杂度选择模型(o3 vs o4-mini)。
企业应用扩展
进一步探索:1) 结合函数调用与多工具编排,构建复杂智能体;2) 利用推理摘要实现用户可解释的决策过程;3) 在合规场景中部署加密推理项,确保数据主权;4) 优化缓存策略,通过提示工程提高缓存命中率;5) 集成评估框架(如 SWE-bench)量化推理项带来的性能提升;6) 探索 Responses API 的未来增强功能,如流式推理和更细粒度的控制。
总结
本文深入探讨如何通过 OpenAI Responses API 最大化 o3 和 o4-mini 等推理模型的性能。核心在于利用 API 的有状态特性,在工具调用场景中保留并传递推理项,从而提升模型智能(如 SWE-bench 提升 3%)。同时介绍缓存优化(缓存利用率从 40% 提升至 80%)、加密推理项(满足零数据保留合规)和推理摘要(增强透明度)。面向有编程基础的开发者,提供代码示例、架构分析和生产实践建议。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:中级
- 验证等级:V1
- 原文作者:billchen-openai
- 原文日期:2025-05-11
- 来源许可:MIT
- 来源版本:
19e0de628400cf514f5d06119a43e82f1e39354c - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员