构建你自己的代码解释器:使用o3-mini动态生成与执行工具
技术背景
传统工具调用需要预定义函数,限制了LLM处理新问题的能力。动态工具生成允许模型在运行时创建代码,适用于数据分析、自动化等场景。o3-mini模型在STEM任务上表现优异,且成本低。构建自定义解释器可解决内置解释器的语言限制、成本、集成等问题。
核心原理
核心原理是让LLM(o3-mini)根据用户问题生成Python代码,并在隔离的Docker容器中执行。模型通过推理生成代码,无需显式思维链。代码执行环境限制网络和文件系统访问,确保安全。代理通过工具接口调用执行,实现动态工具调用。
架构分析
系统由三个组件构成:Docker容器环境、两个代理(FileAccessAgent和PythonExecAgent)、编排循环。核心类包括BaseAgent、ChatMessages、ToolManager、ToolInterface,采用面向对象设计,确保接口一致性和可扩展性。FileAccessAgent负责读取文件,PythonExecAgent负责生成并执行代码,两者分离以隔离权限。
完整实战教程
构建你自己的代码解释器:使用o3-mini动态生成与执行工具
在赋予LLM代理与外部世界或其他代理交互能力的核心是“工具(或函数)调用”,即LLM可以调用带有参数的函数(代码块)。通常,这些函数及其预期输入和输出由开发者预先定义。然而,在本教程中,我们探索一种更灵活的范式——使用LLM模型(此处为o3-mini)动态生成工具,并能够使用代码解释器执行该工具。
使用代码解释器动态生成工具调用
动态生成工具是由LLM本身在运行时根据用户提示创建的函数或代码块。这意味着你不必在代码库中预定义每种可能的情况——从而实现更开放、更具创造性和适应性的问题解决。
动态生成工具调用更进一步,赋予LLM即时生成工具和执行代码块的能力。这种动态方法对于涉及以下任务特别有用:
- 数据分析和可视化
- 数据操作和转换
- 机器学习工作流的生成和执行
- 流程自动化和脚本编写
- 以及更多,随着实验不断涌现的新可能性
使用o3-mini进行动态工具生成
o3-mini模型于2025年1月31日发布,具有卓越的STEM能力——尤其在科学、数学和编码方面表现出色——同时保持了较小模型的低成本和低延迟。在本教程中,我们将展示o3-mini生成Python代码以解释数据和提取见解的能力。
推理模型特别擅长生成动态工具来分析数据,因为它们可以自行推理,无需显式的思维链提示。事实上,提供显式的思维链指令可能会干扰模型的内部推理,导致次优结果。你可以在此了解更多关于o3-mini的信息。
为什么构建你自己的代码解释器
许多API提供商(如OpenAI的Assistants API)提供内置的代码解释器功能。这些内置的代码解释器可能非常强大,但在某些情况下,开发者可能需要创建自己的自定义代码解释器。例如:
- 语言或库支持:内置解释器可能不支持你的任务所需的特定编程语言(例如C++、Java等)或库。
- 任务兼容性:你的用例可能与提供商的内置解决方案不兼容。
- 模型约束:你可能需要提供商解释器不支持的语言模型。
- 成本考虑:代码执行或模型使用的成本结构可能不符合你的预算或约束。
- 文件大小:输入数据的文件大小过大或不受提供商解释器支持。
- 与内部系统集成:提供商的解释器可能无法与你的内部系统集成。
你将学到什么
通过遵循本教程,你将学习如何:
- 使用 Docker 搭建隔离的 Python 代码执行环境
- 为 LLM 代理配置你自己的代码解释器工具
- 建立清晰的“代理”关注点分离,确保安全
- 使用 o3-mini 模型动态生成数据分析代码
- 编排代理以高效完成给定任务
- 设计一个能够动态生成并执行代码的代理应用
你将学习如何从零开始构建自定义代码解释器工具,利用 LLM 的强大能力生成复杂代码,并在隔离环境中安全执行这些代码——所有这一切都是为了让你的人工智能应用更加灵活、强大且成本效益更高。
示例场景
我们将使用 Key Factors Traffic Accidents 提供的示例数据来回答一系列问题。这些问题不需要预先定义,我们将赋予 LLM 生成代码以回答此类问题的能力。
示例问题可能包括:
- 哪些因素对事故频率的影响最大?(特征重要性分析)
- 哪些地区的事故风险最高?(分类/聚类)
- 交通罚款金额如何影响事故数量?(回归/因果推断)
- 我们能否确定最优罚款金额以降低事故率?(优化模型)
- 更高的罚款是否与较低的平均速度或减少的事故相关?(相关性/回归)
- 等等……
使用传统的预定义工具调用方法,开发人员需要为每个问题预先定义函数。这限制了 LLM 回答预定义函数集之外任何其他问题的能力。我们通过使用动态工具调用方法克服了这一限制,其中 LLM 生成代码并使用代码解释器工具执行代码。
概述
让我们深入了解构建这个具有动态生成工具调用的 Agentic 应用程序的步骤。该应用程序包含三个组件:
步骤 1:设置隔离的代码执行容器环境
我们需要一个安全的环境,让 LLM 生成的函数调用可以在其中执行。我们希望避免直接在主机上运行 LLM 生成的代码,因此将创建一个资源访问受限(例如,无网络访问)的 Docker 容器环境。默认情况下,Docker 容器无法访问主机的文件系统,这有助于确保 LLM 生成的任何代码都被限制在容器内。
##### ⚠️ 警告:为 LLM 生成的代码实施强有力的防护措施
LLM 可能生成具有意外后果的有害代码。作为最佳实践,请隔离代码执行环境,仅按任务需要授予必要的资源访问权限。避免在主机或笔记本电脑上运行 LLM 生成的代码。
步骤 2:定义并测试代理
“什么是代理?”在本 Cookbook 的上下文中,代理是:
- 一组供 LLM 遵循的指令,即开发者提示词
- 一个 LLM 模型,以及通过 API 调用模型的能力
- 对函数的工具调用访问权限,以及执行该函数的能力
我们将定义两个代理:
- FileAccessAgent:此代理将读取文件,并向 PythonCodeExecAgent 提供上下文。
- PythonCodeExecAgent:此代理将生成 Python 代码来回答用户的问题,并在 Docker 容器中执行代码。
步骤 3:设置代理编排以运行应用程序
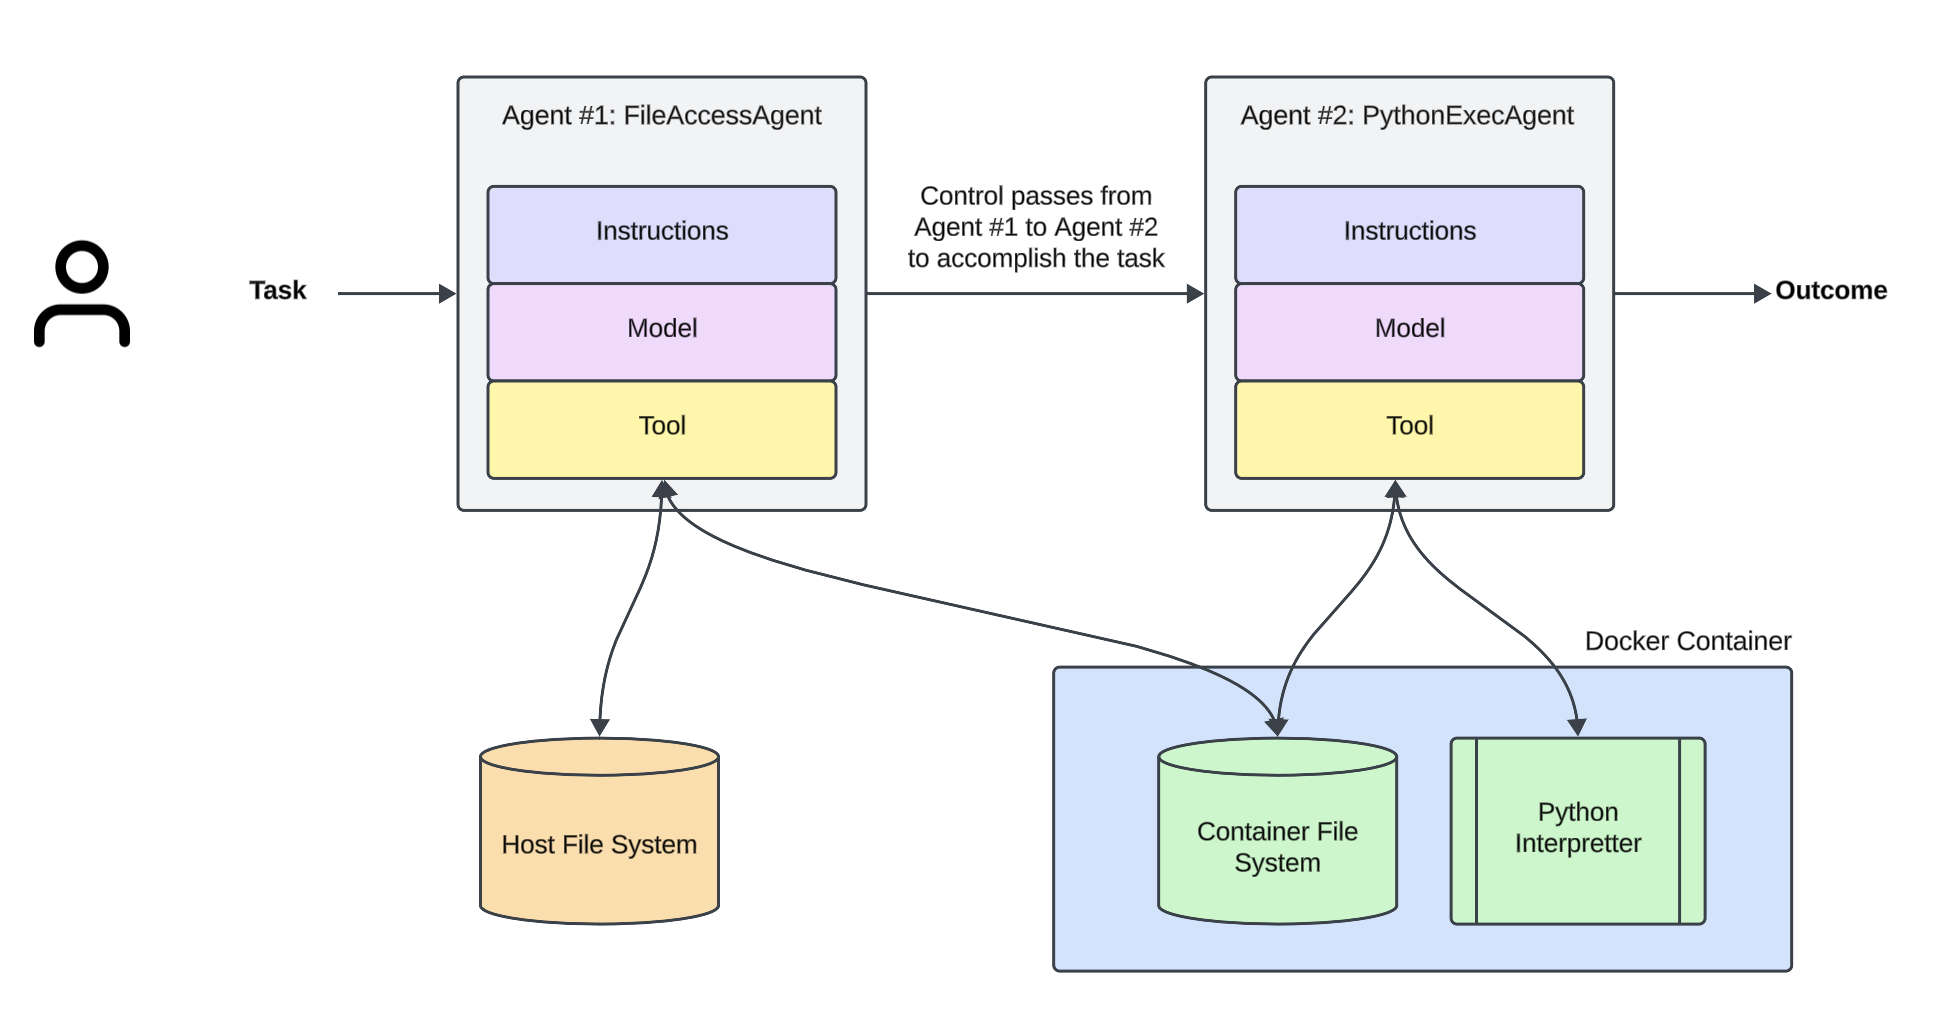
根据应用程序需求,有多种编排代理的方式。在此示例中,我们将使用简单的编排,用户提供任务,代理按顺序调用以完成任务。
整体编排如下所示:
让我们开始吧
前提条件
在开始之前,请确保您的宿主机上已安装并配置以下内容:
- Docker:已在本地机器上安装并运行。您可以了解更多关于 Docker 的信息并从此处安装。
- Python:已在本地机器上安装。您可以了解更多关于 Python 的信息并从此处安装。
- OpenAI API 密钥:已在本地机器上设置为环境变量,或位于根目录的 .env 文件中。您可以了解更多关于 OpenAI API 密钥的信息并从此处设置。
步骤 1:设置隔离的代码执行环境
让我们定义一个 Docker 化容器环境,用于执行我们的代码。我在 resources/docker 目录下定义了 dockerfile,它将用于创建具有以下规格的容器环境:
- 以 Python 3.10 为基础
- 非 root 用户
- 预安装 requirements.txt 中的包
Docker 镜像创建过程中包含的 requirements.txt 包含了我们的 LLM 生成的代码可能需要的所有潜在包,以完成其任务。由于我们将限制容器访问网络,因此需要预安装任务所需的包。出于安全目的,我们的 LLM 将不允许安装任何额外的包。
您可以创建自己的 Docker 镜像,包含所需的语言(如 Python 3.10)并预安装任务所需的包,或者创建自定义 Docker 镜像,包含特定语言(如 Java、C++ 等)和任务所需的包。
让我们用以下命令构建 Docker 镜像。为简洁起见,我将输出重定向到 grep 以获取成功消息,并在构建失败时打印一条消息。
!docker build -t python_sandbox:latest ./resources/docker 2>&1 | grep -E "View build details|ERROR" || echo "Build failed."
让我们以受限模式运行容器。容器将在后台运行。这是我们为容器定义安全策略的机会。良好的实践是仅允许容器具备完成任务所需的最基本功能。默认情况下,容器无法从容器内部访问主机文件系统。我们还要限制其对网络的访问,使其无法访问互联网或任何其他网络资源。
# Run the container in restricted mode. The container will run in the background.
!docker run -d --name sandbox --network none --cap-drop all --pids-limit 64 --tmpfs /tmp:rw,size=64M   python_sandbox:latest sleep infinity
让我们使用 docker ps 确认容器正在运行,该命令应列出我们的容器。
!docker ps
步骤 2:定义并测试智能体
为了我们的目的,我们将定义两个智能体。
- 智能体 1:文件访问智能体(使用预定义工具调用)
- 指令:理解文件内容,为智能体 2 提供上下文。
- 可以访问宿主机的文件系统。
- 可以从宿主机读取文件并将其复制到 Docker 容器中。
- 不能访问代码解释器工具。
- 使用 gpt-4o 模型。
- 智能体 2:Python 代码生成与执行智能体(使用动态生成的工具调用和代码执行)
- 从智能体 1 接收文件内容的上下文。
- 指令:生成 Python 脚本来回答用户的问题。
- 可以访问 Docker 容器内的代码解释器,用于执行 Python 代码。
- 只能访问 Docker 容器内的文件系统(不能访问宿主机)。
- 不能访问宿主机的文件系统或网络。
- 使用我们最新的 o3-mini 模型,该模型擅长代码生成。
这种将文件访问(智能体 1)与代码生成和执行(智能体 2)分离的做法至关重要,可以防止 LLM 直接访问或修改宿主机。
将智能体 1 限制为静态工具调用,因为它可以访问宿主机的文件系统。
| 智能体 | 工具调用类型 | 访问宿主机文件系统 | 访问 Docker 容器文件系统 | 访问代码解释器 |
|-------|--------------|--------------------|--------------------------|----------------|
| 智能体 1:文件访问 | 预定义工具 | 是 | 是 | 否 |
| 智能体 2:Python 代码生成与执行 | 动态生成工具 | 否 | 是 | 是 |
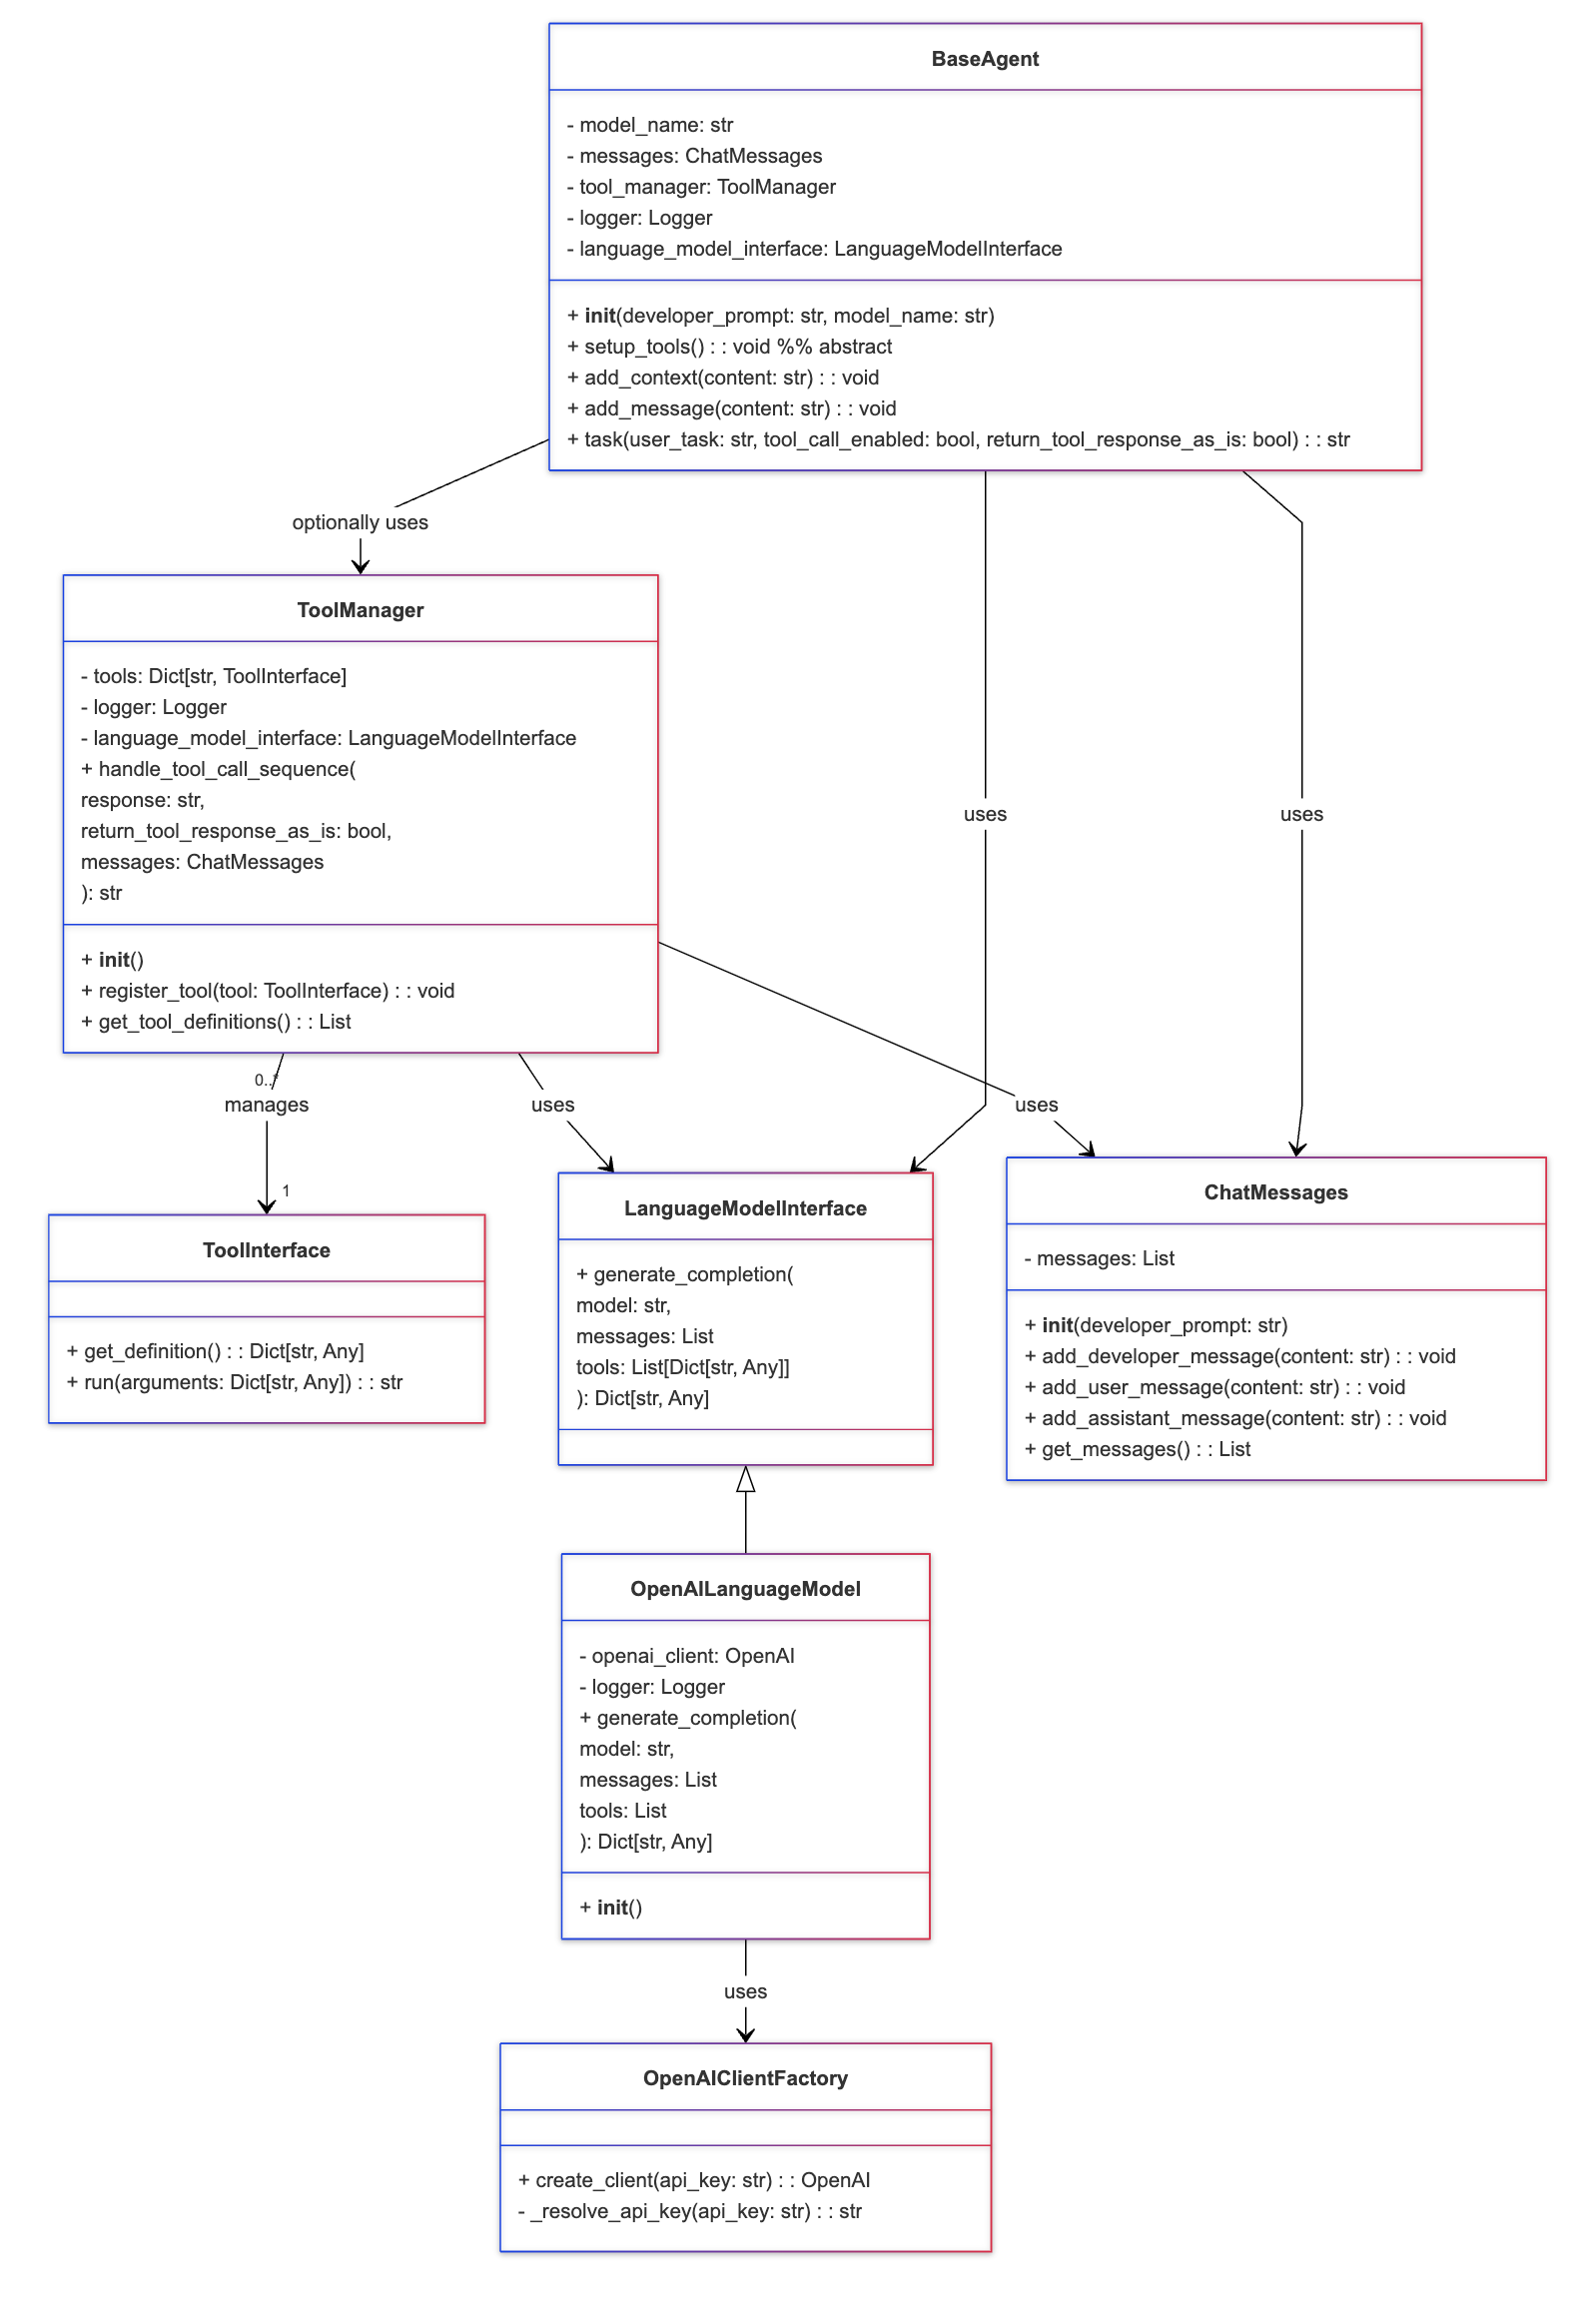
为了保持 Agents 和 Tools 的组织性,我们定义了一组核心类,用于使用面向对象编程原则创建两个代理,以保证一致性。
- BaseAgent:我们从一个抽象基类开始,它强制执行常见的方法签名,如
task()。基类还提供了用于调试的日志记录器、语言模型接口以及其他常见功能,如add_context()用于向代理添加上下文。 - ChatMessages:一个用于存储对话历史的类,因为 ChatCompletions API 是无状态的。
- ToolManager:一个用于管理代理可以调用的工具的类。
- ToolInterface:一个抽象类,用于代理可以调用的任何“工具”,以便工具具有一致的接口。
这些类定义在 object_oriented_agents/core_classes 目录中。
核心类的 UML 类图
以下类图展示了核心类之间的关系。该 UML(统一建模语言)图是使用 Mermaid 生成的。
定义 Agent 1:带有 FileAccessTool 的 FileAccessAgent
让我们从定义继承自 ToolInterface 类的 FileAccessTool 开始。FileAccessTool 工具定义在 resources/registry/tools 目录下的 file_access_tool.py 文件中。
- FileAccessTool 实现了 ToolInterface 类,这确保了工具将具有一致的接口。
- 在
get_definition方法中绑定 OpenAI 函数调用 API 的工具定义,并在工具的run方法中实现执行逻辑,确保了可维护性、可扩展性和可重用性。
现在,让我们定义FileAccessAgent,它继承自BaseAgent类,并将FileAccessTool绑定到该代理。FileAccessAgent定义在resources/registry/agents目录下的file_access_agent.py文件中。FileAccessAgent是:
- BaseAgent类的具体实现。
- 使用开发者提示词、模型名称、日志记录器和语言模型接口进行初始化。这些值可以由开发者根据需要覆盖。
- 有一个setup_tools方法,将FileAccessTool注册到工具管理器。
- 有一个
task方法,调用FileAccessTool读取文件,并将上下文提供给PythonCodeExecAgent。 model_name='gpt-4o',为任务提供足够的推理和工具调用能力。
定义 Agent 2:带 PythonExecTool 的 PythonExecAgent
类似地,PythonExecTool 继承自 ToolInterface 类,并实现了 get_definition 和 run 方法。get_definition 方法返回符合 OpenAI 函数调用 API 格式的工具定义。run 方法在 Docker 容器中执行 Python 代码并返回输出。该工具定义在 resources/registry/tools 目录下的 python_code_interpreter_tool.py 文件中。
同样,PythonExecAgent 是 BaseAgent 类的具体实现。它定义在 resources/registry/agents 目录下的 python_code_exec_agent.py 文件中。PythonExecAgent 具有以下特点:
- 是 BaseAgent 类的具体实现。
- 使用开发者提示词、模型名称、日志记录器和语言模型接口进行初始化。这些值可以由开发者根据需要覆盖。
- 有一个 setup_tools 方法,将 PythonExecTool 注册到工具管理器。
- 有一个
task方法,调用 OpenAI API 来执行用户的任务,在这种情况下,涉及生成一个 Python 脚本来回答用户的问题,并使用代码解释器工具运行它。 model_name='o3-mini',擅长代码生成等 STEM 任务。reasoning_effort='high',考虑到任务的复杂性,允许更完整的推理,但代价是生成更多 token 和更慢的响应。默认值为 medium,在速度和推理准确性之间取得平衡。
您可以在此处了解更多关于 reasoning_effort 参数的信息:这里。
步骤 3:设置代理编排以运行应用程序
定义好代理后,现在我们可以定义运行应用程序的编排循环。该循环将提示用户输入问题或任务,然后调用 FileAccessAgent 读取文件并将上下文提供给 PythonExecAgent。PythonExecAgent 将生成 Python 代码来回答用户的问题,并在 Docker 容器中执行代码。代码执行的输出将显示给用户。
用户可以输入 'exit' 来停止应用程序。我们的问题是:哪些因素对事故频率的影响最大? 请注意,我们并未预先定义回答此问题的函数。
# Import the agents from registry/agents

from resources.registry.agents.file_access_agent import FileAccessAgent
from resources.registry.agents.python_code_exec_agent import PythonExecAgent


prompt = """Use the file traffic_accidents.csv for your analysis. The column names are:
Variable    Description
accidents    Number of recorded accidents, as a positive integer.
traffic_fine_amount    Traffic fine amount, expressed in thousands of USD.
traffic_density    Traffic density index, scale from 0 (low) to 10 (high).
traffic_lights    Proportion of traffic lights in the area (0 to 1).
pavement_quality    Pavement quality, scale from 0 (very poor) to 5 (excellent).
urban_area    Urban area (1) or rural area (0), as an integer.
average_speed    Average speed of vehicles in km/h.
rain_intensity    Rain intensity, scale from 0 (no rain) to 3 (heavy rain).
vehicle_count    Estimated number of vehicles, in thousands, as an integer.
time_of_day    Time of day in 24-hour format (0 to 24).
accidents    traffic_fine_amount
"""


print("Setup: ")
print(prompt)

print("Setting up the agents... ")

# Instantiate the agents with the default constructor defined values
# Developer may override the default values - prompt, model, logger, and language model interface if needed

# This agent use gpt-4o by default
file_ingestion_agent = FileAccessAgent()

# Let's make sure agent uses o3-mini model and set the reasoning_effort to high
data_analysis_agent = PythonExecAgent(model_name='o3-mini', reasoning_effort='high')

print("Understanding the contents of the file...")
# Give a task to the file ingestion agent to read the file and provide the context to the data analysis agent
file_ingestion_agent_output = file_ingestion_agent.task(prompt)

# Add the file content as context to the data analysis agent
# The context is added to the agent's tool manager so that the tool manager can use the context to generate the code

data_analysis_agent.add_context(prompt)
data_analysis_agent.add_context(file_ingestion_agent_output)

while True:

    print("Type your question related to the data in the file. Type 'exit' to exit.")
    user_input = input("Type your question.")

    if user_input == "exit":
        print("Exiting the application.")
        break

    print(f"User question: {user_input}")

    print("Generating dynamic tools and using code interpreter...")
    data_analysis_agent_output = data_analysis_agent.task(user_input)

    print("Output...")
    print(data_analysis_agent_output)
在此示例中,o3-mini 根据用户的问题动态生成了一个工具(Python 脚本)来分析数据。请注意,o3-mini 使用了多种方法(如相关性分析、线性回归和随机森林模型)来检查问题。这种方法突出了以下几点:
reasoning_effort:模型执行的推理深度(例如,在此案例中为方法的数量)通常随着参数从低、中到高而增加。您可以尝试不同级别的推理努力来查看差异。
动态生成的工具调用:用于分析数据的工具(Python 脚本)并非由开发人员手动编写或预先确定。相反,o3-mini 模型在运行时创建了相关的数据探索和相关性分析代码。
隔离的代码执行:为了确保安全性并避免在主机上运行不受信任的代码,Python 脚本通过 execute_python_code 工具在 Docker 容器内执行。该容器具有受限的资源访问权限(例如,无网络和有限的文件系统访问),从而最大限度地降低了任意代码执行带来的潜在风险。
结论
本Cookbook为开发自定义代码解释器提供了指南,以满足特定应用需求,解决了供应商提供的解决方案中的局限性,如语言限制、成本考虑以及需要与不同LLM或模型灵活配合的问题。
管理代理和工具的方法:我们还定义了一组核心类来管理代理和工具。这种方法确保了代理和工具具有一致的接口,并且可以在不同应用中重用。可以创建代理和工具的资源库,例如registry文件夹,来管理这些代理和工具。
o3-mini模型:我们展示了o3-mini模型在运行时根据用户极简提示生成复杂代码来分析数据的能力。然后,o3-mini模型对分析结果进行推理,向用户解释结果。
最后,回顾一下,构建具有动态工具调用的代理应用的三个步骤是:
- 设置隔离的代码执行容器环境
- 定义并测试代理
- 设置代理编排以运行应用
我们讨论了隔离代码执行环境的重要性,以确保安全性,避免在主机上运行不受信任的代码。通过CSV文件的用例,我们演示了如何动态生成工具(Python脚本)来分析数据并回答用户的问题。我们还展示了如何在Docker容器中执行代码并将输出返回给用户。
常见问题
常见错误包括:Docker未启动或镜像构建失败;容器未运行或网络限制导致包缺失;API密钥未设置;模型参数配置不当。排查方法:检查docker ps、构建日志、环境变量;确保容器内预装所需包;调整reasoning_effort参数。生产优化:使用更安全的沙箱(如gVisor)、资源限制、日志监控、缓存机制。
企业应用扩展
可扩展方向:支持更多语言(Java、C++等);集成更多工具(如数据库访问);实现多代理协作;添加代码审查和错误处理;优化模型选择(如gpt-4o-mini);部署为微服务;增加用户界面。
总结
本教程面向有编程基础的开发者,深入讲解如何构建自定义代码解释器,利用o3-mini模型动态生成并执行Python代码。通过Docker隔离环境、面向对象的代理设计,实现安全、灵活的数据分析。教程涵盖环境搭建、代理定义、编排流程,并分析核心原理与架构,提供常见错误排查与生产优化建议。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:中级
- 验证等级:V1
- 原文作者:msingh-openai
- 原文日期:2025-02-03
- 来源许可:MIT
- 来源版本:
45b58c47bbc14e77a55f93c6909e2a8d44b32b62 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员