使用嵌入向量对文本进行分类:Google Colab 教程
技术背景
传统文本分类依赖词袋、TF-IDF 等稀疏特征,难以捕捉语义相似性,且需要大量特征工程。嵌入向量将文本映射为稠密语义向量,使语义相近的文本在向量空间中距离更近,从而让简单分类器也能获得良好效果。Gemini 嵌入模型提供 CLASSIFICATION、CLUSTERING、SEMANTIC_SIMILARITY、RETRIEVAL_QUERY、RETRIEVAL_DOCUMENT 等任务类型,针对不同下游目标优化向量分布。本教程解决的核心问题是:如何以工程化方式把大模型嵌入服务接入经典机器学习流水线,并在有限算力下完成可评估、可复现的文本分类。适用场景包括新闻分类、工单路由、内容审核、意图识别等;主要限制是嵌入 API 有速率与计费约束、不同模型向量空间不兼容、长文本需截断、嵌入质量受任务类型选择影响。
核心原理
核心数据流为:原始文本 → 清洗与截断 → 按任务类型调用嵌入 API → 得到固定维度向量 → 堆叠为特征矩阵 → 训练 Keras 分类头 → 评估。嵌入模型本质是一个编码器,把离散 token 序列压缩为语义向量;CLASSIFICATION 任务类型会引导模型生成更适合线性可分分类的表示。分类头采用两层 Dense:第一层以 ReLU 做非线性变换,第二层以 softmax 输出各类别概率,损失使用 SparseCategoricalCrossentropy。关键设计决策包括:嵌入只计算一次并缓存到 DataFrame,避免每轮重复调用 API;批量大小设为 25 以匹配 API 单批上限;使用 EarlyStopping 监控 accuracy 并设 patience=3 抑制过拟合;训练前用 np.stack 将嵌入列表转为二维数组。不同嵌入模型输出维度与语义空间不同,因此必须固定 MODEL_ID,不能混用。
架构分析
系统分为四层。数据层:fetch_20newsgroups 加载训练/测试集,preprocess_newsgroup_data 用正则去除邮箱、括号姓名、From: 与 Subject: 前缀,并截断到 5000 字符,再写入 Pandas DataFrame。采样层:sample_data 按 Label 分组抽样,保留含 sci 的类别,重编码标签为 Encoded Label,保证类别平衡且规模可控。嵌入层:make_embed_text_fn 封装 client.models.embed_content,create_embeddings 按 batch_size=25 分块调用并收集向量,结果存入 Embeddings 列。模型层:build_classification_model 构建 Input→Dense(input_size, relu)→Dense(num_classes, softmax),编译后以 Adam(0.001) 训练,并用 plot_history 与混淆矩阵做可视化评估。该架构把昂贵的嵌入计算与廉价的分类训练解耦,便于替换嵌入模型或分类头。
完整实战教程
##### 版权所有 2026 Google LLC。
# @title Licensed under the Apache License, Version 2.0 (the "License");
# you may not use this file except in compliance with the License.
# You may obtain a copy of the License at
#
# https://www.apache.org/licenses/LICENSE-2.0
#
# Unless required by applicable law or agreed to in writing, software
# distributed under the License is distributed on an "AS IS" BASIS,
# WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
# See the License for the specific language governing permissions and
# limitations under the License.
使用嵌入对文本进行分类

注意: 本笔记本需要付费层级的速率限制才能正常运行。(更多详情请参阅定价)。
概述
在本笔记本中,你将学习使用 Gemini API 生成的嵌入来训练一个模型,该模型可以根据主题对不同类型的新闻组帖子进行分类。
%pip install -U -q google-genai
获取 API 密钥
在使用 Gemini API 之前,你必须先获取一个 API 密钥。如果你还没有,可以在 Google AI Studio 中一键创建密钥。
<a class="button button-primary" href="https://aistudio.google.com/app/apikey" target="_blank" rel="noopener noreferrer">获取 API 密钥</a>
在 Colab 中,将密钥添加到左侧面板“🔑”下的密钥管理器中。将其命名为 GEMINI_API_KEY。
获取 API 密钥后,将其传递给 SDK。你可以通过两种方式完成:
* 将密钥放入 GEMINI_API_KEY 环境变量中(SDK 会自动从那里读取)。
* 将密钥传递给 genai.Client(api_key=...)
from google import genai
from google.genai import types

# Used to securely store your API key
from google.colab import userdata

# Or use `os.getenv('GEMINI_API_KEY')` to fetch an environment variable.
GEMINI_API_KEY=userdata.get('GEMINI_API_KEY')

client = genai.Client(api_key=GEMINI_API_KEY)
关键点:接下来,你需要选择一个模型。任何嵌入模型都适用于本教程,但在实际应用中,重要的是选择一个特定的模型并坚持使用。不同模型的输出彼此不兼容。
for m in client.models.list():
  if 'embedContent' in m.supported_actions:
    print(m.name)
选择要使用的模型
MODEL_ID = "gemini-embedding-001" # @param ["gemini-embedding-2-preview", "gemini-embedding-001"] {"allow-input":true, isTemplate: true}
准备数据集
20 Newsgroups 文本数据集 包含 18,000 篇关于 20 个主题的新闻组帖子,分为训练集和测试集。训练集和测试集之间的划分基于在特定日期之前和之后发布的帖子。在本教程中,你将使用训练集和测试集的子集。你将预处理数据并将其组织到 Pandas 数据框中。
from sklearn.datasets import fetch_20newsgroups
newsgroups_train = fetch_20newsgroups(subset='train')
newsgroups_test = fetch_20newsgroups(subset='test')

# View list of class names for dataset
newsgroups_train.target_names
以下是训练集中一个数据点的示例。
idx = newsgroups_train.data[0].index('Lines')
print(newsgroups_train.data[0][idx:])
现在你将开始为本教程预处理数据。删除任何敏感信息,如姓名、电子邮件,或文本中的冗余部分,如 "From: " 和 "\nSubject: "。将信息整理到 Pandas 数据框中,使其更易读。
import re
import pandas as pd

def preprocess_newsgroup_data(newsgroup_dataset):
  # Apply functions to remove names, emails, and extraneous words from data points in newsgroups.data
  newsgroup_dataset.data = [re.sub(r'[\w\.-]+@[\w\.-]+', '', d) for d in newsgroup_dataset.data] # Remove email
  newsgroup_dataset.data = [re.sub(r"\([^()]*\)", "", d) for d in newsgroup_dataset.data] # Remove names
  newsgroup_dataset.data = [d.replace("From: ", "") for d in newsgroup_dataset.data] # Remove "From: "
  newsgroup_dataset.data = [d.replace("\nSubject: ", "") for d in newsgroup_dataset.data] # Remove "\nSubject: "

  # Cut off each text entry after 5,000 characters
  newsgroup_dataset.data = [d[0:5000] if len(d) > 5000 else d for d in newsgroup_dataset.data]

  # Put data points into dataframe
  df_processed = pd.DataFrame(newsgroup_dataset.data, columns=['Text'])
  df_processed['Label'] = newsgroup_dataset.target
  # Match label to target name index
  df_processed['Class Name'] = ''
  for idx, row in df_processed.iterrows():
    df_processed.at[idx, 'Class Name'] = newsgroup_dataset.target_names[row['Label']]

  return df_processed
# Apply preprocessing function to training and test datasets
df_train = preprocess_newsgroup_data(newsgroups_train)
df_test = preprocess_newsgroup_data(newsgroups_test)

df_train.head()
接下来,你将通过从训练数据集中抽取 100 个数据点来对部分数据进行采样,并在此教程中舍弃一些类别。选择要比较的科学类别。
def sample_data(df, num_samples, classes_to_keep):
  df = df.groupby('Label', as_index = False).apply(lambda x: x.sample(num_samples)).reset_index(drop=True)

  df = df[df['Class Name'].str.contains(classes_to_keep)]

  # Reset the encoding of the labels after sampling and dropping certain categories
  df['Class Name'] = df['Class Name'].astype('category')
  df['Encoded Label'] = df['Class Name'].cat.codes

  return df
TRAIN_NUM_SAMPLES = 100
TEST_NUM_SAMPLES = 25
CLASSES_TO_KEEP = 'sci' # Class name should contain 'sci' in it to keep science categories
df_train = sample_data(df_train, TRAIN_NUM_SAMPLES, CLASSES_TO_KEEP)
df_test = sample_data(df_test, TEST_NUM_SAMPLES, CLASSES_TO_KEEP)
df_train.value_counts('Class Name')
df_test.value_counts('Class Name')
生成嵌入
在本节中,你将了解如何使用 Gemini API 的嵌入模型为数据框中的不同文本生成嵌入。
Gemini 嵌入模型支持多种任务类型,每种类型都针对特定目标而设计。以下是可用类型及其应用场景的总体概述:
任务类型 | 描述
- -- | ---
RETRIEVAL_QUERY | 指定给定文本是搜索/检索场景中的查询。
RETRIEVAL_DOCUMENT | 指定给定文本是搜索/检索场景中的文档。
SEMANTIC_SIMILARITY | 指定给定文本将用于语义文本相似度(STS)。
CLASSIFICATION | 指定嵌入将用于分类。
CLUSTERING | 指定嵌入将用于聚类。
from tqdm.auto import tqdm
from google.genai import types

tqdm.pandas()

import numpy as np
import math

def make_embed_text_fn(model):

    def embed_fn(texts: list[str]) -> list[list[float]]:
        # Set the task_type to CLASSIFICATION and embed the batch of texts
        result = client.models.embed_content(model=model,
                                            contents=[texts],
                                            config=types.EmbedContentConfig(
                                                task_type="CLASSIFICATION")).embeddings
        return np.array([embedding.values for embedding in result])

    return embed_fn


def create_embeddings(df):
    embed_fn = make_embed_text_fn(MODEL_ID)

    batch_size = 25  # at most 25 requests can be in one batch
    all_embeddings = []

    # Loop over the texts in chunks of batch_size
    for i in tqdm(range(0, len(df), batch_size)):
        batch = df["Text"].iloc[i : i + batch_size].tolist()
        embeddings = embed_fn(batch)
        all_embeddings.extend(embeddings)

    df["Embeddings"] = all_embeddings
    return df
import numpy as np
from tqdm.auto import tqdm
tqdm.pandas()


def make_embed_text_fn(model):

  def embed_fn(text: str) -> list[float]:
    # Set the task_type to CLASSIFICATION.
    result = client.models.embed_content(model=model,
                                            contents=text,
                                            config=types.EmbedContentConfig(
                                                task_type="CLASSIFICATION"))
    return np.array(result.embeddings[0].values)

  return embed_fn

def create_embeddings(df):
  df['Embeddings'] = df['Text'].progress_apply(make_embed_text_fn(MODEL_ID))
  return df
准备训练数据集:
df_train = create_embeddings(df_train)
df_train
df_test = create_embeddings(df_test)
df_test
构建一个简单的分类模型
在这里,你将定义一个简单的模型,它包含一个隐藏层和一个单一类别概率输出。预测结果将对应于一段文本属于特定新闻类别的概率。当你构建模型时,Keras 会自动打乱数据点。
import keras
from keras import layers

def build_classification_model(input_size: int, num_classes: int) -> keras.Model:
  inputs = x = keras.Input(shape=(input_size,))
  x = layers.Dense(input_size, activation='relu')(x)
  x = layers.Dense(num_classes, activation='softmax')(x)
  return keras.Model(inputs=inputs, outputs=x)
# Derive the embedding size from the first training element.
embedding_size = len(df_train['Embeddings'].iloc[0])

# Give your model a different name, as you have already used the variable name 'model'
classifier = build_classification_model(embedding_size, len(df_train['Class Name'].unique()))
classifier.summary()

classifier.compile(loss = keras.losses.SparseCategoricalCrossentropy(from_logits=False),
                   optimizer = keras.optimizers.Adam(learning_rate=0.001),
                   metrics=['accuracy'])
embedding_size
训练模型对新闻组进行分类
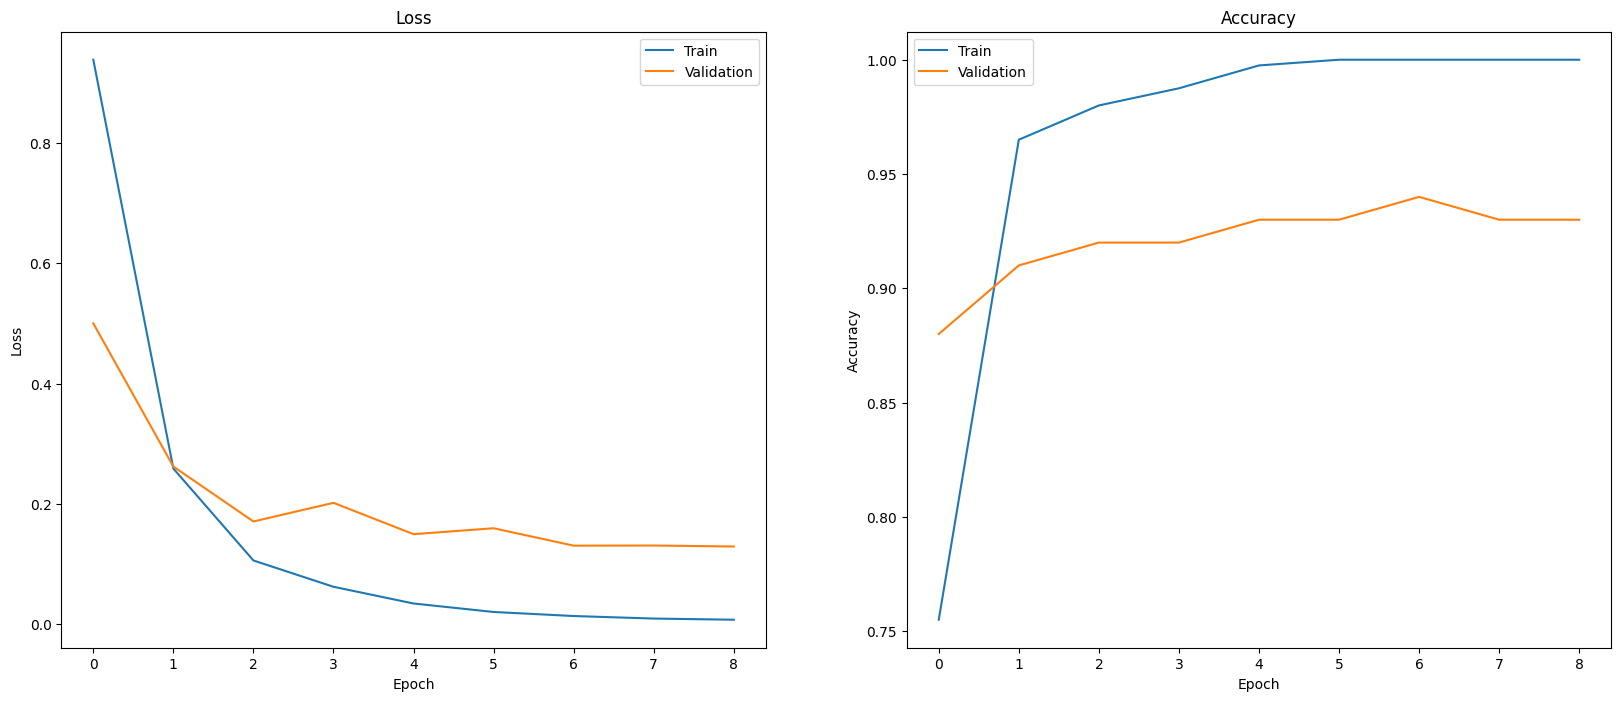
最后,你可以训练一个简单的模型。使用较少的轮数以避免过拟合。第一轮比其余轮次耗时更长,因为嵌入只需要计算一次。
NUM_EPOCHS = 25
BATCH_SIZE = 32

# Split the x and y components of the train and validation subsets.
y_train = df_train['Encoded Label']
x_train = np.stack(df_train['Embeddings'])
y_val = df_test['Encoded Label']
x_val = np.stack(df_test['Embeddings'])

# Train the model for the desired number of epochs.
callback = keras.callbacks.EarlyStopping(monitor='accuracy', patience=3)

history = classifier.fit(x=x_train,
                         y=y_train,
                         validation_data=(x_val, y_val),
                         callbacks=[callback],
                         batch_size=BATCH_SIZE,
                         epochs=NUM_EPOCHS,)
评估模型性能
使用 Keras 的 <a href="https://www.tensorflow.org/api_docs/python/tf/keras/Model#evaluate"><code>Model.evaluate</code></a> 获取测试数据集上的损失和准确率。
classifier.evaluate(x=x_val, y=y_val, return_dict=True)
评估模型性能的一种方法是将分类器性能可视化。使用 plot_history 查看损失和准确率随 epoch 的变化趋势。
import matplotlib.pyplot as plt

def plot_history(history):
  """
    Plotting training and validation learning curves.

    Args:
      history: model history with all the metric measures
  """
  fig, (ax1, ax2) = plt.subplots(1,2)
  fig.set_size_inches(20, 8)

  # Plot loss
  ax1.set_title('Loss')
  ax1.plot(history.history['loss'], label = 'train')
  ax1.plot(history.history['val_loss'], label = 'test')
  ax1.set_ylabel('Loss')

  ax1.set_xlabel('Epoch')
  ax1.legend(['Train', 'Validation'])

  # Plot accuracy
  ax2.set_title('Accuracy')
  ax2.plot(history.history['accuracy'],  label = 'train')
  ax2.plot(history.history['val_accuracy'], label = 'test')
  ax2.set_ylabel('Accuracy')
  ax2.set_xlabel('Epoch')
  ax2.legend(['Train', 'Validation'])

  plt.show()

plot_history(history)
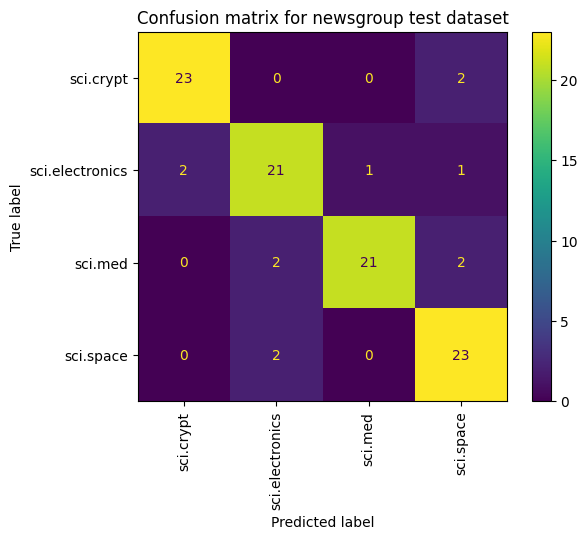
查看模型性能的另一种方式,除了仅测量损失和准确率之外,是使用混淆矩阵。混淆矩阵允许你在准确率之外评估分类模型的性能。你可以看到被错误分类的点被归类为什么。为了为这个多类分类问题构建混淆矩阵,获取测试集中的实际值和预测值。
首先使用 Model.predict() 为验证集中的每个示例生成预测类别。
y_hat = classifier.predict(x=x_val)
y_hat = np.argmax(y_hat, axis=1)
labels_dict = dict(zip(df_test['Class Name'], df_test['Encoded Label']))
labels_dict
import sklearn.metrics as skmetrics

cm = skmetrics.confusion_matrix(y_val, y_hat)
disp = skmetrics.ConfusionMatrixDisplay(confusion_matrix=cm,
                              display_labels=labels_dict.keys())
disp.plot(xticks_rotation='vertical')
plt.title('Confusion matrix for newsgroup test dataset');
plt.grid(False)
后续步骤
你现在已经创建了自己的文本分类!要了解如何使用 Gemini API 中的其他服务,请参阅快速入门指南。
常见问题
常见错误一:未设置 GEMINI_API_KEY,导致客户端初始化失败;应通过 Colab userdata 或环境变量注入,避免硬编码。错误二:混用不同嵌入模型,向量维度或语义空间不一致,训练结果异常;必须固定 MODEL_ID。错误三:任务类型选错,例如分类任务误用 RETRIEVAL_QUERY,会降低分类效果;应使用 CLASSIFICATION。错误四:批量超过 25 触发 API 限制;需按 batch_size 分块。错误五:文本过长导致截断或超限;预处理已限制 5000 字符。错误六:过拟合,训练准确率上升但验证下降;可减少 epoch、增大 patience 或加正则。错误七:标签编码未重置,采样后类别编号错乱;sample_data 中已用 cat.codes 重编码。排查时先打印 client.models.list() 确认模型支持 embedContent,再检查嵌入维度与标签分布,最后查看损失曲线与混淆矩阵定位问题类别。
企业应用扩展
生产环境可从以下方向优化:一是嵌入缓存与持久化,将向量写入向量库或 Parquet,避免重复计费;二是并发与重试,使用指数退避处理 429/5xx,并控制 QPS;三是批量调优,在 API 上限内增大批量以提升吞吐;四是模型选择,对比 gemini-embedding-001 与 gemini-embedding-2-preview 的维度与效果,但需整体切换;五是分类头升级,可尝试 Dropout、L2 正则、类别权重或改用逻辑回归/线性 SVM 作为基线;六是评估体系,除准确率外加入 macro-F1、混淆矩阵与错误样本分析;七是流水线化,把预处理、嵌入、训练、评估封装为可配置脚本,支持增量更新与版本管理;八是安全与合规,清洗 PII、控制日志中的原文输出,并遵守 API 定价与配额策略。
总结
本教程以 20 Newsgroups 数据集为例,演示如何调用 Gemini API 的 gemini-embedding-001 模型生成文本嵌入,并用 Keras 构建一个轻量分类器完成新闻组主题分类。内容涵盖 API 密钥配置、数据清洗与采样、批量嵌入生成、模型构建与训练、早停策略、损失与准确率曲线以及混淆矩阵评估。教程强调嵌入模型与任务类型必须匹配、不同模型输出互不兼容等工程约束,并给出可复现的安装、运行与排查步骤,适合希望掌握嵌入驱动分类流水线的开发者。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:S_CANDIDATE
- 难度:中级
- 验证等级:V1
- 原文作者:
- 原文日期:
- 来源许可:Apache-2.0
- 来源版本:
7c2cb66b9ae600fa28c7e35f386618b7b34750ba - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员