Sora 2 提示词指南:掌握视频生成的关键技巧
技术背景
Sora 2 是 OpenAI 推出的先进视频生成模型,能够根据文本提示词生成高质量、逼真的视频。随着 AI 视频生成技术的快速发展,提示词工程成为控制生成结果的关键技能。开发者需要理解模型的工作原理、API 参数与提示词的关系,以及如何通过结构化描述、风格引导和迭代优化来获得理想输出。本教程旨在填补从理论到实践的空白,帮助开发者系统掌握 Sora 2 的提示词编写方法,提升视频生成的质量与效率。
核心原理
Sora 2 基于扩散模型架构,通过解析文本提示词中的语义信息,逐步去噪生成视频帧。提示词中的主体、动作、场景、风格和镜头语言等要素会被模型编码为条件向量,引导生成过程。模型在训练时学习了大量视频-文本对,能够将文本描述映射到视觉特征。关键设计决策包括:使用时间步长控制视频长度,通过分辨率参数影响视觉保真度,以及支持角色参考和图像输入以增强一致性。提示词的详细程度直接影响模型的自由度:详细提示词提供强约束,轻量提示词则允许更多创意变化。
架构分析
Sora 2 的系统架构包括多个核心组件:视频生成端点(POST /v1/videos)负责根据提示生成视频;角色创建端点(POST /v1/videos/characters)允许上传参考片段创建可复用角色;视频扩展端点(POST /v1/videos/extensions)利用完整原始片段作为上下文延续视频;视频编辑端点(POST /v1/videos/{video_id}/edits)支持基于新提示的局部修改。API 参数(model、size、seconds、characters)控制视频的容器属性,而提示词则控制内容。图像输入作为第一帧锚点,增强构图和风格控制。数据流为:用户输入提示词和参数 → API 请求 → 模型生成视频 → 返回结果。设计上强调模块化,支持批处理 API 以应对生产级工作流。
完整实战教程
简介
Sora 2 是 OpenAI 推出的先进视频生成模型,能够根据文本提示词生成高质量、逼真的视频。本指南将深入探讨如何编写有效的提示词,以充分发挥 Sora 2 的潜力。
理解提示词
提示词是您向模型描述所需视频内容的文本。Sora 2 会解析提示词中的关键信息,并生成与之匹配的视频。一个优秀的提示词应包含以下要素:
- 主体:视频中的主要对象或人物。
- 动作:主体正在进行的动作或行为。
- 场景:视频发生的环境或背景。
- 风格:视频的视觉风格,如写实、动画、电影感等。
- 镜头语言:摄像机的运动方式,如推近、拉远、平移等。
编写提示词的步骤
- 明确目标:确定您想要生成的视频内容,包括主题、氛围和用途。
- 描述主体:详细描述主体的外观、特征和状态。
- 描述动作:说明主体正在做什么,动作要具体、生动。
- 设定场景:描述环境细节,如地点、时间、天气、光线等。
- 选择风格:指定视觉风格,如“电影感”、“纪录片风格”、“动漫风格”等。
- 添加镜头指令:如果需要,可以指定镜头运动,如“缓慢推近”、“跟随拍摄”等。
- 优化措辞:使用清晰、具体的语言,避免模糊或歧义。
提示词示例
示例 1:写实风格
提示词:一只橘猫坐在窗台上,阳光洒在它的毛上,它慵懒地伸了个懒腰,然后望向窗外。镜头缓慢推近,背景是模糊的城市街道。
生成效果:一段逼真的视频,展示橘猫在阳光下的日常瞬间。
示例 2:动画风格
提示词:一个穿着宇航服的卡通兔子在月球上跳跃,背景是星空和地球,风格为皮克斯动画,色彩鲜艳,镜头跟随兔子运动。
生成效果:一段充满童趣的动画视频,兔子在月球上欢快跳跃。
示例 3:电影感
提示词:一个侦探在昏暗的房间里翻阅文件,窗外下着雨,霓虹灯闪烁,镜头从侧面缓慢平移,营造出悬疑氛围。
生成效果:一段具有电影质感的视频,氛围紧张而神秘。
最佳实践
- 具体化:提供尽可能多的细节,避免模糊描述。
- 使用形容词:用形容词来增强描述,如“鲜艳的”、“破旧的”、“宁静的”等。
- 控制长度:提示词不宜过长,但也不宜过短,通常 1-3 句话即可。
- 实验迭代:多次尝试不同的提示词,观察效果并调整。
- 参考示例:参考官方示例或其他用户的优秀提示词,学习其结构。
常见问题与解决方案
问题 1:生成的视频与提示词不符
- 原因:提示词可能过于模糊或包含矛盾信息。
- 解决方案:重新审视提示词,确保每个要素都清晰明确,并删除无关信息。
问题 2:视频质量不佳
- 原因:提示词可能缺乏细节,或风格描述不明确。
- 解决方案:增加更多描述性词汇,明确指定风格和镜头语言。
问题 3:视频内容不符合预期
- 原因:可能对模型的能力理解有偏差。
- 解决方案:调整提示词,使其更符合模型擅长生成的场景,或尝试不同的创意方向。
高级技巧
- 使用负面提示词:虽然 Sora 2 不支持负面提示词,但您可以通过明确描述“不要”的内容来引导模型。
- 组合多个场景:在提示词中描述多个连续场景,让模型生成更复杂的视频。
- 利用时间描述:使用“首先”、“然后”、“最后”等词语来指示时间顺序。
结论
编写有效的提示词是使用 Sora 2 的关键技能。通过遵循本指南中的步骤和最佳实践,您将能够生成更符合预期的视频。不断实践和实验,您将掌握这一技能,并创作出令人惊叹的作品。
未来展望
随着 AI 技术的不断发展,Sora 2 可能会引入更多功能,如更长的视频生成、音频支持等。届时,提示词指南也将不断更新,以帮助用户充分利用新特性。
编写成功的视频提示词
更新 - 2026年3月
本指南已更新,以反映最新的Sora API功能,包括:
- 角色参考(物体和动物) – 上传一次角色,即可在多个视频中重复使用,保持外观一致。
- 更高分辨率的导出 – 生成1920×1080或1080×1920分辨率的视频。
- 更长的视频 – 最大时长从12秒增加到20秒。
- 视频扩展 – 使用完整初始片段作为上下文来扩展现有视频,而不仅仅是最后一帧。
- 视频批处理API – 运行异步视频生成任务,适用于更大规模的生产工作流。
提示之前
把提示想象成向一位从未看过你的故事板的摄影师做简报。如果你遗漏了细节,他们会即兴发挥——你可能得不到你设想的结果。通过具体说明“镜头”应达到的效果,你可以让模型拥有更多的控制力和一致性。
但保留一些细节开放同样可以很强大。给模型更多的创作自由可以带来令人惊讶的变化和意想不到的、美丽的诠释。这两种方法都是有效的:详细的提示给你控制力和一致性,而更轻量的提示为创意结果留出空间。 正确的平衡取决于你的目标和想要的结果。
将你的提示视为一份创意愿望清单,而不是一份合同。与ChatGPT一样,多次使用相同的提示会产生不同的结果——这是一个特性,而不是缺陷。每次生成都是一次全新的尝试,有时第二个或第三个选项会更好。
最重要的是,准备好迭代。对摄影机、灯光或动作的微小改变都可能显著改变结果。与模型协作:你提供方向,模型提供创意变体。
这不是一门精确的科学——将下面的指导视为我们与模型合作中学到的有用建议。
API 参数
提示词控制视频的内容,但某些属性仅由 API 参数决定。你不能在文本中请求这些属性,必须在 API 调用中显式设置:
- model:
sora-2或sora-2-pro。 - size:格式为 {宽度}x{高度} 的字符串。支持的分辨率取决于模型选择:
- sora-2
- 720x1280, 1280x720
- sora-2-pro
- 720x1280, 1280x720
- 1024x1792, 1792x1024
- 1080x1920, 1920x1080
- seconds:片段长度,支持的值:“4”、“8”、“12”、“16”、“20”。默认值为“4”。
- characters *(可选)*:在生成中引用最多两个上传的角色。每个条目应包含 Characters API 返回的角色 ID。
这些参数是视频的容器:分辨率、时长和角色引用不会根据诸如“让它更长”之类的文本而改变。请在 API 调用中显式设置它们;你的提示词控制其他所有内容(主体、运动、光照、风格)。有关更多详细信息,请参阅 Sora API 文档。
视频分辨率
视频分辨率直接影响Sora中的视觉保真度和运动一致性。更高的分辨率能更准确地生成细节、纹理和光照过渡,而较低的分辨率会压缩视觉信息,常常引入模糊或伪影。
视频长度
模型通常在较短的片段中更可靠地遵循指令。为了获得最佳效果,请尽量使用简洁的镜头。如果项目允许,你可以考虑在剪辑中将两个4秒的片段拼接在一起,而不是生成一个8秒的片段,这样可能会得到更好的结果。
端点
Sora API 支持多个端点,用于生成和迭代视频:
- 创建视频 —
POST /v1/videos
根据提示生成新视频。
- 创建角色 —
POST /v1/videos/characters
上传短参考片段以创建可复用的角色用于生成。
- 扩展视频 —
POST /v1/videos/extensions
继续现有视频。完整原始片段用作上下文。
- 编辑视频 —
POST /v1/videos/{video_id}/edits
使用新提示编辑现有视频。
有效的提示词结构
清晰的提示词应像在故事板上绘制镜头一样描述一个镜头。说明镜头取景、注明景深、按节拍描述动作,并设定灯光和色调。用几个独特的细节锚定主体,使其保持可识别性,而一个合理且单一的动作则让镜头更易于理解。
如果需要在单个提示词中覆盖多个镜头,这也是可行的。此时,请确保每个镜头块保持独立:一次一个摄影机设置、一个主体动作、一个灯光方案。这样,你可以灵活地生成短小的独立片段或更长的连续时刻,具体取决于你的项目需求。将每个镜头视为一个创作单元,你可以在剪辑中拼接它们,或让它们一次性连续播放。
- 较短的提示词给模型更多创作自由,结果可能出人意料。
- 较长、更详细的提示词会限制模型的创造力。它会尽力遵循你的指导,但可能并不总是可靠。
以下是一个简短提示词的示例:
In a 90s documentary-style interview, an old Swedish man sits in a study and says, "I still remember when I was young."
这个提示词很可能效果不错:
90年代纪录片设定了视频的风格。模型会相应地选择摄像机镜头、灯光和色调等变量。一位瑞典老人坐在书房里简要描述了主体和环境,让模型在人物和环境的外观上发挥创意。并说:“我仍然记得我年轻的时候。”描述了对话。Sora 很可能会准确遵循这一点。
这个提示词能可靠地生成符合这些要求的视频。然而,它可能不完全符合你的设想,因为许多细节留白。例如,提示词没有描述一天中的时间、天气、服装、语调、角色的外貌和年龄、摄像机角度、剪辑、布景设计以及其他许多因素。除非你描述这些细节,否则 Sora 会自行编造。
走向超详细
对于复杂的、电影感的镜头,你可以超越标准的提示结构,用专业的制作术语来指定外观、摄影机设置、调色、音景甚至镜头理由。这类似于导演向摄影组或视觉特效团队做简报的方式。关于镜头、滤镜、灯光、调色和运动的详细提示有助于模型锁定非常具体的美学风格。
例如,你可以描述观众首先注意到什么、摄影机平台和镜头、灯光方向、调色板、纹理质感、剧情内声音以及镜头时长。当你想要匹配真实的电影摄影风格(例如,IMAX航拍、35mm手持、复古16mm纪录片)或在多个镜头之间保持严格的连续性时,这种方法效果很好。
示例
Format & Look
Duration 4s; 180° shutter; digital capture emulating 65 mm photochemical contrast; fine grain; subtle halation on speculars; no gate weave.

Lenses & Filtration
32 mm / 50 mm spherical primes; Black Pro-Mist 1/4; slight CPL rotation to manage glass reflections on train windows.

Grade / Palette
Highlights: clean morning sunlight with amber lift.
Mids: balanced neutrals with slight teal cast in shadows.
Blacks: soft, neutral with mild lift for haze retention.

Lighting & Atmosphere
Natural sunlight from camera left, low angle (07:30 AM).
Bounce: 4×4 ultrabounce silver from trackside.
Negative fill from opposite wall.
Practical: sodium platform lights on dim fade.
Atmos: gentle mist; train exhaust drift through light beam.

Location & Framing
Urban commuter platform, dawn.
Foreground: yellow safety line, coffee cup on bench.
Midground: waiting passengers silhouetted in haze.
Background: arriving train braking to a stop.
Avoid signage or corporate branding.

Wardrobe / Props / Extras
Main subject: mid-30s traveler, navy coat, backpack slung on one shoulder, holding phone loosely at side.
Extras: commuters in muted tones; one cyclist pushing bike.
Props: paper coffee cup, rolling luggage, LED departure board (generic destinations).

Sound
Diegetic only: faint rail screech, train brakes hiss, distant announcement muffled (-20 LUFS), low ambient hum.
Footsteps and paper rustle; no score or added foley.

Optimized Shot List (2 shots / 4 s total)

0.00–2.40 — “Arrival Drift” (32 mm, shoulder-mounted slow dolly left)
Camera slides past platform signage edge; shallow focus reveals traveler mid-frame looking down tracks. Morning light blooms across lens; train headlights flare softly through mist. Purpose: establish setting and tone, hint anticipation.

2.40–4.00 — “Turn and Pause” (50 mm, slow arc in)
Cut to tighter over-shoulder arc as train halts; traveler turns slightly toward camera, catching sunlight rim across cheek and phone screen reflection. Eyes flick up toward something unseen. Purpose: create human focal moment with minimal motion.

Camera Notes (Why It Reads)
Keep eyeline low and close to lens axis for intimacy.
Allow micro flares from train glass as aesthetic texture.
Preserve subtle handheld imperfection for realism.
Do not break silhouette clarity with overexposed flare; retain skin highlight roll-off.

Finishing
Fine-grain overlay with mild chroma noise for realism; restrained halation on practicals; warm-cool LUT for morning split tone.
Mix: prioritize train and ambient detail over footstep transients.
Poster frame: traveler mid-turn, golden rim light, arriving train soft-focus in background haze.
引导视觉风格的提示词
在编写提示词时,风格是引导模型达到预期效果最有力的杠杆之一。描述整体美学风格——例如,*“1970年代电影”*、*“史诗级IMAX规模场景”*或*“16毫米黑白胶片”*——会设定一种视觉基调,影响所有其他选择。尽早确立这种风格,以便模型能够始终如一地贯彻它。
同样的细节,根据你要求的是精致的好莱坞剧情片、手持智能手机拍摄的片段,还是颗粒感十足的老式广告,其呈现效果会截然不同。基调确定后,再通过镜头、动作和光线逐步添加具体细节。
清晰至上。不要使用模糊的提示词,如*“一条美丽的街道”*,而应写*“湿漉漉的沥青路面、斑马线、霓虹灯倒影”*。不要写*“快速移动”*,而应具体描述*“慢跑三步,然后在路边停下”*。指向可见结果的动词和名词总能带来更清晰、更一致的输出。
| 弱提示词 | 强提示词 |
| --- | --- |
| “夜晚美丽的街道” | “湿漉漉的沥青路面、斑马线、霓虹灯倒映在水坑中” |
| “人物快速移动” | “骑自行车的人踩踏三次,刹车,在斑马线前停下” |
| “电影感” | “2.0倍变形镜头、浅景深、体积光” |
镜头方向和取景方式决定了镜头的感受。高角度广角镜头会强调空间和背景,而视线高度的特写镜头则聚焦于情感。景深增加了另一层维度:浅景深可以使主体在模糊的背景中脱颖而出,而深景深则保持前景和背景都清晰锐利。光线同样强烈地设定基调。柔和、温暖的主光营造出温馨的氛围,而单一硬光搭配冷色调边缘则推向戏剧性。
在引入角色时,要预期一些不可预测性——措辞的细微变化可能改变身份、姿势或场景本身的焦点。保持跨镜头的描述一致性,重复使用措辞以确保连续性,并避免混合可能相互冲突的特征。
弱
Camera shot: cinematic look
Strong
Camera shot: wide shot, low angle
Depth of field: shallow (sharp on subject, blurred background)
Lighting + palette: warm backlight with soft rim
一些好的取景指令示例:
- 广角定场镜头,平视角度
- 广角镜头,跟随冲锋从左向右移动
- 航拍广角镜头,轻微俯视角度
- 中近景镜头,从背后轻微倾斜角度
一些好的运镜指令示例:
- 缓慢倾斜镜头
- 手持ENG摄像机
控制运动与节奏
运动往往是最难把握的部分,所以尽量保持简单。每个镜头应有一个明确的摄像机运动和一个明确的主题动作。动作最好以节拍或计数来描述——小步、手势或停顿——这样它们才能有时间感。
“演员穿过房间”没有提供太多可操作的信息。像“演员走四步到窗前,停顿,并在最后一秒拉上窗帘”这样的描述能让时间精确且可实现。
弱
Actor walks across the room.
Strong
Actor takes four steps to the window, pauses, and pulls the curtain in the final second.
光照与色彩一致性
光照对情绪的影响不亚于动作或场景。柔和的光线均匀分布,给人平静、中性的感觉;而单一强光源则能营造出强烈的对比和紧张感。当你想将多个片段剪辑在一起时,保持光照逻辑的一致性是让剪辑无缝衔接的关键。
描述光照质量的同时,也要提及强化光照的色彩锚点。不要使用“光线明亮的房间”这样宽泛的描述,而应具体说明光源和色调的组合:“柔和的窗光,辅以暖色台灯补光,走廊方向透出冷色边缘光。”提及三到五种颜色有助于保持镜头间色调的稳定。
不佳示例
Lighting + palette: brightly lit room
Strong
Lighting + palette: soft window light with warm lamp fill, cool rim from hallway
Palette anchors: amber, cream, walnut brown
使用图像输入以获得更多控制
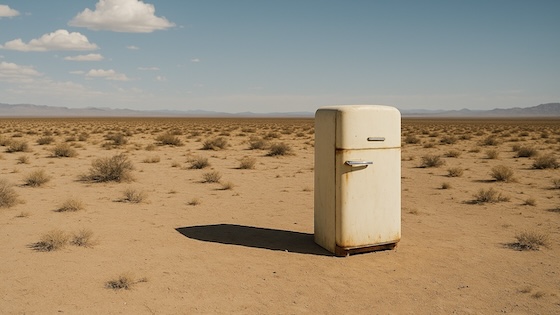
为了对镜头的构图和风格进行更精细的控制,你可以使用图像输入作为视觉参考。你可以使用照片、数字艺术作品或AI生成的视觉内容。这样可以锁定角色设计、服装、场景布置或整体美学等元素。模型会将图像作为第一帧的锚点,而你的文本提示则定义接下来发生的内容。
如何使用
在POST /videos请求中,将图像文件作为input_reference参数包含在内。
- 图像必须与目标视频的分辨率(尺寸)匹配。
- 支持的文件格式为:
image/jpeg、image/png和image/webp。
| 使用 OpenAI GPT Image 生成的输入图像 | 使用 Sora 2 生成的视频(转换为 GIF) |
| :--: | :--: |
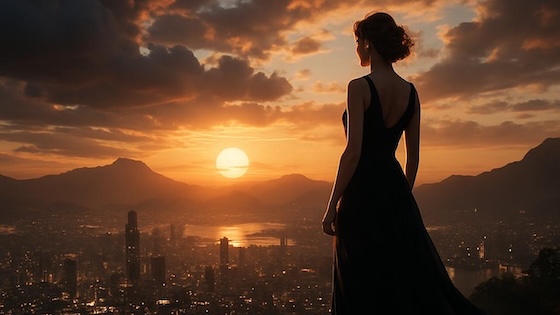 <p><small>下载此图片</small></p>
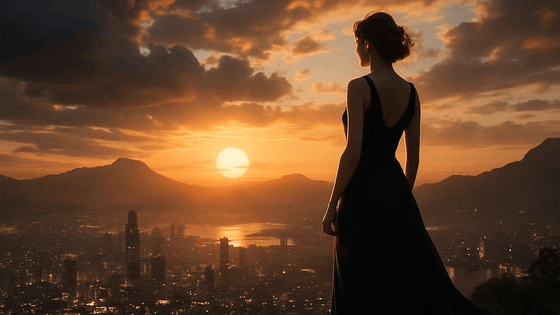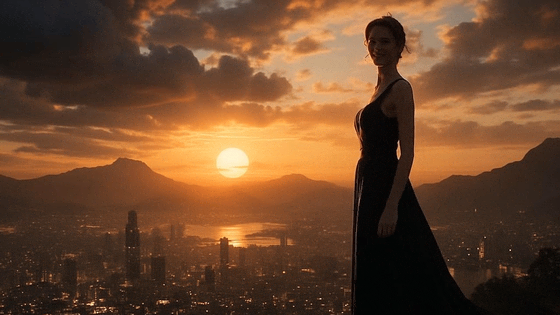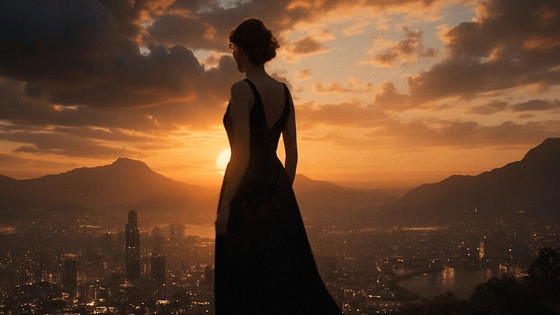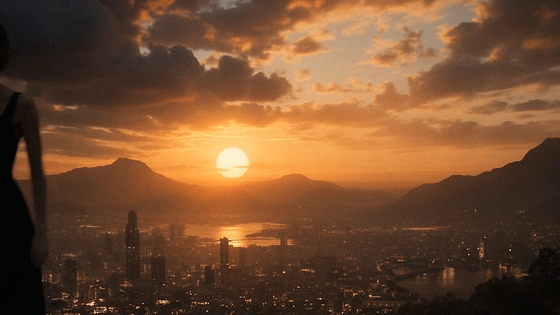 <p><small>提示:_“她转过身来,微微一笑,然后慢慢走出画面。”_</small></p> |
 <p><small>下载此图片</small></p>
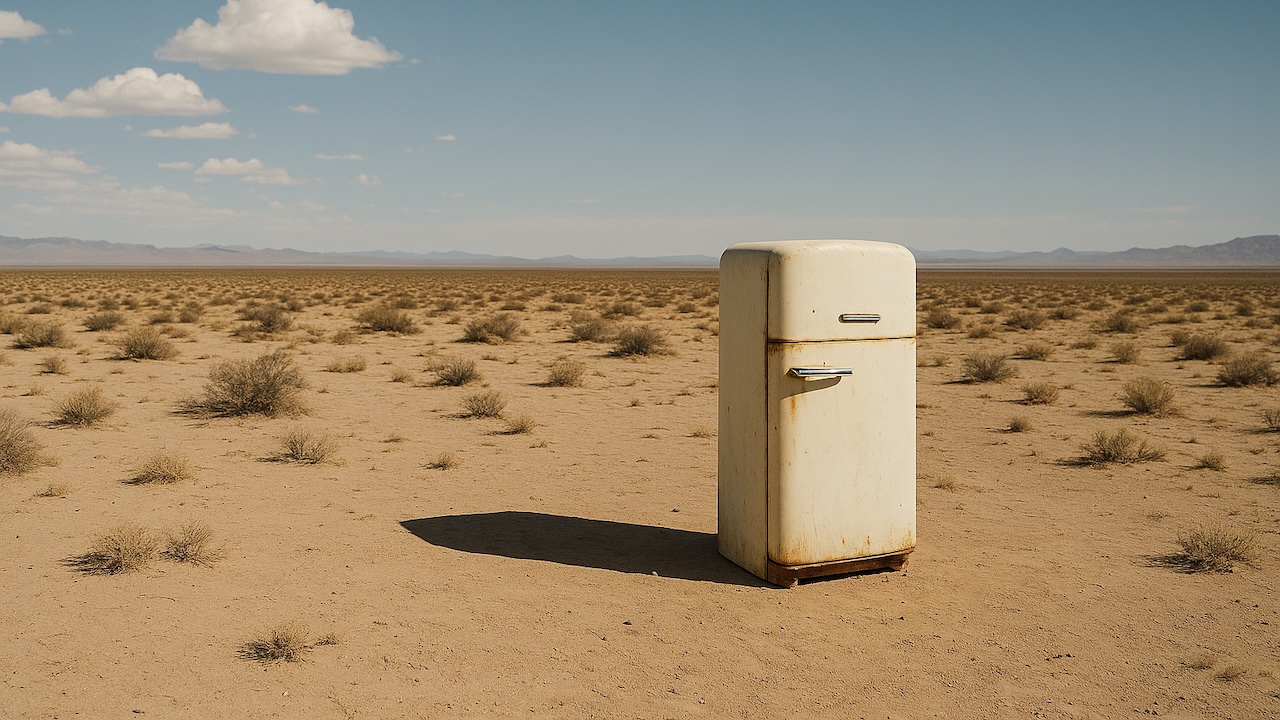
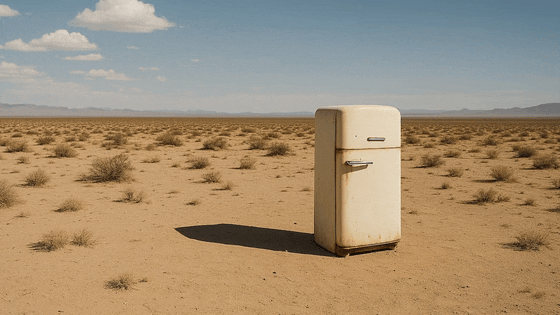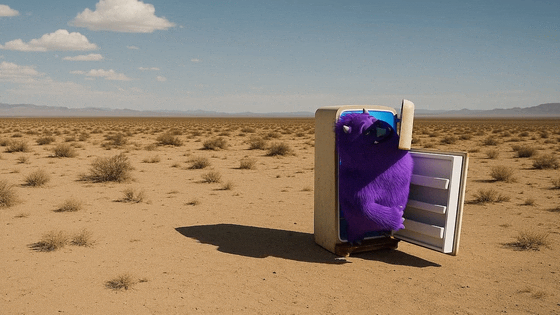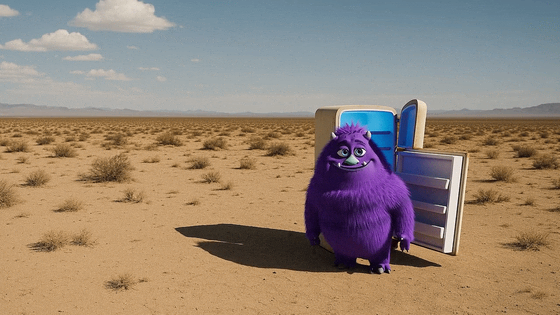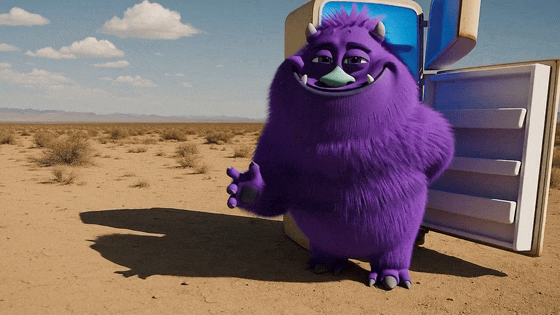 <p><small>提示:_“冰箱门打开。一个可爱、胖乎乎的紫色怪物从里面出来。”_</small></p> |
实验技巧
如果你还没有视觉参考,OpenAI 的图像生成模型 是创建它们的强大工具。你可以快速生成环境和场景设计,然后将它们作为参考传递给 Sora。这是测试美学和生成视频美丽起点的好方法。
对话与音频
对话必须直接在提示中描述。将其放在散文描述下方的 <dialogue> 块中,以便模型清晰区分视觉描述与台词。保持台词简洁自然,并尽量将交流限制在几句话内,以便与剪辑时长匹配。对于多角色场景,一致地标记说话者并使用交替轮次;这有助于模型将每句台词与正确角色的手势和表情关联起来。
你还应考虑节奏和时机:4秒的镜头通常能容纳一到两次简短交流,而8秒的片段可以支持更多。冗长复杂的演讲可能难以同步,并可能破坏节奏。
如果你的镜头是无声的,你仍然可以用一个微小的声音来暗示节奏,例如“远处的交通嘶嘶声”或“清脆的啪嗒声”。将其视为节奏提示,而非完整的配乐。
带对话的示例提示:
A cramped, windowless room with walls the color of old ash. A single bare bulb dangles from the ceiling, its light pooling onto the scarred metal table at the center. Two chairs face each other across it. On one side sits the Detective, trench coat draped across the back of his chair, eyes sharp and unblinking. Across from him, the Suspect slouches, cigarette smoke curling lazily toward the ceiling. The silence presses in, broken only by the faint hum of the overhead light.

Dialogue:
- Detective: "You’re lying. I can hear it in your silence."
- Suspect: "Or maybe I’m just tired of talking."
- Detective: "Either way, you’ll talk before the night’s over."
背景声音的示例描述:
The hum of espresso machines and the murmur of voices form the background.
通过视频编辑进行迭代
编辑是为了微调,而不是赌博。用它来进行受控的更改——一次一个——并说明你在更改什么:“相同镜头,切换到 85 毫米”,或“相同光照,新调色板:青绿色、沙色、铁锈色”。当结果接近时,将其固定为参考,并仅描述调整。这样,所有已经有效的部分都会保持锁定。
如果某个镜头一直失败,就将其简化:固定相机,简化动作,清理背景。一旦成功,再逐步增加复杂性。
| 原始视频 | 编辑后的视频 |
| --- | --- |
<p><small>原始视频</small></p>
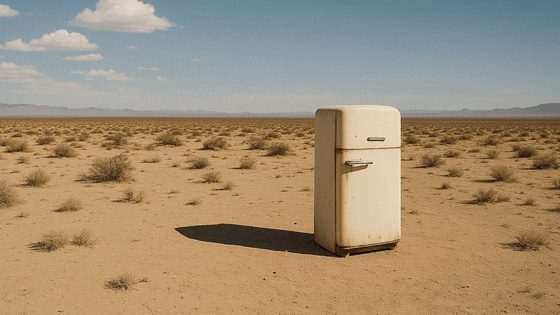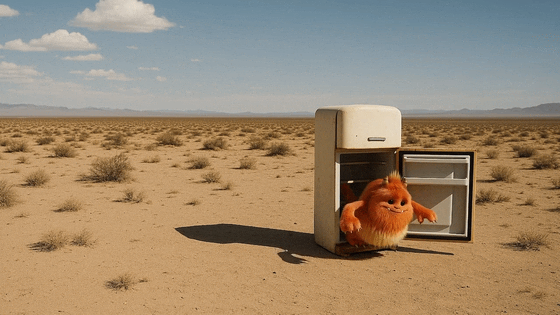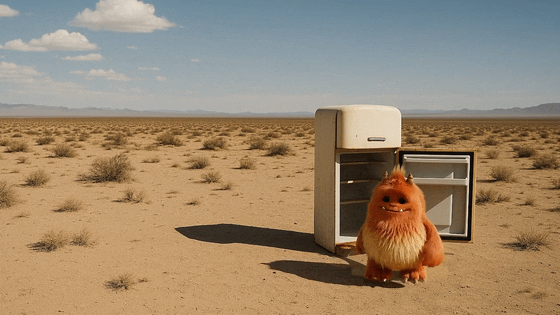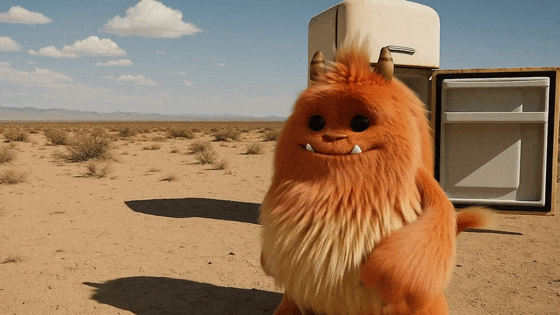 <p><small>_编辑提示:“将怪物的颜色改为橙色”_</small></p> |
<p><small>原始视频</small></p>
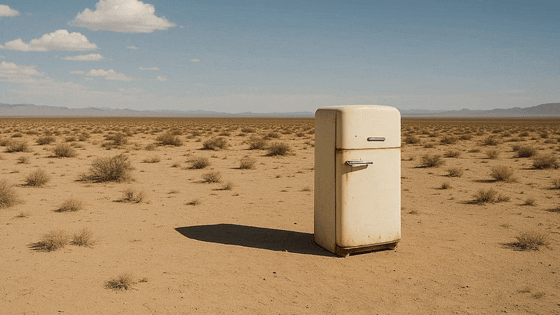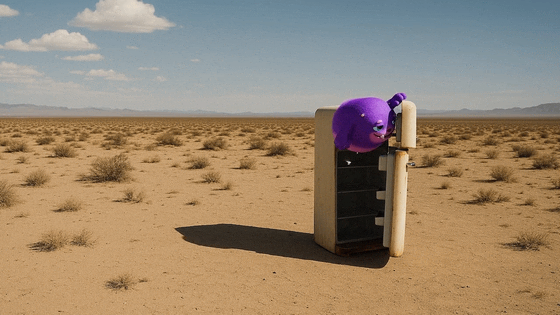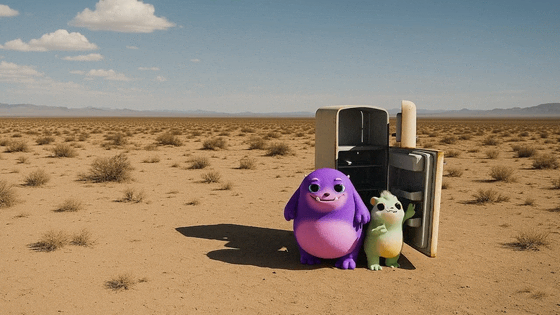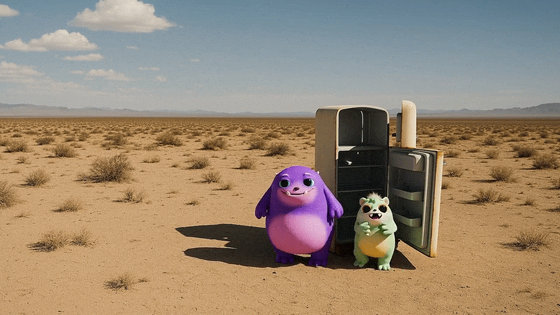 <p><small>_编辑提示:"紧接着出现了第二只怪物"_</small></p>
角色
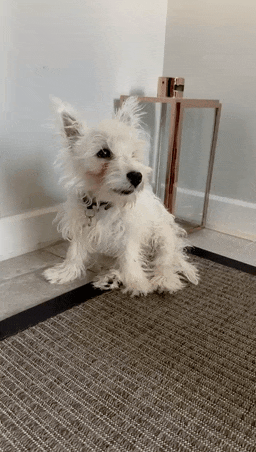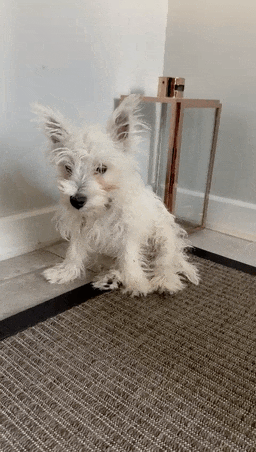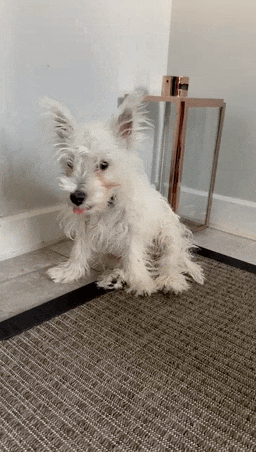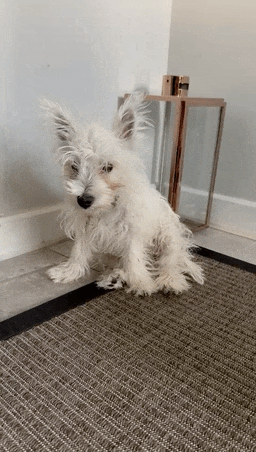
角色 API 允许你从短视频参考片段创建可复用的角色。创建后,角色可以在未来的生成中重复使用,以保持外观和屏幕形象的一致性。你可以从任何动物或物体创建角色。
创建角色
上传一个短视频片段来创建角色。要求:
- MP4 视频
- 2–4 秒
- 720p–1080p 分辨率
- 16:9 或 9:16 宽高比
使用角色生成
创建视频时,包含角色 ID 并在提示中按名称引用角色。我们建议每次生成不超过 2 个角色。
{
"model": "sora-2",
"prompt": "A cinematic shot of Alfie running through wet grass at sunrise",
"size": "720x1280",
"seconds": "4",
"characters": [
{ "id": "char_123" }
]
}
以下是使用上传的名为Alfie的小狗角色生成的三个GIF示例。最左边的视频是用于创建该角色的原始参考。
| 输入角色视频 | 生成 1 | 生成 2 | 生成 3 |
| --- | --- | --- | --- |
 |
 |
 |
 |
扩展视频
您可以通过生成额外的片段来扩展现有视频。模型会使用完整的原始片段作为上下文,这有助于保持场景的连续性。这对于从较短的片段构建更长的序列非常有用。支持单次扩展最长 20 秒。一个视频最多可以扩展 6 次,总时长可达 120 秒。
提示模板与示例
提示词结构
一种有效的编写提示词的方法是将您希望模型使用的不同类型的信息分开。这并非放之四海而皆准的成功秘诀,但它为您提供了一个清晰的框架,并使保持一致变得更加容易。并非每个细节都需要包含——如果某些内容对镜头无关紧要,您可以将其省略。
事实上,保留某些元素的开放性将鼓励模型更具创造力。您对每个视觉选择的规定越不严格,模型就有越多的空间进行诠释,并用意想不到但往往美丽的变体给您惊喜。高度描述性的提示词会产生更一致、可控的结果,而较轻松的提示词则可以解锁多样化的结果,这些结果感觉新颖且富有想象力。
描述性提示词模板:
[Prose scene description in plain language. Describe characters, costumes, scenery, weather and other details. Be as descriptive to generate a video that matches your vision.]

Cinematography:
Camera shot: [framing and angle, e.g. wide establishing shot, eye level]
Mood: [overall tone, e.g. cinematic and tense, playful and suspenseful, luxurious anticipation]

Actions:
- [Action 1: a clear, specific beat or gesture]
- [Action 2: another distinct beat within the clip]
- [Action 3: another action or dialogue line]

Dialogue:
[If the shot has dialogue, add short natural lines here or as part of the actions list. Keep them brief so they match the clip length.]
提示词示例
示例 1
Style: Hand-painted 2D/3D hybrid animation with soft brush textures, warm tungsten lighting, and a tactile, stop-motion feel. The aesthetic evokes mid-2000s storybook animation — cozy, imperfect, full of mechanical charm. Subtle watercolor wash and painterly textures; warm–cool balance in grade; filmic motion blur for animated realism.

Inside a cluttered workshop, shelves overflow with gears, bolts, and yellowing blueprints. At the center, a small round robot sits on a wooden bench, its dented body patched with mismatched plates and old paint layers. Its large glowing eyes flicker pale blue as it fiddles nervously with a humming light bulb. The air hums with quiet mechanical whirs, rain patters on the window, and the clock ticks steadily in the background.

Cinematography:
Camera: medium close-up, slow push-in with gentle parallax from hanging tools
Lens: 35 mm virtual lens; shallow depth of field to soften background clutter
Lighting: warm key from overhead practical; cool spill from window for contrast
Mood: gentle, whimsical, a touch of suspense

Actions:
- The robot taps the bulb; sparks crackle.
- It flinches, dropping the bulb, eyes widening.
- The bulb tumbles in slow motion; it catches it just in time.
- A puff of steam escapes its chest — relief and pride.
- Robot says quietly: "Almost lost it… but I got it!"

Background Sound:
Rain, ticking clock, soft mechanical hum, faint bulb sizzle.
示例 2
风格:1970年代浪漫剧情片,使用35毫米胶片拍摄,带有自然光晕、柔焦和温暖的泛光效果。轻微的胶片抖动和手持微晃营造出复古的亲密感。温暖的柯达风格调色;灯泡上轻微的光晕;胶片颗粒和柔和的暗角增添时代真实感。

在黄金时刻,一座砖砌公寓楼的屋顶变成了一个小舞台。晾衣绳上挂着的白床单随风摇曳,捕捉着最后一缕阳光。一串串不匹配的节日灯泡在头顶微微闪烁。一位身着飘逸红丝绸裙的年轻女子赤脚起舞,卷发在渐暗的光线中闪闪发光。她的舞伴——袖子卷起,背带松松垮垮——跟着拍手,笑容灿烂而毫无防备。楼下,城市里充斥着汽车喇叭声、地铁震动和远处的笑声。

摄影:
镜头:中远景,从视线高度缓慢推近
镜头:40毫米球面镜头;浅景深将这对情侣从城市天际线中分离出来
灯光:金色自然主光搭配钨丝反光;来自节日灯泡的边缘光
氛围:怀旧、温柔、电影感

动作:
- 她旋转;裙摆展开,捕捉阳光。
- 女子(笑着):"看?今晚连城市都在和我们共舞。"
- 他走上前,抓住她的手,将她带入阴影中。
- 男子(微笑):"那是因为你在领舞。"
- 床单飘过画面,短暂遮住天际线,然后又分开。

背景声音:
仅自然环境声:微弱的风声、布料飘动声、街道噪音、低沉的音乐。无额外配乐。
常见问题
常见错误包括:提示词过于模糊导致生成结果不符;视频质量不佳(缺乏细节或风格描述不明确);视频内容不符合预期(对模型能力理解偏差)。排查方法:检查提示词是否包含主体、动作、场景、风格、镜头语言等要素;确保无矛盾信息;增加描述性词汇;明确指定风格和镜头语言;调整提示词以匹配模型擅长生成的场景。生产环境优化:使用角色 API 保持角色一致性;利用视频编辑进行微调而非重新生成;通过扩展 API 构建长序列;使用批处理 API 处理大规模任务;合理选择分辨率与时长以平衡质量与成本。
企业应用扩展
未来 Sora 2 可能引入更长的视频生成、音频支持等功能。开发者可关注 OpenAI 官方文档更新,探索多模态输入(如音频、3D 场景)与视频生成的结合。此外,可尝试将 Sora 2 与其他 AI 工具(如图像生成、语音合成)集成,构建完整的视频制作流水线。提示词工程将向更结构化、模板化方向发展,支持更精细的控制与创意表达。
总结
本教程面向有编程基础的开发者,系统讲解 OpenAI Sora 2 视频生成模型的提示词工程。内容涵盖提示词结构、API 参数、端点、角色与图像输入、视频编辑与扩展等高级功能。通过对比弱/强提示词、提供模板与示例,帮助开发者掌握从基础到专业的提示词编写技巧,实现精准控制与创意发挥。同时包含常见问题排查与生产环境优化建议,助力 AI 工程实践落地。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:中级
- 验证等级:V1
- 原文作者:rkoenig-openai, joanneshin-openai, annikab-oai
- 原文日期:2026-03-12
- 来源许可:MIT
- 来源版本:
edc8b8d6185baa8abae41a437c519fe2576ca266 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员