使用CLIP嵌入和GPT-4 Vision提升多模态RAG
技术背景
传统RAG系统主要处理文本,无法利用图像信息,限制了在图像问答、视觉搜索等场景的应用。多模态RAG通过结合文本和图像数据,提供更丰富的上下文,提升生成答案的质量。CLIP模型通过对比学习将图像和文本映射到同一向量空间,使得图像和文本可以互相检索。GPT-4 Vision支持图像输入,能够理解图像内容并生成文本。结合两者,可以构建强大的多模态RAG系统,解决图像信息利用不足的问题。
核心原理
CLIP模型使用对比学习训练,将图像和文本编码到同一向量空间,使得相似的图像和文本在向量空间中距离更近。在RAG系统中,使用CLIP嵌入将图像库中的每张图像转换为向量,存入向量数据库。查询时,将用户文本查询转换为CLIP嵌入,通过相似性搜索检索最相关的图像。检索到的图像与查询文本一起作为上下文输入GPT-4 Vision,生成答案。GPT-4 Vision能够理解图像内容,结合文本描述,提供更准确的回答。
架构分析
系统架构包括图像嵌入生成模块、向量数据库、检索模块和生成模块。图像嵌入生成模块使用CLIP模型将图像转换为向量;向量数据库(如Chroma或FAISS)存储图像向量及其路径;检索模块将查询文本转换为向量,通过相似性搜索找到最相似的图像;生成模块使用GPT-4 Vision将检索到的图像和查询文本结合生成答案。设计上,直接嵌入图像避免了文本字幕的有损过程,提高了检索准确性。
完整实战教程
使用CLIP嵌入和GPT-4 Vision的多模态RAG
多模态RAG(检索增强生成)通过结合文本和图像数据,能够提供更丰富的上下文,从而提升生成答案的质量。然而,传统的RAG系统主要处理文本,难以有效利用图像信息。本文介绍如何利用CLIP嵌入将图像和文本映射到同一向量空间,并结合GPT-4 Vision实现多模态检索和生成。
多模态RAG的挑战
标准RAG系统通常使用文本嵌入模型(如OpenAI的text-embedding-ada-002)将文档分块并索引。当查询到来时,系统检索最相关的文本块,并将其作为上下文提供给语言模型。这种方法在处理纯文本时效果良好,但无法利用图像中的信息。
多模态RAG需要解决两个关键问题:
- 如何索引和检索图像:需要一种能够理解图像内容的嵌入模型。
- 如何将检索到的图像信息用于生成:需要一种能够处理图像输入的语言模型。
CLIP嵌入简介
CLIP(Contrastive Language-Image Pre-training)是由OpenAI开发的模型,它通过对比学习将图像和文本映射到同一向量空间。CLIP模型可以计算图像和文本之间的相似度,从而实现图像-文本匹配。
在RAG系统中,我们可以使用CLIP嵌入来索引图像,并通过文本查询检索最相关的图像。例如,我们可以将图像库中的每张图像转换为CLIP嵌入,并将这些嵌入存储在向量数据库中。当用户提出查询时,我们将查询文本转换为CLIP嵌入,并检索与查询嵌入最相似的图像。
使用LangChain和Chroma实现多模态RAG
我们将使用LangChain框架和Chroma向量数据库来构建多模态RAG系统。具体步骤如下:
1. 安装依赖
首先,安装必要的库:
pip install langchain chromadb openai
2. 加载图像并生成CLIP嵌入
我们将使用langchain中的OpenCLIPEmbeddings类来生成图像和文本的CLIP嵌入。以下示例展示了如何加载图像并生成嵌入:
from langchain.embeddings import OpenCLIPEmbeddings
from langchain.vectorstores import Chroma

# 初始化CLIP嵌入模型
clip_embeddings = OpenCLIPEmbeddings(model_name="ViT-B-32", checkpoint="laion2b_s34b_b79k")

# 加载图像(假设图像路径列表)
image_paths = ["image1.jpg", "image2.jpg", "image3.jpg"]

# 生成图像嵌入
image_embeddings = clip_embeddings.embed_documents(image_paths)
3. 创建向量数据库
将图像嵌入存储在Chroma中,并关联图像路径:
# 创建向量数据库
vectorstore = Chroma.from_embeddings(
    image_embeddings,
    image_paths,
    embedding=clip_embeddings,
    persist_directory="./chroma_db"
)
4. 检索相关图像
当用户查询时,我们将查询文本转换为CLIP嵌入,并检索最相似的图像:
query = "一只猫在草地上"
query_embedding = clip_embeddings.embed_query(query)

# 检索最相似的图像
results = vectorstore.similarity_search_by_vector(query_embedding, k=2)
for result in results:
    print(result.page_content)  # 图像路径
5. 使用GPT-4 Vision生成答案
检索到相关图像后,我们可以使用GPT-4 Vision模型(支持图像输入)来生成答案。以下示例展示了如何将图像和查询一起发送给GPT-4 Vision:
from langchain.chat_models import ChatOpenAI
from langchain.schema import HumanMessage

# 初始化GPT-4 Vision模型
llm = ChatOpenAI(model="gpt-4-vision-preview", max_tokens=1024)

# 构建消息,包含图像和文本
message = HumanMessage(
    content=[
        {"type": "text", "text": f"根据图像回答:{query}"},
        {"type": "image_url", "image_url": {"url": result.page_content}}
    ]
)

# 生成答案
response = llm([message])
print(response.content)
完整示例
以下是一个完整的示例,展示了如何将上述步骤整合到一个函数中:
from langchain.embeddings import OpenCLIPEmbeddings
from langchain.vectorstores import Chroma
from langchain.chat_models import ChatOpenAI
from langchain.schema import HumanMessage

def multimodal_rag(query, image_paths):
    # 初始化CLIP嵌入
    clip_embeddings = OpenCLIPEmbeddings(model_name="ViT-B-32", checkpoint="laion2b_s34b_b79k")

    # 生成图像嵌入
    image_embeddings = clip_embeddings.embed_documents(image_paths)

    # 创建向量数据库
    vectorstore = Chroma.from_embeddings(
        image_embeddings,
        image_paths,
        embedding=clip_embeddings,
        persist_directory="./chroma_db"
    )

    # 检索相关图像
    query_embedding = clip_embeddings.embed_query(query)
    results = vectorstore.similarity_search_by_vector(query_embedding, k=2)

    # 使用GPT-4 Vision生成答案
    llm = ChatOpenAI(model="gpt-4-vision-preview", max_tokens=1024)
    message = HumanMessage(
        content=[
            {"type": "text", "text": f"根据图像回答:{query}"},
            {"type": "image_url", "image_url": {"url": results[0].page_content}}
        ]
    )
    response = llm([message])
    return response.content

# 使用示例
image_paths = ["cat.jpg", "dog.jpg", "landscape.jpg"]
answer = multimodal_rag("描述图像中的动物", image_paths)
print(answer)
结论
通过结合CLIP嵌入和GPT-4 Vision,我们可以构建一个强大的多模态RAG系统,能够检索和利用图像信息来增强生成答案。这种方法在图像问答、视觉搜索和内容生成等场景中具有广泛的应用前景。
希望本文能帮助您理解多模态RAG的实现方法,并激发您在自己的项目中应用这些技术。
多模态RAG将额外的模态集成到传统的基于文本的RAG中,通过提供额外的上下文和基于文本的数据来增强LLM的问答能力,从而提高理解力。
采用服装搭配师cookbook中的方法,我们直接嵌入图像进行相似性搜索,绕过了文本字幕的有损过程,以提高检索准确性。
使用基于CLIP的嵌入进一步允许使用特定数据进行微调或使用未见过的图像进行更新。
该技术通过使用用户提供的技术图像搜索企业知识库来展示,以提供相关信息。
安装
首先,让我们安装相关的包。
#installations
%pip install clip
%pip install torch
%pip install pillow
%pip install faiss-cpu
%pip install numpy
%pip install git+https://github.com/openai/CLIP.git
%pip install openai
然后让我们导入所有需要的包。
# model imports
import faiss
import json
import torch
from openai import OpenAI
import torch.nn as nn
from torch.utils.data import DataLoader
import clip
client = OpenAI()

# helper imports
from tqdm import tqdm
import json
import os
import numpy as np
import pickle
from typing import List, Union, Tuple

# visualisation imports
from PIL import Image
import matplotlib.pyplot as plt
import base64
现在让我们加载CLIP模型。
#load model on device. The device you are running inference/training on is either a CPU or GPU if you have.
device = "cpu"
model, preprocess = clip.load("ViT-B/32",device=device)
现在我们将:
- 创建图像嵌入数据库
- 设置对视觉模型的查询
- 执行语义搜索
- 将用户查询传递给图像
创建图像嵌入数据库
接下来,我们将从图像目录创建图像嵌入知识库。这将是我们搜索的技术知识库,用于为用户上传的图像提供信息。
我们传入存储图像(JPEG格式)的目录,并遍历每个图像以创建嵌入。
我们还有一个description.json。它为知识库中的每个图像都有一个条目。它有两个键:'image_path'和'description'。它将每个图像映射到该图像的有用描述,以帮助回答用户的问题。
首先,让我们编写一个函数来获取给定目录中的所有图像路径。然后,我们将从一个名为 'image_database' 的目录中获取所有 jpeg 文件。
def get_image_paths(directory: str, number: int = None) -> List[str]:
    image_paths = []
    count = 0
    for filename in os.listdir(directory):
        if filename.endswith('.jpeg'):
            image_paths.append(os.path.join(directory, filename))
            if number is not None and count == number:
                return [image_paths[-1]]
            count += 1
    return image_paths
direc = 'image_database/'
image_paths = get_image_paths(direc)
接下来,我们将编写一个函数,根据一系列路径从CLIP模型中获取图像嵌入。
我们首先使用之前获得的预处理函数对图像进行预处理。这会执行一些操作,以确保输入到CLIP模型的数据具有正确的格式和维度,包括调整大小、归一化、颜色通道调整等。
然后,我们将这些预处理后的图像堆叠在一起,以便一次性将它们传入模型,而不是在循环中逐个传入。最后,返回模型输出,即嵌入数组。
def get_features_from_image_path(image_paths):
  images = [preprocess(Image.open(image_path).convert("RGB")) for image_path in image_paths]
  image_input = torch.tensor(np.stack(images))
  with torch.no_grad():
    image_features = model.encode_image(image_input).float()
  return image_features
image_features = get_features_from_image_path(image_paths)
现在我们可以创建向量数据库了。
index = faiss.IndexFlatIP(image_features.shape[1])
index.add(image_features)
同时,我们也会摄取用于图像描述映射的 JSON,并创建一个 JSON 列表。我们还创建了一个辅助函数,用于在列表中搜索我们想要的特定图像,从而获取该图像的描述。
data = []
image_path = 'train1.jpeg'
with open('description.json', 'r') as file:
    for line in file:
        data.append(json.loads(line))
def find_entry(data, key, value):
    for entry in data:
        if entry.get(key) == value:
            return entry
    return None
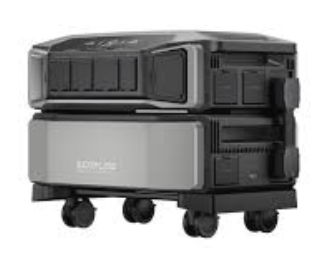
让我们展示一张示例图片,这将是用户上传的图片。这是2024年国际消费电子展(CES)上发布的一项技术。它就是DELTA Pro Ultra全屋电池发电机。
im = Image.open(image_path)
plt.imshow(im)
plt.show()
查询视觉模型
现在让我们看看 GPT-4 Vision(之前没有见过这种技术)会将其标记为什么。
首先,我们需要编写一个函数,将图像编码为base64格式,因为这是我们传递给视觉模型的格式。然后,我们将创建一个通用的image_query函数,以便我们能够使用图像输入来查询LLM。
def encode_image(image_path):
    with open(image_path, 'rb') as image_file:
        encoded_image = base64.b64encode(image_file.read())
        return encoded_image.decode('utf-8')

def image_query(query, image_path):
    response = client.chat.completions.create(
        model='gpt-4-vision-preview',
        messages=[
            {
            "role": "user",
            "content": [
                {
                "type": "text",
                "text": query,
                },
                {
                "type": "image_url",
                "image_url": {
                    "url": f"data:image/jpeg;base64,{encode_image(image_path)}",
                },
                }
            ],
            }
        ],
        max_tokens=300,
    )
    # Extract relevant features from the response
    return response.choices[0].message.content
image_query('Write a short label of what is show in this image?', image_path)
正如我们所见,它尽力根据训练数据中的信息进行推断,但由于训练数据中未见过类似情况,它犯了一个错误。这是因为该图像具有模糊性,使得外推和推断变得困难。
执行语义搜索
现在让我们执行相似性搜索,在知识库中找到两张最相似的图像。我们通过嵌入用户提供的 image_path,并检索数据库中图像的索引和相似度分数来实现这一点。分数越大表示相似度越高,因此我们按降序对分数进行排序。
image_search_embedding = get_features_from_image_path([image_path])
distances, indices = index.search(image_search_embedding.reshape(1, -1), 2) #2 signifies the number of topmost similar images to bring back
distances = distances[0]
indices = indices[0]
indices_distances = list(zip(indices, distances))
indices_distances.sort(key=lambda x: x[1], reverse=True)
我们使用索引来搜索 image_directory,并选择相应的图像传递给视觉模型进行 RAG。
让我们看看它返回了什么(我们按相似度顺序显示):
#display similar images
for idx, distance in indices_distances:
    print(idx)
    path = get_image_paths(direc, idx)[0]
    im = Image.open(path)
    plt.imshow(im)
    plt.show()
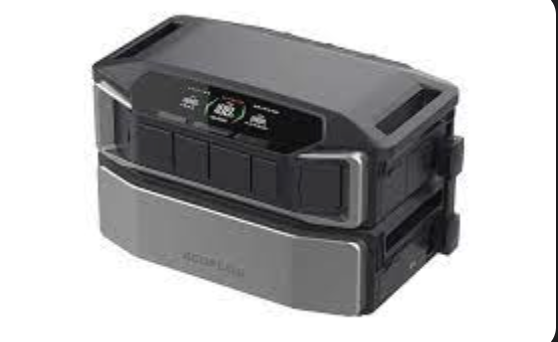
这里我们可以看到,它返回了两张包含 DELTA Pro Ultra 家用电池发电机的图片。其中一张图片还有一些可能分散注意力的背景,但它仍然成功找到了正确的图片。
用户查询最相似的图像
现在,对于最相似的图片,我们希望将其及其描述连同用户查询一起传递给gpt-v,以便用户可以询问他们可能购买的技术。这就是视觉模型强大之处,你可以向模型提出未经明确训练的通用查询,而模型会以高精度进行响应。
在下面的示例中,我们将查询所讨论物品的容量。
similar_path = get_image_paths(direc, indices_distances[0][0])[0]
element = find_entry(data, 'image_path', similar_path)

user_query = 'What is the capacity of this item?'
prompt = f"""
Below is a user query, I want you to answer the query using the description and image provided.

user query:
{user_query}

description:
{element['description']}
"""
image_query(prompt, similar_path)
我们看到它能够回答这个问题。这只有通过直接匹配图像,并从中收集相关描述作为上下文才能实现。
结论
在本笔记本中,我们介绍了如何使用CLIP模型,包括使用CLIP模型创建图像嵌入数据库的示例,执行语义搜索,最后提供用户查询来回答问题。
这种使用模式的应用跨越了许多不同的应用领域,并且很容易进一步改进以增强该技术。例如,你可以微调CLIP,可以像在RAG中那样改进检索过程,还可以对GPT-V进行提示工程。
常见问题
常见错误包括:1. 图像路径错误导致加载失败,需检查路径和文件格式;2. CLIP模型加载失败,需确保安装正确版本和依赖;3. 向量数据库持久化问题,需指定正确的persist_directory;4. GPT-4 Vision API调用失败,需检查API密钥和模型名称;5. 嵌入维度不匹配,需确保查询和图像嵌入使用相同模型。排查方法包括打印错误信息、检查数据格式、验证API响应。
企业应用扩展
生产环境优化:1. 使用GPU加速CLIP嵌入生成;2. 使用更高效的向量数据库如FAISS或Milvus;3. 对CLIP模型进行微调以适应特定领域;4. 使用缓存减少重复计算;5. 对GPT-4 Vision进行提示工程优化;6. 考虑使用多模态模型如LLaVA替代GPT-4 Vision以降低成本。
总结
本文介绍如何利用CLIP嵌入将图像和文本映射到同一向量空间,结合GPT-4 Vision构建多模态RAG系统。通过CLIP模型生成图像嵌入,存入向量数据库,实现基于文本查询的图像检索,再将检索到的图像与用户查询一起发送给GPT-4 Vision生成答案。文章详细讲解了实现步骤、代码示例和完整流程,并讨论了多模态RAG的挑战、CLIP原理、系统架构、常见问题及优化方案,帮助开发者掌握多模态检索增强生成的实际应用。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:中级
- 验证等级:V1
- 原文作者:dylanra-openai
- 原文日期:2024-04-10
- 来源许可:MIT
- 来源版本:
0dc70a07eff34b3b2410d33f82cf0634a0be1e45 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员