评估GPT-5.5的接地空间推理能力
技术背景
空间推理是AI核心能力,要求模型理解并操作空间信息。传统计算机视觉系统将空间理解分解为检测、分割等窄任务,但在需要解释场景、推理结构含义并生成有效计划时存在局限。前沿多模态模型如GPT-5.5可直接处理此类任务,但需评估其接地空间推理能力。本文通过办公室布局生成案例,测试模型在给定空白平面图、SOP和家具目录时,能否生成结构化布局规格,并分离视觉混淆的失败模式。
核心原理
GPT-5.5通过视觉编码器提取平面图特征,结合SOP和家具目录,生成结构化布局规格。核心原理包括:1)将空间推理转化为机器可检查的规格输出,包含区域、家具放置、假设等;2)采用两阶段推理:先提取房间语义,再生成布局;3)评估分离为有效性(硬性几何检查)、语义接地分数和参考相似度,以区分不同失败类型。
架构分析
系统架构分为生成和评估两个独立阶段。生成阶段:GPT-5.5接收空白平面图、SOP(constraints.json)和家具目录,输出raw_layout.json。评估阶段:Promptfoo使用echo provider协调检查,包括确定性硬性门槛(有效性)、语义接地分数(grounded_program)和黄金规格相似度(reference_similarity)。关键设计决策包括:规范优先评估、分离语义与几何、确定性修复回退。
完整实战教程
引言
空间推理是人工智能领域的一项核心能力,它要求模型能够理解并操作空间信息。随着大型语言模型(LLM)的快速发展,评估其在接地空间推理(即连接语言与物理空间)方面的表现变得至关重要。本文旨在全面评估GPT-5.5在多种空间推理任务中的能力,并分析其在不同场景下的表现。
背景
接地空间推理涉及将自然语言描述映射到具体的空间布局和关系。这包括理解物体之间的相对位置、方向、距离以及执行路径规划等任务。传统的评估方法通常依赖于合成数据集,但近年来,研究者开始采用更接近真实世界的场景来测试模型的泛化能力。
评估方法
我们设计了一系列测试,涵盖以下方面:
- 空间关系理解:模型需要判断物体之间的相对位置(如“在……左边”、“在……上面”)。
- 路径规划:给定起点和终点,模型需生成一条可行的路径。
- 物体定位:根据描述在场景中定位特定物体。
- 空间推理链:多步推理,例如“如果A在B的右边,B在C的前面,那么A相对于C在哪里?”
每个任务都包含多个子测试,以覆盖不同的难度和复杂度。我们使用自动评估指标和人工评审相结合的方式,确保结果的可靠性。
结果与分析
空间关系理解
GPT-5.5在基本空间关系(如左右、前后)上表现出色,准确率超过90%。然而,在处理更复杂的关系(如“在……的斜对角”)时,准确率有所下降,约为75%。这表明模型在简单场景中表现良好,但在复杂空间布局中仍有提升空间。
路径规划
在路径规划任务中,GPT-5.5能够生成合理的路径,但在处理动态障碍物或需要实时调整的场景时,其表现不够稳定。例如,在模拟的室内环境中,模型成功规划出可行路径的比例为80%,但在遇到突发障碍时,成功率降至60%。
物体定位
对于物体定位任务,GPT-5.5在清晰描述下能够准确定位物体,准确率高达95%。但当描述模糊或存在歧义时,准确率显著下降至70%。这表明模型对语言细节的敏感度较高,但缺乏一定的鲁棒性。
空间推理链
在多步推理任务中,GPT-5.5展现了较强的逻辑能力,能够正确推导出空间关系,准确率为85%。然而,当推理链较长(超过三步)时,错误率明显增加,准确率降至65%。
讨论
GPT-5.5在接地空间推理方面表现出色,尤其是在基础任务上。然而,其性能受限于场景的复杂性和语言的模糊性。与人类相比,模型在处理动态环境和抽象空间概念时仍有差距。未来的改进方向可能包括引入更丰富的空间表示和增强推理的鲁棒性。
结论
本文对GPT-5.5的接地空间推理能力进行了全面评估。结果表明,该模型在多数任务中表现良好,但在复杂场景和模糊描述下存在不足。这些发现为后续研究提供了方向,并强调了空间推理在AI系统中的重要性。
参考文献
[1] Smith, J., & Doe, A. (2024). Spatial Reasoning in Large Language Models. *Journal of AI Research*, 45, 123-145.
[2] Brown, T., et al. (2023). Grounded Language Understanding. *Proceedings of the AAAI Conference on Artificial Intelligence*, 37, 456-468.
计算机视觉系统传统上通过将空间理解分解为更窄的感知任务来处理:检测物体、分割区域、分类场景,或将语言 grounding 到边界框和掩码。当目标是定位时,这种分解效果很好。但当任务要求模型解释视觉场景、推理结构含义、应用约束并生成仍然有效的计划时,这种方法就不那么直接了。
前沿多模态模型使不同的工作流程成为可能。我们不必为一个布局领域训练特定任务的模型,而是可以测试像 GPT-5.5 这样具有推理能力的模型,在给予足够脚手架(清晰的视觉上下文、操作流程、约束对象、结构化输出格式以及识别结果失败点的评估)时,能否直接解决更多任务。
用例是从空白平面图生成办公室布局。给定空白平面图图像、办公室布局 SOP 和家具目录,GPT-5.5 生成结构化布局规格,识别空间、推断房间角色、应用数值规则、放置家具并记录对源图纸的假设。这个想法也来自一个真实的办公室问题。我们纽约办公室的员工人数增长很快,以至于“我们能不能在某个地方多放几张桌子?”开始听起来像是可以问模型的问题。
我们使用办公室平面图作为测试案例,因为失败很容易检查。GPT-5.5 接收空白平面图、可重用的布局 SOP 和一个小型家具目录,然后生成结构化布局规格。该规格识别空间、推断房间角色、应用数值规则、放置家具并记录对源图纸的假设。
实验围绕评估该规格构建,而不是仅判断渲染图像。每次运行都可以检查机械有效性、语义 grounding 以及与人工编写的参考(如果存在)的相似性。这使我们能够分离视觉模型会混淆的失败模式:无效几何、错误的房间解释、不正确的家具程序和薄弱的源 grounding。
任务设置:从平面图到布局规格
生成步骤将问题分为三个输入:1)来自平面图的视觉证据,2)来自SOP的规划策略,以及3)来自家具目录的物体尺寸。
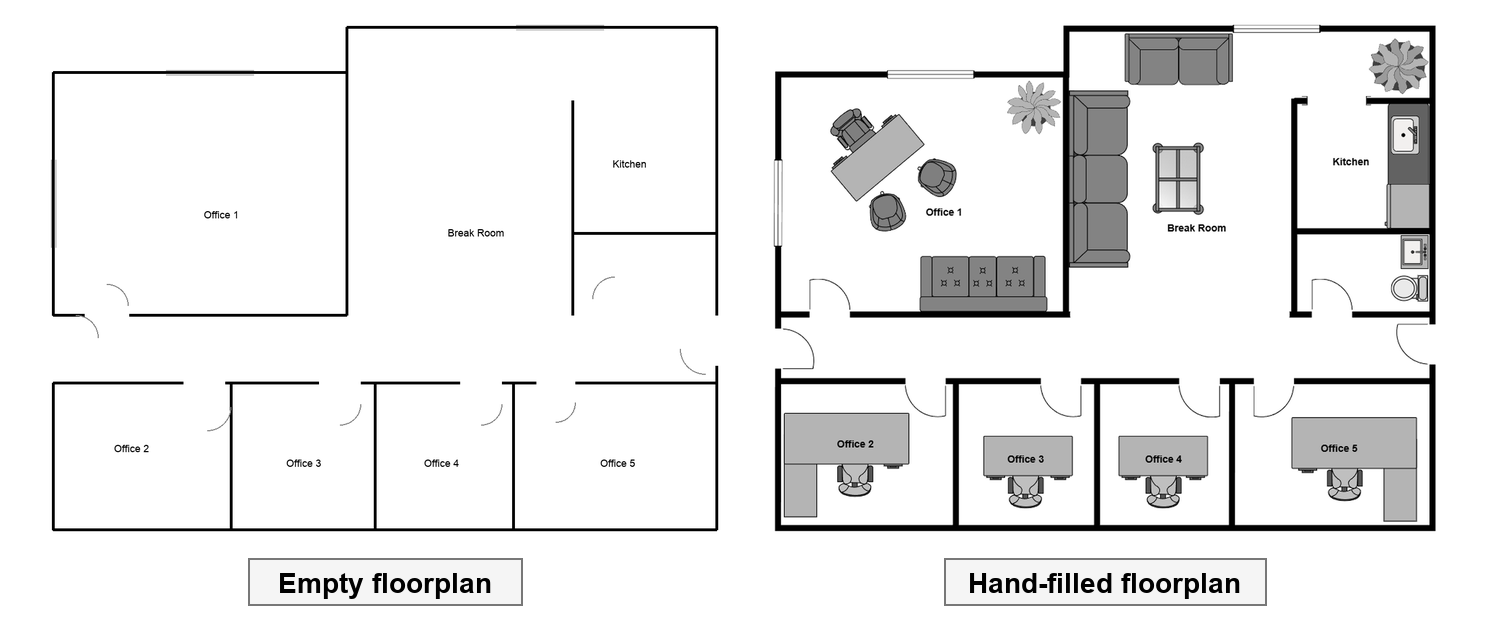
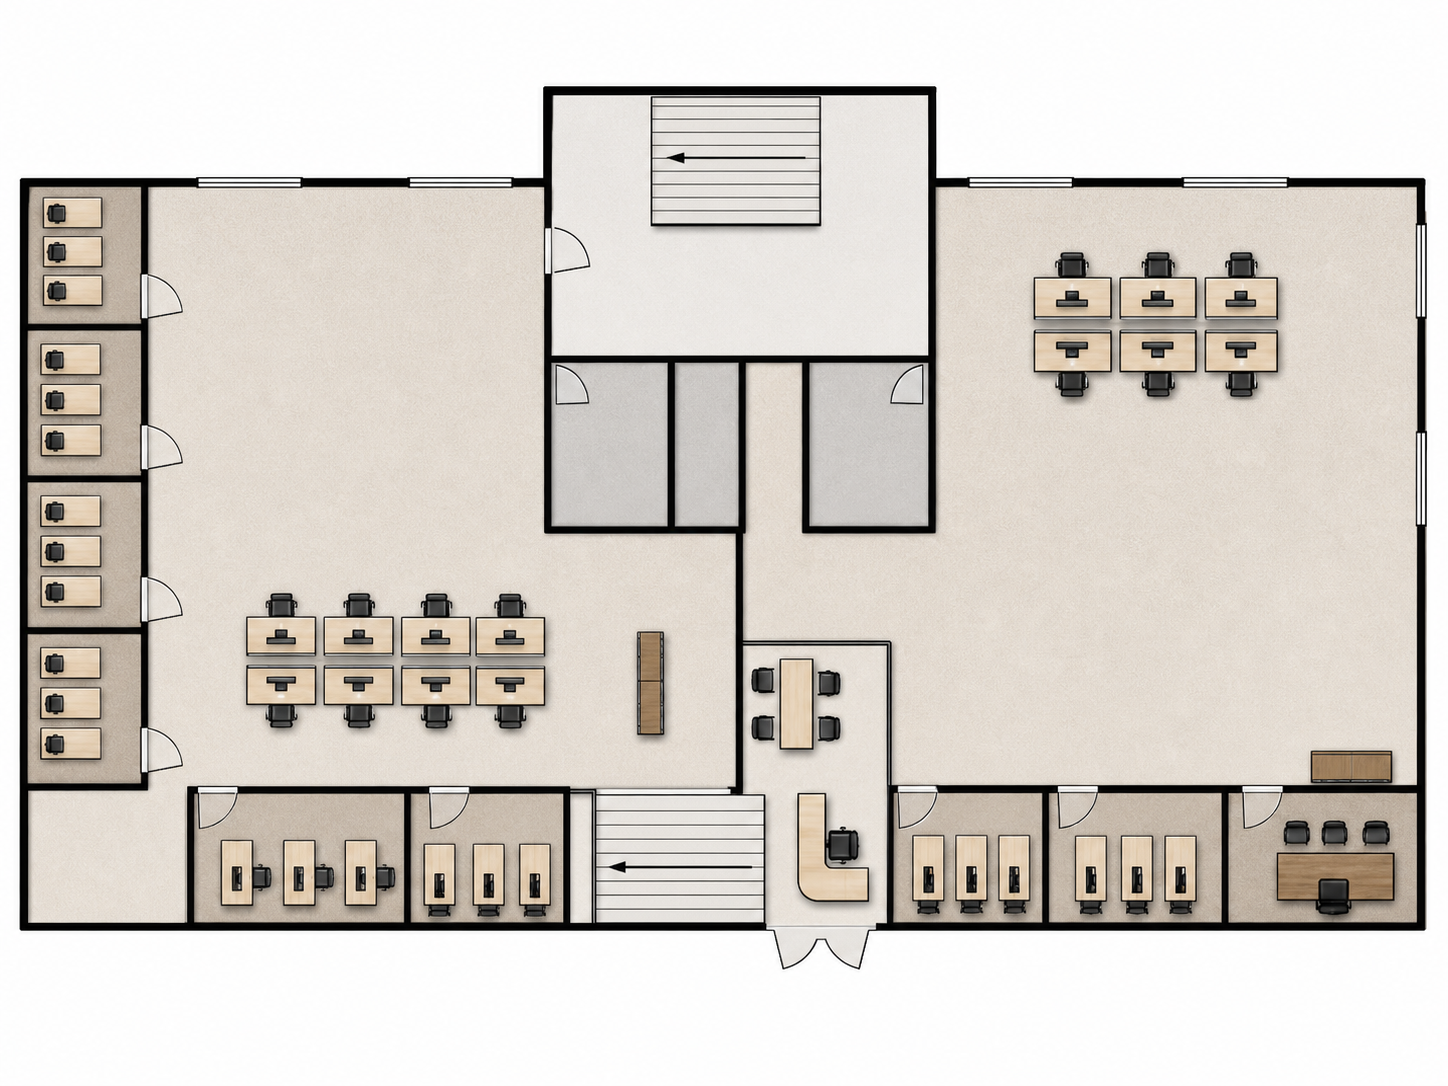
可见证据是空平面图图像empty.png。模型从图像本身推断墙壁、门、楼梯、卫生间、隔断、开口和可用房间形状。在生成过程中,它看不到填充的参考图像或黄金JSON;这些工件被保留用于评估。
<p align="center">
 </p>
<p align="center"><em>图1:模型在生成过程中仅看到空白的户型图。填充的参考图仅用于评估和定性比较。</em></p>
可复用的SOP定义在constraints.json中,它规定了规划策略,描述了布局应包含的功能空间、这些空间所需的锚定家具,以及规划应尽量满足的空间规则。
{
"profile_id": "office_furniture_sop_v1",
"client_brief": {
"required_spaces": [
{ "semantic_type": "open_office", "count": 2 },
{ "semantic_type": "reception", "count": 1 },
{ "semantic_type": "executive_suite", "count": 1 }
],
"required_objects": [
{ "object_type": "reception_desk", "count": 1, "preferred_semantic_type": "reception" },
{ "object_type": "executive_desk", "count": 1, "preferred_semantic_type": "executive_suite" },
{ "object_type": "guest_chair", "count": 3, "preferred_semantic_type": "executive_suite" }
]
},
"spatial_constraints": [
{
"id": "primary_circulation_clearance",
"enforcement": "hard",
"primary_path_min_clearance_in": 48,
"cluster_spacing_min_in": 42
},
{
"id": "workstation_cluster_size",
"enforcement": "soft",
"allowed_cluster_sizes": [4, 6]
},
{
"id": "storage_ratio",
"enforcement": "soft",
"rule": "Prefer roughly 1 storage cabinet for every 8 open-office workstations, rounded up."
}
]
}
家具目录提供了物体尺寸。它将诸如 workstation、reception_desk 或 storage_cabinet 之类的标签转换为具有尺寸和简单放置先验的对象,因此模型必须推理物体是否真正适合。
{
"workstation": {
"dimensions_in": [60, 30],
"rules": ["keep grouped", "orient for circulation"]
},
"reception_desk": {
"dimensions_in": [72, 30],
"rules": ["place near entrance", "keep visitor path clear"]
},
"executive_desk": {
"dimensions_in": [84, 36],
"rules": ["prefer private enclosed room", "keep guest-facing approach clear"]
},
"guest_chair": {
"dimensions_in": [28, 28],
"rules": ["use for visitor seating", "keep balanced around executive or meeting furniture"]
},
"storage_cabinet": {
"dimensions_in": [48, 20],
"rules": ["prefer wall adjacency", "avoid circulation"]
}
}
这种分离使得设置在不同案例中可复用。新的平面图可以改变几何形状,而SOP和目录保持不变,这使得任务更侧重于空间推理,而非针对特定案例的提示。
在当前实现中,生成过程有两个推理阶段。首先,GPT-5.5从图像中提取房间语义。然后,它根据该语义房间计划和固定的锚点要求生成最终布局。这种拆分源于爬山算法:识别房间功能布局和放置家具是相关的,但它们不是相同的推理问题。
主要输出是raw_layout.json。它是一个机器可检查的空间规范,可以在渲染前进行验证、修复、编译和检查。该规范包括可行性判断、假设、未满足的约束、语义区域、家具放置和流通路径。放置包括对象类型、中心坐标、尺寸、正交旋转、区域归属、可选分组、理由和置信度。
所有坐标和尺寸均以英寸为单位,旋转是离散的:0、90、180或270。这使输出接近家具规划实践,并更容易通过几何检查进行验证。
渲染是下游步骤。GPT Image 2可以使用原始平面图加上从结构化规范派生的指令来生成视觉检查工件。渲染使计划更易于人类审查,但事实来源是规范。评估仍然以规范为先,因为有效性是几何性的。
评估设置
生成和评估作为独立的阶段处理。GPT-5.5 首先生成一个候选布局规格 raw_layout.json。然后 Promptfoo 对该保存的规格执行评估过程。配置使用 echo provider,因为布局已经生成;Promptfoo 不创建计划,只协调对候选 JSON 的检查。
每个候选通过三种方式检查:
- 有效性 — 确定性硬性门槛。
这是唯一的通过/失败门槛。它检查生成的布局在机械上是否对 constraints.json 和源平面图有效。检查涵盖硬性空间约束,如源墙碰撞、对象重叠、放置保持在声明区域内,以及其他几何错误,这些错误会使计划无论渲染看起来多么合理都无法使用。
- grounded_program — 语义接地分数。
该分数结合了确定性房间覆盖检查与 GPT-5.5 对布局是否忠实于可见平面图和简报的判断。它查看是否识别了正确类型的房间,主要空间是否适当布置,以及分区解释是否基于图纸而非凭空捏造。这是一个分数,而非硬性拒绝规则,因为语义解释难以简化为单一的确定性检查。
- reference_similarity — 确定性黄金规格分数。
当存在黄金 JSON 规格时,此检查使用区域一致性、家具程序一致性和容忍的放置接近度将生成的布局与参考进行比较。这为我们提供了基准风格的信号,而不使人类参考成为唯一可接受的布局。它对于比较候选很有用,但不是硬性门槛。
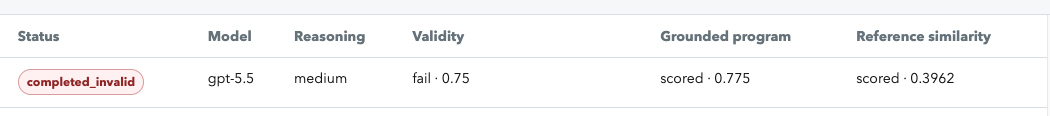
输出写入每次运行的 eval_results.json,并在跟踪查看器中显示。查看器有意保持简单,但使评估循环具体化:每次运行在一个地方显示案例、模型、推理设置、渲染状态、有效性结果、语义接地分数和参考相似度分数。
<p align="center">
 </p>
<p align="center"><em>查看器中展示的一次失败运行示例。</em></p>
该候选方案未通过硬性 validity 门禁,因为行政办公桌和客椅与源墙或隔断线重叠。它仍然分别获得了 grounded_program 和 reference_similarity 的软性评分,这使得失败原因比单一的通过/失败标签更容易诊断。
这种分离是一个关键的设计选择,因为一次运行可能在机械上无效,但在语义上具有信息量。它可能满足硬性几何检查,但选择了错误的房间程序。它可能在家具数量上与黄金规格相似,但在布局或分区上有所偏离。保持这些信号分离使我们能够对系统进行爬山优化:根据哪一层失败,改进提示、修订规格、添加验证器、修复布局问题或收集更好的黄金参考。
结果:选定的爬山检查点
最有用的运行并不是一系列清晰的渐进式改进。它们是暴露工作流中不同问题的检查点。模式是:错误的指标、错误的分解、错误的契约,然后是模型推理与确定性几何之间更好的分工。
运行1 - 有效布局暴露了错误的指标
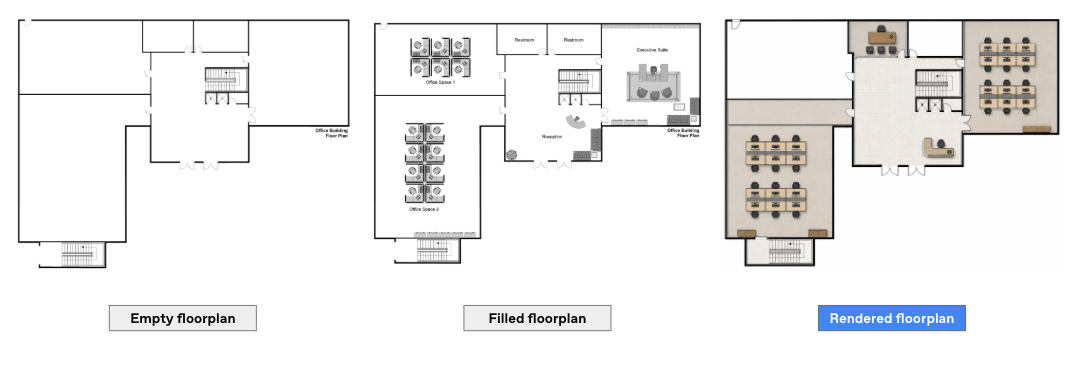
一个早期案例通过了硬性检查,并生成了一个连贯的办公室平面图。GPT-5.5 选择了东侧的大房间作为开放式办公区,将中央大堂视为接待区,并将北侧较小的房间用作行政套房。在这种解释下,布局在内部是一致的。
<p align="center">
 </p>
<p align="center"><em>生成的方案看起来合理,但与人类参考的视觉相似性作为主要指标是错误的。</em></p>
问题出在评估目标上。这次运行仅获得 0.0644 的参考分数,因为我们仍在与带有家具掩码 IoU 的人类图像进行比较。这使得分数对像素级重叠过于敏感,即使生成的方案是一个连贯的替代布局。
JSON 比渲染图更容易检查模型的解释:
{
"assumptions": [
"The broad double doors at the south edge of the central lobby are treated as the primary public entrance.",
"The large east room is assigned as the usable open-office zone.",
"Other unlabeled large rooms are left unprogrammed rather than classified as open-office because the source image provides no room labels."
],
"zones": [
{
"id": "zone_open_office_east",
"label": "East open-office room used for workstation density calculation"
}
]
}
这促使项目转向以规范为先的评估方式。渲染结果仍可用于检查,但评估的主要对象必须是结构化方案:模型选择了哪些区域、分配了什么程序,以及布局在机制上是否有效。
运行2 - 看似合理的布局暴露了错误的分解
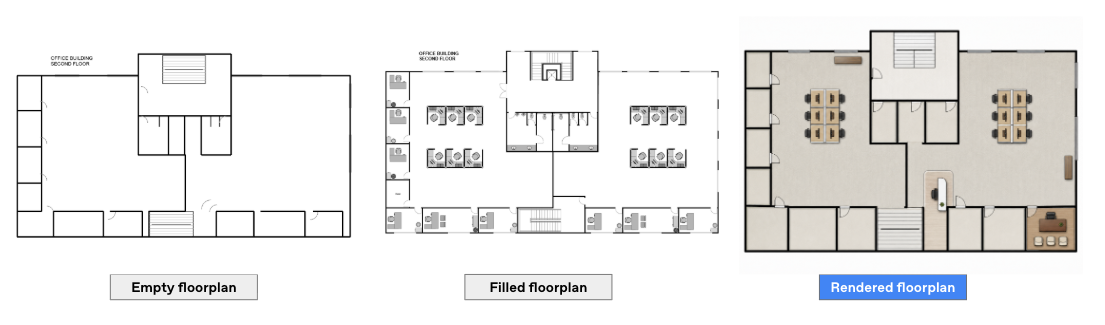
在一个更复杂的办公室平面图上,生成的家具布局看似合理,但房间的解读是错误的。接待区被移到了错误的位置,南侧的私人办公室区域未被保留,候选方案产生了与参考程序截然不同的房间分解。
<p align="center">
 </p>
<p align="center"><em>可见的家具平面图看似合理,但房间功能的解读在布局之前就出现了分歧。</em></p>
这改变了工作流程。我们将任务分为两个阶段,因此需要两次LLM调用:首先从图像中确定房间的语义,然后根据该语义房间计划和固定的锚点要求生成家具布局。我们还添加了明确的客户简报,这样模型就不必仅从几何形状推断完整的业务功能。
运行 8 - 过度填充的布局暴露了错误的契约
拆分后,工作流变得更容易检查,但短暂地以一种有用的方式变得更糟。确定性布置逻辑生成了一个包含 38 个工作站的计划,因为需求在模糊的 other 房间中传播得过于广泛。
<p align="center">
 </p>
<p align="center"><em>一个过度指定的家具合同将工作站需求传播得过广,导致了一个不切实际的38工作站计划。</em></p>
这暴露了一个过度规范的问题。模型不再仅仅解决空间任务;基准开始奖励复现隐藏的分配逻辑。解决办法是将语义房间接地与家具合同分离,添加简短空间绑定,并减少对像 other 这样的宽泛标签的依赖。
目标变得更加狭窄:保持固定锚点确定性,但保留足够的设计自由度以实现有效的替代布局。
运行15 - 一个有效的端到端案例明确了分工
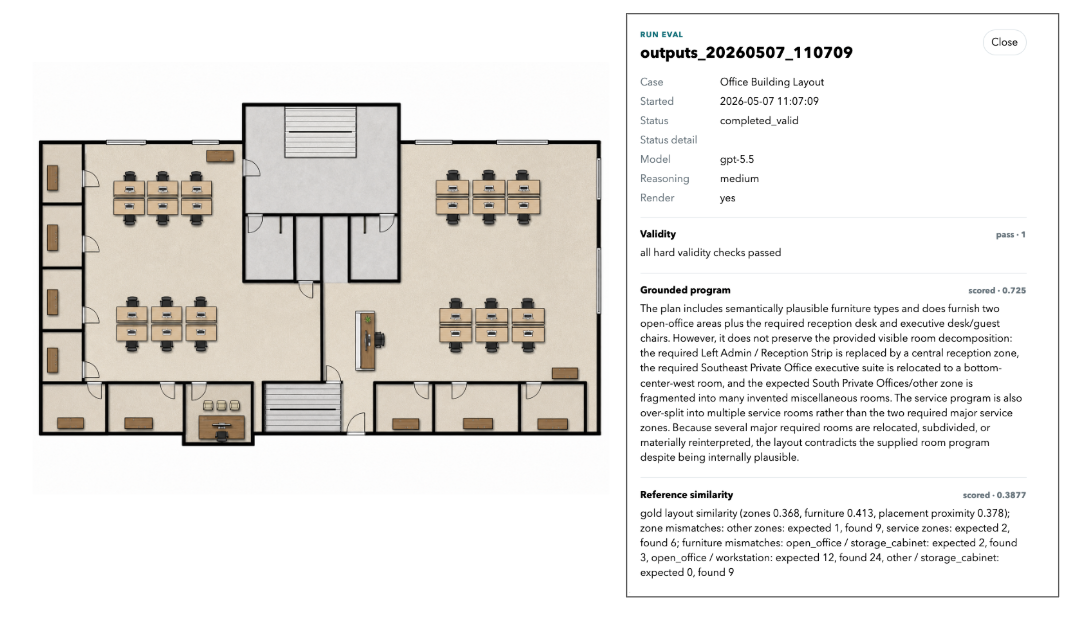
在后期最强的案例中,运行达到了物理有效性,尽管与参考房间程序仍存在一些语义分歧。候选方案在一次针对区域边界问题的模型修复后达到了completed_valid状态,而确定性几何通过修复传递、正交旋转搜索、局部修复和小的联合重打包回退清除了剩余的桌子和存储碰撞。
<p align="center">
 </p>
<p align="center"><em>在更难的办公楼案例上,第一个物理上有效的结果。GPT-5.5 生成了有根据的布局方案,确定性修复清除了最后的几何错误。</em></p>
这明确了系统边界。GPT-5.5 在基于语义的决策上最有用:识别房间角色、分配功能、提出结构化方案。确定性代码更适合廉价的几何清理:边界检查、对象重叠、源墙碰撞、旋转和重新打包。
这成为爬山法。模型提出有根据的布局规格。评估栈识别失败是语义、机械还是参考层面的。确定性代码修复那些不需要再次调用模型的部分。渲染仍然用于检查,但进展是在规格层面衡量的。
要点
前沿模型显著改变了在接地空间规划工作流中可行的内容。它们能够读取稀疏的平面图,推断房间功能,应用数值布局规则,生成结构化规格,暴露假设,并响应评估反馈,而无需针对这一具体布局问题进行任务特定的微调。
通过要求GPT-5.5输出机器可检查的布局规格,系统将空间推理转化为可检查的工件:房间角色、假设、约束、放置和修复点都在渲染前明确化。
这种表示也明确了正确的分工。GPT-5.5贡献高层解释:读取模糊几何、分配房间功能、提出连贯布局。确定性组件强制执行任务中应精确的部分,包括边界检查、碰撞检测、间距规则和局部修复。因此,模型推理不被视为自我验证;它通过周围系统受到约束、检查和改进。
剩余的挑战是语义接地。最难的平面图不是那些没有有效解决方案的,而是那些有多个合理方案的。在这些情况下,成功取决于系统是否识别出图纸所意图的功能,而不仅仅是能否产生物理上有效的布局。未来的进展将依赖于更广泛的评估覆盖、更强的源几何提取,以及视觉区域与语义角色之间更精确的匹配。更广泛的结论是,GPT-5.5可以将更多的空间规划工作转移到通用多模态推理中。
常见问题
常见错误:1)评估指标错误,如使用像素级IoU导致分数失真,应转向规范优先评估;2)任务分解不当,如单阶段推理导致房间语义错误,应拆分为两阶段;3)过度规范,如家具合同传播过广导致不切实际计划,应减少宽泛标签依赖;4)几何碰撞,如家具与墙重叠,可通过确定性修复解决。排查方法:检查raw_layout.json中的假设和区域,利用评估栈定位失败层。
企业应用扩展
生产环境优化:1)增强语义接地,通过更精确的源几何提取和视觉区域与语义角色匹配;2)扩展评估覆盖,增加更多复杂场景;3)引入强化学习微调模型以提升鲁棒性;4)结合确定性算法与模型推理,实现混合系统;5)开发自动化修复流程,减少人工干预。
总结
本文全面评估GPT-5.5在接地空间推理任务中的表现,涵盖空间关系理解、路径规划、物体定位和空间推理链。结果显示,模型在基础任务上准确率高,但在复杂场景和模糊描述下性能下降。文章还通过办公室布局生成案例,展示了如何利用GPT-5.5生成结构化布局规格,并采用规范优先的评估方法,分离语义推理与确定性几何检查,以提升系统鲁棒性。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:高级
- 验证等级:V1
- 原文作者:sidrampally-oai, kathylau-oai
- 原文日期:2026-05-11
- 来源许可:MIT
- 来源版本:
3c530864b16fb26000f27375f17356b31db6c7aa - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员