提示缓存高级指南:优化策略与性能影响
技术背景
在大语言模型推理中,预填充阶段(处理输入令牌)是计算和延迟的主要瓶颈。对于包含大量重复内容(如系统指令、工具定义)的请求,每次重新计算这些前缀的键值(KV)张量会浪费大量资源。提示缓存通过复用先前计算的前缀KV缓存,显著降低首字延迟和输入成本。它适用于对话系统、代理循环、工具调用等场景,但要求精确的前缀匹配,且受限于路由和缓存容量。
核心原理
提示缓存的核心是KV缓存。在Transformer注意力层中,每个令牌被转换为查询(Q)、键(K)和值(V)向量。模型通过点积计算注意力分数,并加权求和值向量。KV缓存存储了前缀所有令牌的键和值张量。当新请求共享相同前缀时,模型直接复用缓存的KV张量,仅计算新令牌的注意力,从而跳过预填充计算。缓存命中需要精确的前缀匹配,且以128个令牌为增量,自动应用于1024个令牌以上的提示。
架构分析
系统架构上,请求根据提示前约256个令牌的哈希值路由到推理引擎。缓存仅在同一机器上有效,因此路由粘性至关重要。prompt_cache_key参数可增强路由粘性,类似于数据库分片键,需平衡粒度以控制每台机器的请求速率(约15 RPM)。扩展提示缓存将KV张量卸载到本地存储,延长保留时间至24小时。Responses API通过持久化推理令牌,相比Chat Completions能提高缓存利用率。
完整实战教程
注意: 本指南仅适用于 GPT-5.6 之前的模型。对于 GPT-5.6 及更高版本,请参阅 提示缓存指南。
一份关于提示缓存的实用指南:基础知识、性能影响、测量方法和优化策略。
1. 提示缓存基础
模型提示通常包含重复内容,例如系统指令、工具和消息。当请求包含系统最近处理过的前缀时,OpenAI 可以将其路由到已计算该前缀的服务器,使模型能够复用先前的工作,而不是从头重新计算。
提示缓存可以将首字延迟降低高达 80%,输入令牌成本降低高达 90%。它自动应用于所有 API 请求,且不收取额外费用。
本手册的目标是深入探讨如何优化缓存命中。请查阅我们的 API 文档 和 提示缓存 101 以获得很好的概述——让我们深入探讨吧!
1.1 基础知识
- 缓存命中需要精确的、重复的前缀匹配,并且对于包含 1024 个或更多令牌的提示自动生效,缓存命中以 128 个令牌为增量。
- 整个请求前缀都是可缓存的:消息、图像、音频、工具定义和结构化输出模式。
- 内存提示缓存自动应用于您的所有 API 请求。扩展提示缓存将其延长至 24 小时。
- 仅当两个请求共享相同前缀并落在同一台机器上时,缓存才有效。利用可选参数
prompt_cache_key来路由共享公共前缀的流量,以改善路由。 - 仔细考虑上下文工程技术(如压缩)对缓存的影响。
- 在迭代时,通过请求日志或使用情况仪表板监控缓存、成本和延迟。
2. 为什么缓存很重要
2.1 核心技术原因:跳过预填充计算
在输入令牌上通过 Transformer 层的前向传递是推理成本和延迟的主要驱动因素。在 Transformer 堆栈中,提示缓存特别适用于注意力层内的键和值投影。注意力是一种机制,允许模型在处理特定令牌时权衡输入序列不同部分的重要性,使它们能够捕获上下文和长距离依赖关系。
当您向 OpenAI 发出请求时,我们会创建令牌嵌入,然后将其转换为三个向量:查询(Q)表示该令牌需要自我上下文化的内容,键(K)编码每个令牌代表的内容,值(V)包含如果相关则可以合并的信息。模型通过点积将当前令牌的查询与所有令牌的键进行比较,以产生注意力分数。经过 softmax 后,这些分数成为权重,决定每个令牌的值对更新表示的贡献程度。例如,在短语“她坐在河岸边”中,单词“river”为“bank”提供了重要的上下文,将其含义推向水生而非金融。KV 缓存存储该前缀在所有层和头部的键和值张量。
如果你随后发出另一个请求——“她坐在阴天河岸上”——前缀的第一部分是相同的。在处理新的、未见过的后缀时,模型会复用缓存的张量,并且只计算新令牌的注意力。
关键在于,“river”和“bank”之间的强语义关系已经在此前的正向传播中被编码到那些缓存的键和值表示中。模型不需要重新计算“bank”如何与“river”对齐。相反,像“cloudy”和“day”这样的新令牌会生成自己的查询,并关注前缀中缓存的键。换句话说,语义基础已经奠定;模型只是在该现有注意力状态之上构建,而不是从头重新计算。
2.2 成本影响
缓存折扣可能非常显著。折扣幅度因模型系列而异——随着我们的推理栈变得更加高效,我们最新的模型能够提供更大幅度的缓存折扣。以下是一些示例,但请参阅我们的定价页面以了解所有模型。提示缓存已对所有近期模型(gpt-4o及更新版本)启用。
| 模型 | 输入<br>(每百万令牌) | 缓存输入<br>(每百万令牌) | 缓存折扣 |
| --- | --- | --- | --- |
| gpt-4o | $2.50 | $1.25 | 50.00% |
| gpt-4.1 | $2.00 | $0.50 | 75.00% |
| gpt-5-nano | $0.05 | $0.005 | 90.00% |
| gpt-5.2 | $1.75 | $0.175 | 90.00% |
| gpt-realtime(音频) | $32.00 | $0.40 | 98.75% |
2.3 延迟影响
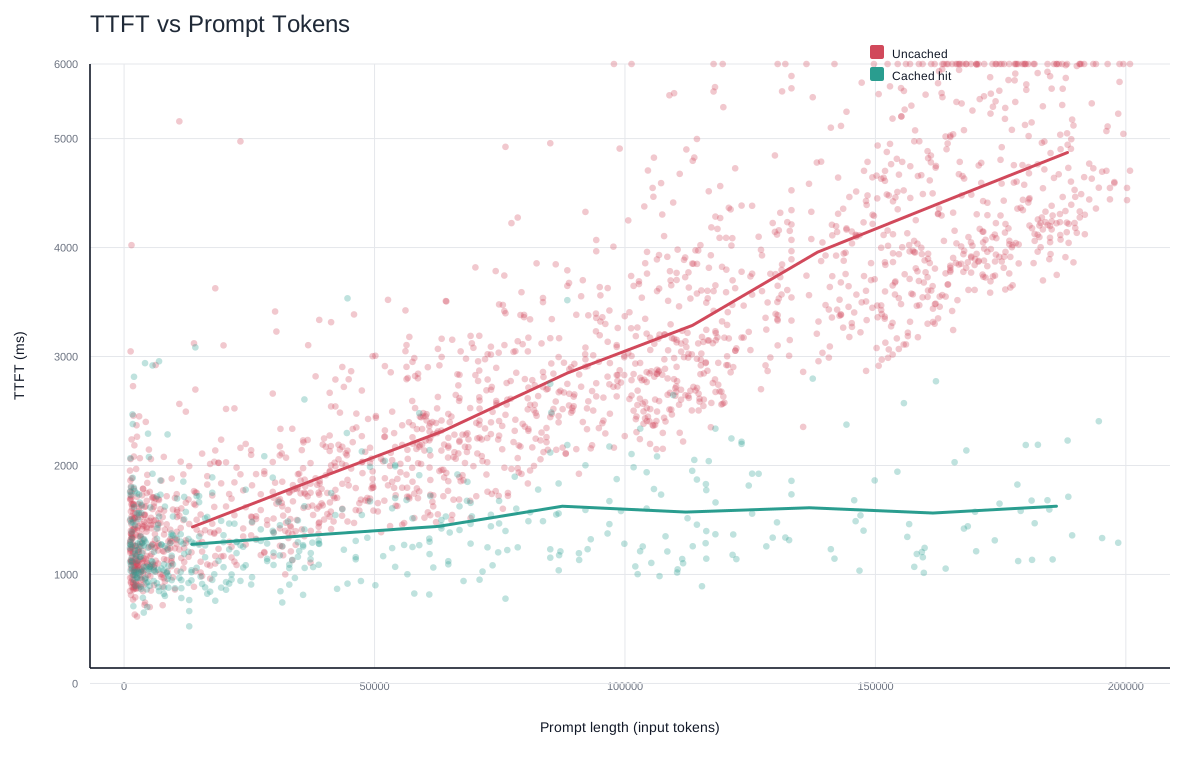
减少首令牌时间(TTFT)是提高缓存命中率的主要动机。缓存令牌可以将延迟降低多达约80%。
缓存使延迟大致与生成输出长度成正比,而不是与整个对话长度成正比,因为完整的上下文历史不会被重新预填充。当我们获得缓存命中时,模型采样是线性的,而不是二次的。
我运行了一系列提示2300次,并绘制了缓存与未缓存请求的对比。对于最短的提示(1024个令牌),缓存请求快7%,但在较长的一端(15万+令牌),我们看到TTFT快67%。输入越长,缓存对首令牌延迟的影响就越大。
 ## 3. 先测量缓存(以便迭代)
3.1 每次请求:cached_tokens
响应中包含 usage 字段,指示有多少提示词 token 是从缓存中提供的。所有请求都会在 usage.prompt_tokens_details Response 或 Chat 对象中显示一个 cached_tokens 字段,指示有多少提示词 token 被缓存。
"usage": {
"prompt_tokens": 2006,
"completion_tokens": 300,
"total_tokens": 2306,
"prompt_tokens_details": {
"cached_tokens": 1920
},
"completion_tokens_details": {
"reasoning_tokens": 0,
"accepted_prediction_tokens": 0,
"rejected_prediction_tokens": 0
}
}
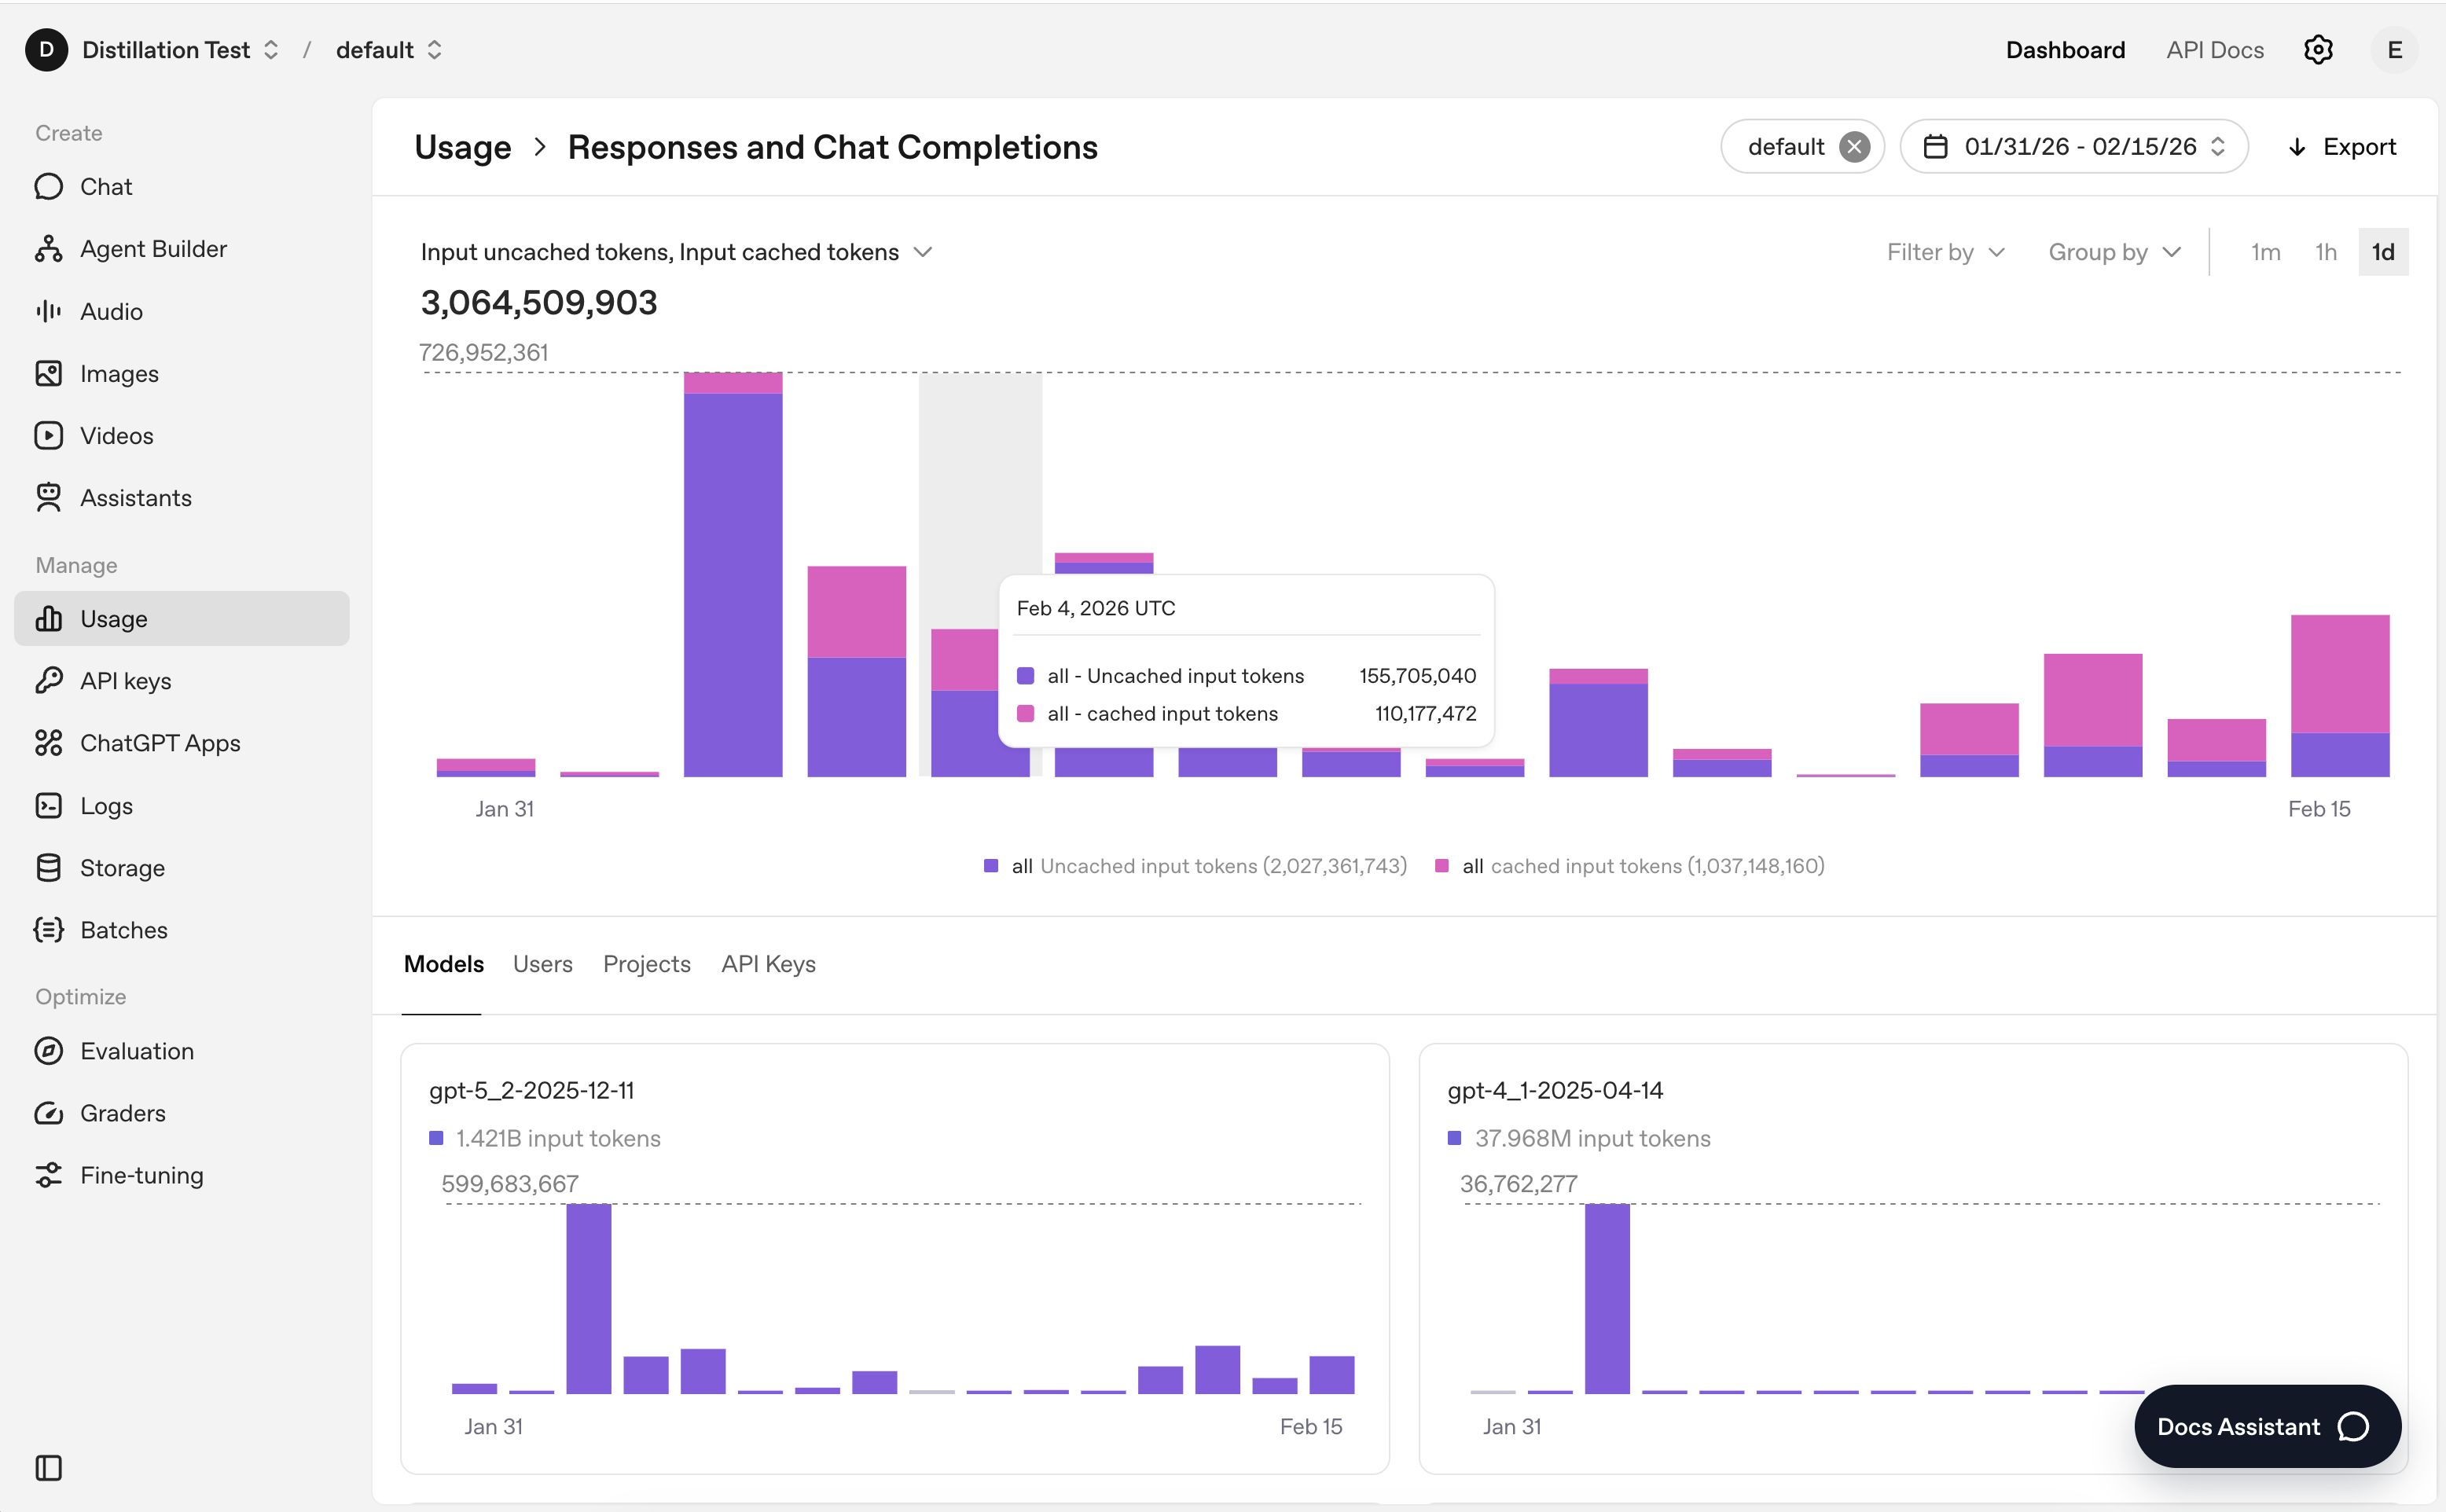
你还可以通过在使用量仪表板中筛选选定的缓存/未缓存令牌,获得这些指标的高层概览。
 ## 4. 提高缓存命中率(战术手册)
什么是缓存命中?即请求与前一个请求具有相同前缀,系统可以复用先前计算出的键/值张量,而无需重新计算。提高缓存命中率——最大化前缀可被复用的频率——直接提升性能和效率,因此最大化缓存命中率是我们的目标!
4.1 发送超过 1024 个令牌的提示
这可能感觉有违直觉,但在某些情况下,稍微加长提示可以降低总体成本。
假设你有一个 900 个令牌的提示——你永远不会获得缓存命中。如果你将提示加长到 1100 个令牌并获得 50% 的缓存命中率,你将节省 33% 的令牌成本。如果获得 70% 的缓存命中率,你将节省 55%。一旦你跨越缓存阈值并实现有意义的复用,那些重复令牌的边际成本就会大幅下降。这意味着一个稍长但稳定的前缀可能比一个从不缓存的较短提示更便宜。
4.2 稳定前缀
这是投入最少、影响最大的优化:保持提示的早期部分稳定。
将持久内容放在开头:
- 指令
- 工具定义
- 模式
将易变内容(例如用户输入、动态值、会话特定数据)放在末尾。即使早期令牌的微小变化也会使精确前缀匹配失效,并阻止缓存命中。
来自 Codex 的经验
当我们的工程团队概述他们如何构建 Codex 代理循环时,他们强调提示结构是一流的性能表面,并将缓存作为首要任务。在 Codex CLI 中,系统指令、工具定义、沙箱配置和环境上下文在请求之间保持相同且顺序一致,以保留长而稳定的提示前缀。代理循环在对话中途运行时配置发生变化(例如新的工作目录或审批模式)时,会追加新消息(而不是修改早期消息)。通过避免更改原始前缀,系统保留了精确前缀匹配,这是提示缓存命中所必需的。
提示:使用元数据
我们见过客户在请求早期包含时间戳以便后续查找/调试,从而意外使缓存失效。请将其移至 metadata 中,这样就不会影响缓存!
4.3 保持工具和模式一致
工具、模式及其顺序有助于缓存前缀——它们会在开发者指令之前被注入,这意味着更改它们会使缓存失效。这包括:
- 模式键更改
- 工具顺序更改
- 指令更改
提示:在不破坏提示缓存的情况下调整工具
利用 allowed_tools tool_choice 选项。它允许你在不更改工具数组和破坏缓存的情况下限制模型在请求中可调用的工具。在 tools 中列出你的完整工具集,然后使用 allowed_tools 块指定在单轮中可以使用哪个工具。
# Static “tools” stay in the cached prompt prefix:

tools = [get_weather_def, get_location_def, calendar_def, …]

# Per-call “allowed_tools” only lives in request metadata, not in the prefix:

allowed_tools = {"mode":"auto", "tools":["get_weather","get_location"]}
4.4 使用 prompt_cache_key 提高路由粘性
缓存仅在两个请求共享相同前缀并落在同一台机器上时才有效。请求根据提示词前约256个令牌的哈希值被路由到推理引擎。当你提供 prompt_cache_key 时,它会与该哈希值结合,以提高路由粘性——这意味着具有相同前缀的请求更有可能落在同一引擎上并重用缓存的KV状态。这非常有效——我们的一位编码客户在开始使用 prompt_cache_key 后,命中率从60%提升到了87%。
prompt_cache_key 在发送具有相同初始上下文(即前256个令牌)但后续不同的请求时特别有用,因为它允许你有意地对相关请求进行分组。
推理引擎每个前缀加 prompt_cache_key 组合大约可以处理每分钟约15个请求。如果流量超过该速率——例如,你发送数千个共享相同前缀和键的请求——系统会将多余的请求分发到其他机器上进行负载均衡。每台新机器都会产生一次性的缓存未命中。
这意味着你应该选择一种键的粒度,使每个前缀加键的组合保持在每分钟约15个请求以下。
对于编码用例,我们观察到:
- 按用户键可以提高跨相关对话的重用率(例如,在同一个代码库中工作)。
- 按对话键在用户并行运行多个不相关线程时扩展性更好。
将多个用户分组共享一个键也是一种好方法。一个简单的算法是,将用户ID进行哈希并取模,分配到一定数量的“桶”中,以接近每分钟15个请求为目标,从而最大化缓存性能。
提示:测试Flex处理而不是Batch API
如果你有对延迟不敏感的工作流,你可能正在使用Batch API。为了在缓存方面获得更多灵活性,可以考虑使用Flex处理。Flex提供与Batch相同的50%令牌折扣,但通过Responses API运行,并在每个请求中指定 service_tier="flex"。这为你提供了更多灵活性:
- 控制请求速率(RPM)
- 访问扩展提示缓存
- 能够包含
prompt_cache_key
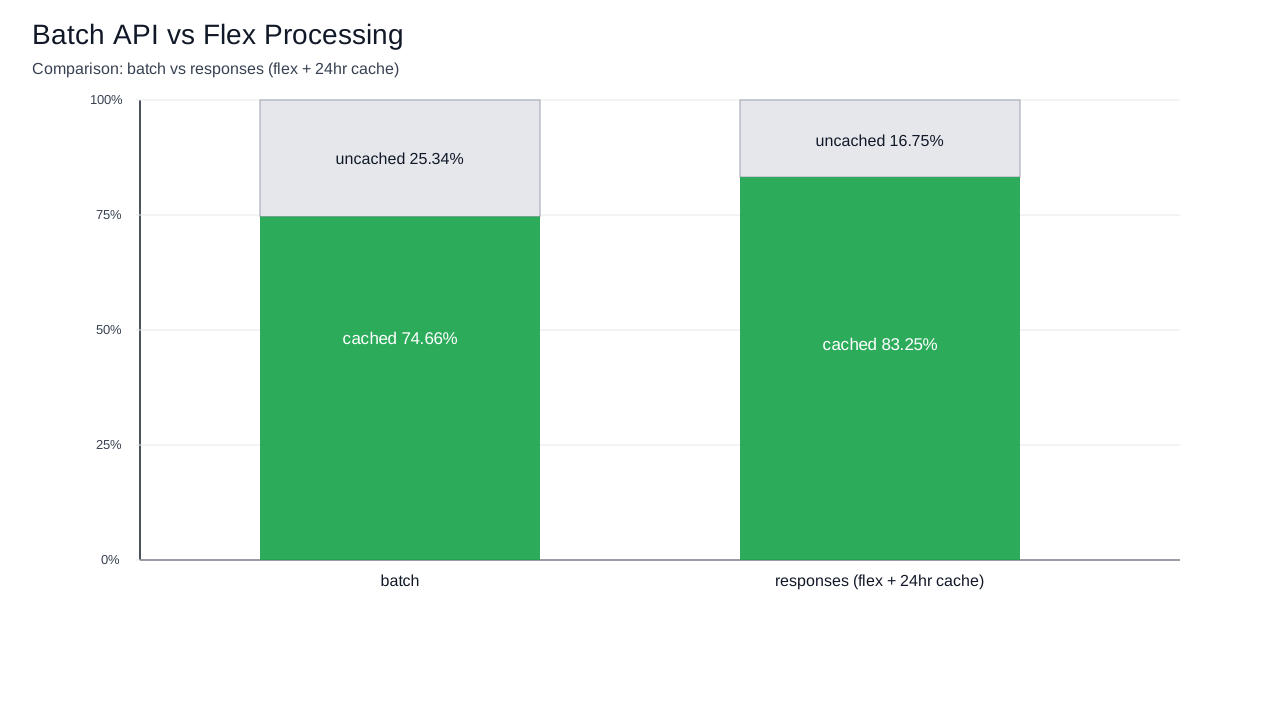
由于你可以更精确地调整路由和缓存局部性,Flex在某些工作负载中可以实现更高的缓存命中率。它特别适合原型设计或对推理要求不高的生产工作负载,同时仍能受益于成本优化。
我进行了一项对比测试,发送了10,000个相同的请求。Flex(使用扩展提示缓存和 prompt_cache_key)与Batch作业相比,缓存命中率提高了8.5%。这一改进转化为输入令牌成本降低了23%。
 Batch API 上的缓存没有模型对等性——GPT-5 之前的模型不受支持,因此如果你使用的是 o3 或 o4-mini,应考虑切换到 Flex 以利用缓存。请在我们的定价文档中查看最新信息。
洞察:将 prompt_cache_key 视为分片键
在考虑后端如何路由请求时,将 prompt_cache_key 视为数据库分片键可能会有所帮助——在优化该参数时,考虑因素非常相似。与分片键一样,粒度是一种平衡行为。每台机器对于给定前缀只能处理大约 15 RPM,因此如果你在太多请求上使用相同的键,请求将溢出到多台机器。对于每台新机器,你将重新开始缓存。另一方面,如果你的键过于狭窄,流量会分散到多台机器上,你将失去缓存重用的好处。路由仍然是负载均衡的——prompt_cache_key 增加了相似提示命中同一服务器的机会,但并不保证粘性——缓存始终是尽力而为!
4.5 使用 Responses API 而不是 Chat Completions
正如我们在为什么我们构建 Responses API中概述的,我们的内部基准测试显示,与 Chat Completions 相比,请求的缓存利用率提高了 40-80%。
这是因为,与 Chat Completions 不同,原始思维链令牌在 Responses API 中通过 previous_response_id(或如果你是无状态的,则使用加密推理项)在轮次之间持久化。Chat Completions 不提供持久化这些令牌的方法。如果你没有利用推理模型,则没有缓存改进。使用 Responses API 的推理模型获得更好的性能是更深入理解这一点的绝佳指南。
4.6 深思熟虑的上下文工程
从本质上讲,上下文工程是关于决定每次请求中模型输入的内容。每个模型都有固定的上下文窗口,但策划每次请求传递的内容不仅仅是保持在限制之内。随着输入的增长,你不仅接近截断——你还在增加重放成本,并要求模型将其注意力分配到更多令牌上。有效的上下文工程是有意识地管理这种约束的实践。
然而,当你删除、总结或压缩对话中的早期轮次时,你会破坏缓存。在这方面,上下文工程和提示缓存本质上是对立的——一个优先考虑动态性,另一个优先考虑稳定性。
随着更长运行的代理和原生压缩工具的出现,在架构设计时牢记缓存以确保成本与智能节省之间的正确平衡非常重要。
response = client.responses.create(
model="gpt-5.2-codex",
input=conversation,
store=False,
context_management=[{"type": "compaction", "compact_threshold": 100000}],
)
一个常见的失败模式是工具集过度膨胀,导致在调用哪个工具时产生歧义。保持工具表面最小化可以提高决策质量和长期上下文。在按请求整理工具时,使用技巧 4.3 并利用 allowed_tools 的 tool_choice 选项进行剪枝。
实用规则
利用你的评估来选择压缩方法和频率,以平衡成本(通过截断/摘要减少总输入令牌以及缓存)和通过仔细的上下文工程获得的智能。
5. 故障排除:为什么你可能会看到较低的缓存命中率:
常见原因:
- 工具或响应格式模式更改
- 因达到模型上下文窗口而进行的简单截断
- 指令或系统提示的更改
- 推理努力程度的更改
- 缓存过期:时间过长,保存的前缀被丢弃。
- 添加空格、时间戳或其他动态内容
- 使用带有推理模型的聊天补全,因为隐藏的思维链令牌被丢弃
6. 扩展提示缓存与零数据保留
扩展提示缓存 的工作原理是当内存已满时将键/值张量卸载到 GPU 本地存储,从而显著增加可用于缓存的存储容量。对于 gpt-5.5、gpt-5.5-pro 以及所有未来模型,默认值为 24h,且不支持 in_memory。
{
"model": "gpt-5.1",
"input": "Write me a haiku about froge...",
"prompt_cache_retention": "24h"
}
KV 张量是模型注意力层在预填充阶段产生的中间表示。只有键/值张量可以持久化存储在本地存储中;所有原始输入内容仅保留在内存中。
洞察:实际缓存的是什么?
KV 缓存仅保存模型的键/值张量(隐藏状态的线性投影),以便在下一步推理时重用。KV 缓存是一种中间表示。它本质上只是模型内部的一堆数字——这意味着无论保留策略如何,都不会存储原始文本/多模态输入。
7. 实时 API
实时 API 中的缓存工作方式与 Responses API 相同——所有传入的音频、文本或图像都会被缓存,前缀的任何更改都会破坏缓存。然而,鉴于实时 API 的上下文窗口较短(目前为 32k),管理截断尤为重要。一个具有 4,096 个最大输出 token 的 32k 上下文模型,在发生截断之前,上下文中只能包含 28,224 个 token。
7.1 保留比率
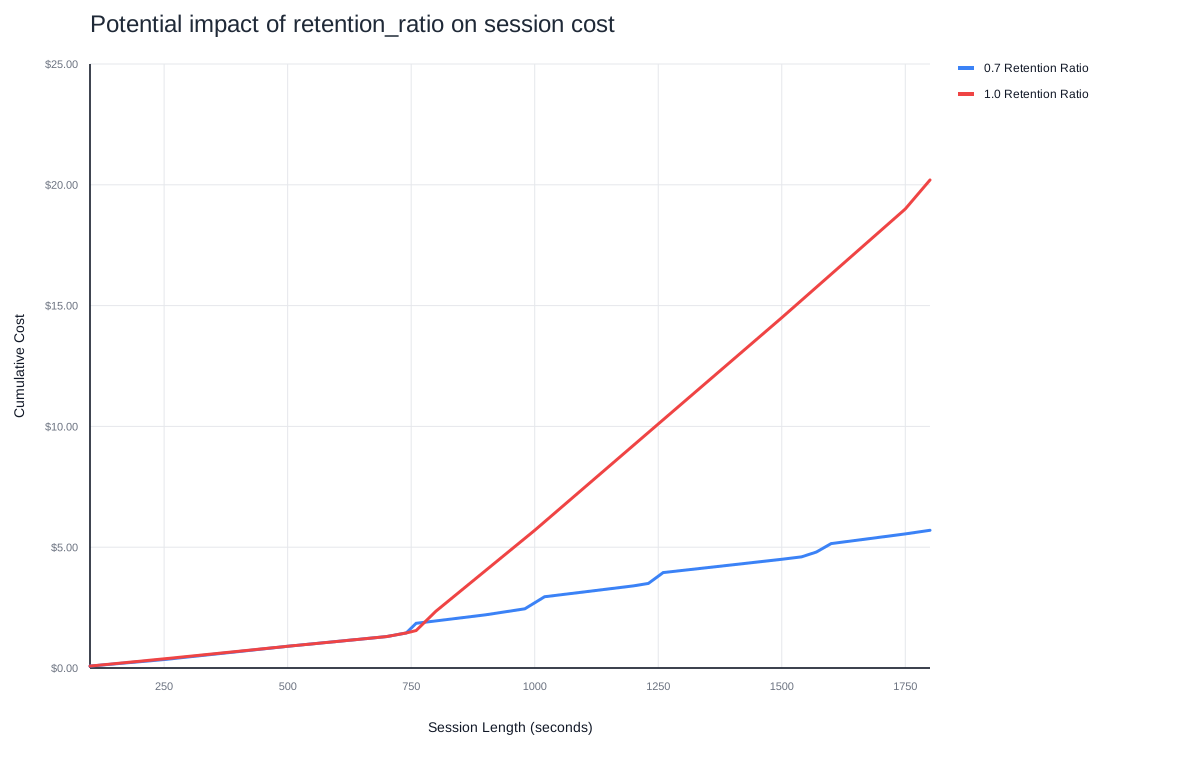
默认情况下(truncation: "auto"),服务器会移除刚好足够的旧消息以适应上下文窗口。这种“即时”修剪会在每次轮次超过限制时稍微移动对话的起始位置。然而,这种简单的策略会导致频繁的缓存未命中。
retention_ratio 设置通过让您控制保留多少早期上下文与丢弃多少来改变这一点。这是一种可配置的截断策略,允许开发人员控制保留多少 token 上下文窗口,从而在上下文保留和缓存命中优化之间取得平衡。
例如,retention_ratio: 0.7 意味着当发生截断时,系统保留现有对话窗口的大约 70%,并丢弃最旧的约 30%。丢弃发生在一个较大的截断事件中(而不是小的增量移除)。
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.7
}
}
}
这会创建一个更稳定的前缀,在多次对话轮次中保持不变,从而减少重复的缓存失效。
其代价是截断以更大的块进行,因此您可能会一次性丢失更多的对话历史。这意味着模型可能会比渐进式截断更早地突然“忘记”对话的早期部分。实际上,您是在用记忆深度换取缓存稳定性(更一致的前缀)。
以下是朴素逐轮截断方法与使用 retention_ratio 之间的影响对比。
 ## 结论
提示缓存是 OpenAI 平台上最具杠杆效应的优化之一。当你的前缀稳定且路由设计良好时,你可以在不改变模型行为或质量的情况下,显著降低成本和延迟。
关键思想简单但强大:稳定前缀、监控 cached_tokens、注意约 15 RPM 的限制,并明智地使用 prompt_cache_key。对于高吞吐量或对延迟不敏感的工作负载,可以考虑使用 Flex Processing 和扩展保留期,以进一步提高缓存局部性。
缓存是尽力而为且路由感知的,但当经过精心设计时,它可以带来显著的效率提升。像对待任何其他性能系统一样对待它:先测量,再迭代,并设计你的提示以考虑复用。
常见问题
常见缓存命中率低的原因包括:工具或模式更改、指令变化、上下文截断、缓存过期、添加动态内容(如时间戳)、使用Chat Completions导致推理令牌丢失。排查时应监控usage.prompt_tokens_details.cached_tokens字段,并检查请求日志。优化措施包括稳定前缀、将动态内容移至末尾、使用allowed_tools控制工具而不改变工具数组、合理设置prompt_cache_key、考虑使用Flex处理。
企业应用扩展
生产环境优化建议:1) 使用prompt_cache_key进行请求分组,控制粒度以维持15 RPM以下;2) 对于延迟不敏感工作负载,使用Flex处理替代Batch API,以获得更高缓存命中率;3) 利用retention_ratio控制实时API的截断策略,平衡上下文保留与缓存稳定性;4) 定期评估上下文压缩方法,避免破坏缓存;5) 监控缓存命中率并迭代优化提示结构。
总结
本指南面向有编程基础的开发者,深入讲解OpenAI提示缓存的原理、性能影响与优化策略。内容涵盖缓存命中机制、KV缓存技术原理、成本与延迟影响,以及提高命中率的实用技巧,如稳定前缀、使用prompt_cache_key、选择Responses API等。同时提供故障排除指南和扩展缓存配置方法,帮助开发者在实际项目中有效利用提示缓存,降低成本和延迟。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:高级
- 验证等级:V1
- 原文作者:erikakettleson-openai
- 原文日期:2026-02-18
- 来源许可:MIT
- 来源版本:
b1414bc82b482bf9d51baadb34806b82810a8541 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员