使用Claude执行内容政策:构建可审计的内容审核管道
技术背景
内容审核需要在发布前按书面策略检查内容并决定发布、拒绝或转人工。策略由策略、法律或品牌团队用自然语言撰写,而内容到达速度远超人工阅读速度,核心矛盾是策略由人用散文写成,执行却需要一致、廉价且可审计。直接把策略粘贴进提示词请求裁决在演示中可行,但生产规模下会出现同一内容不同运行得到不同裁决、拒绝理由为模型生成的任意文字、策略变更成为不可审查的提示词编辑等问题。本方案将问题重构为:Claude只负责把策略编译为规则、把内容抽取为类型化字段,裁决由纯函数规则引擎完成,从而获得可版本化、可差异比较、可重放的规则工件与证据链。
核心原理
管道由四个组件构成:Schema由你编写,定义内容可被知晓的类型化字段,字段描述同时充当抽取指令与编译器映射依据,字段可有意为null表示无法判断;Compiler由Claude在每次策略变更时运行一次,把每条策略条款转换为针对字段的规则,并由静态验证器检查;Extractor由Claude对每条内容运行一次,一次调用把文本与图像读为类型化字段,使用结构化输出强制类型;Engine无模型,把规则应用于字段,相同输入产生相同裁决并附带逐条断言审计追踪。规则语言中when表示违规,scope与违规分离且可读取上下文,三值逻辑使缺失值求值为未知,本应触发但无法确认的规则产出needs_review而非自信判定。LLM断言通过derived_fields把无法归结为字段比较的条款变成精确的是非判断字段,与其他字段在同一次抽取调用中完成,引擎保持纯净。
架构分析
系统采用编译与执行分离的架构思想:编译阶段昂贵但低频,使用Opus并配合validate_document静态校验与修复循环,任何问题如虚构字段、枚举越界、上下文键泄漏到when都会作为仅修复回合返回给Claude,幻觉无法在与校验器的接触中存活;抽取阶段随内容量线性扩展,使用Sonnet并通过结构化输出与缓存前缀优化;裁决阶段是(rules, fields, context)的纯函数,无模型无IO,可被合规团队单元测试。规则集作为不可变版本化工件,新增规则以新版本追加而非原地编辑。上下文模式承载投放位置等平台已知事实,使同一组字段在不同州评估得出不同裁决而无需重新调用模型。领域抽象为schema.json加context.json加policies.md三个文件,广告创意、市场列表与社区内容复用同一套代码。
完整实战教程
内容审核是指在内容发布前,根据书面策略检查内容,然后决定如何处理:发布、拒绝或发送给人工审核员。内容可以来自任何地方:用户评论、卖家列表、广告创意、法律必须批准的营销活动。策略由策略、法律或品牌团队用通俗英语编写,而内容到达的速度比任何审核团队能阅读的速度都快。这个循环的每个拥有者都面临着同样的矛盾:策略是由人用散文写成的,但执行需要一致、廉价且可审计。
在本指南中,你将构建一个内容审核管道,其中Claude将书面策略编译为确定性、可审计的规则。你将编译一个真实的广告审批策略,从内容(包括创意图像)中提取类型化字段,并从从不调用模型的规则引擎生成裁决,然后在三个领域上运行相同的管道,并根据标注样本进行测量。
本笔记本中的所有数据均为合成数据。 公司、品牌、策略和创意图像都是为本指南虚构的。所示的规则说明了模式,并不代表真实的广告或审核要求,因此不要将其用作合规指导。
你将学到什么
- 设计提取模式,其描述兼作提取指令
- 一个带有作用域和三值逻辑的小型JSON规则语言
- 使用验证器驱动的修复循环编译策略文本
- LLM断言:将“看起来未满25岁的人”等规则作为模型判断字段
- 使用结构化输出进行提取,包括从图像中提取
- 从一句简单的英语句子添加规则
- 根据三个领域的标注样本进行评估
先决条件
- Python 3.10+ 和一个Anthropic API密钥(在环境变量或
.env文件中设置ANTHROPIC_API_KEY;设置单元格会加载它)。 - 数据随笔记本一起提供(
data/<domain>/):模式、策略文档、标注样本和合成创意图像(所有品牌均为虚构,使用Pillow生成,因此真实标签在构造上就是正确的)。
引擎和两个Claude阶段位于本笔记本旁边的engine.py和pipeline.py中。本指南导入它们并展示值得阅读的部分。如果你在cookbook网站上阅读此内容,完整文件在GitHub上:engine.py和pipeline.py。
成本和运行时间。 笔记本会进行真实的API调用:默认情况下大约需要10到15分钟,花费约1美元;RUN_FULL_EVAL=1(步骤10)会使时间加倍。提交的输出来自完整运行,因此你也可以只是阅读。
方法
显而易见的 LLM 构建方式是将策略粘贴到提示词中,然后请求一个裁决。这在演示中可行,但在生产规模下会引发问题:
| 基于提示词的裁决 | 生产环境所需 |
|---|---|
| 相同内容在不同运行中可能得到不同裁决 | 相同输入,相同决策 |
| 拒绝理由由模型生成的任意文字解释 | 证据链:规则、断言、预期值与实际值 |
| 策略变更是一次不可审查的提示词编辑 | 可版本化、可差异比较、可重放的规则工件 |
本 cookbook 重构了该问题,使 Claude 仅在两个位置运行,并且从不决定裁决:
from IPython.display import Image

Image("images/architecture.png")
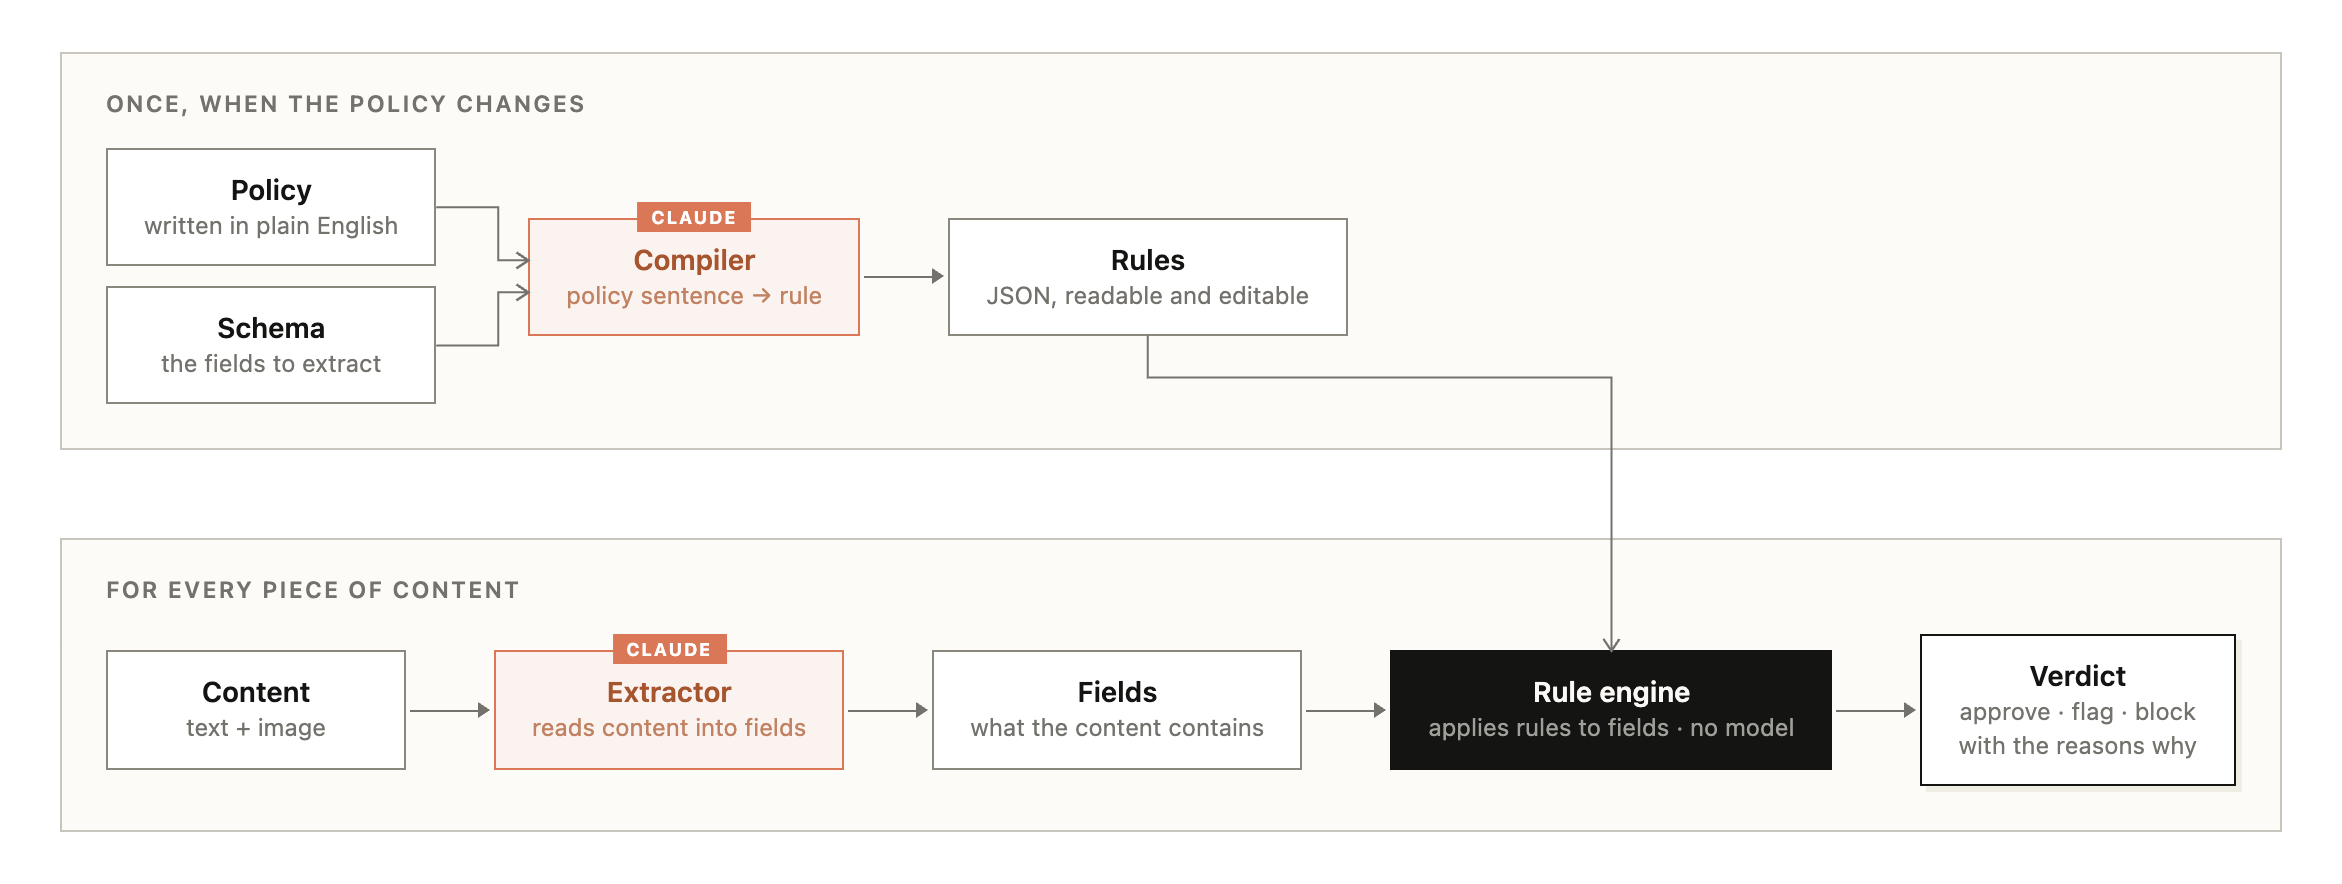
- Schema(由你编写):可以了解某条内容的类型化字段。
- Compiler(Claude,每次策略变更时运行一次):将每条策略条款转换为针对这些字段的规则,由静态验证器进行检查。
- Extractor(Claude,每条内容运行一次):一次调用将文本和图像读取为类型化字段。
- Engine(无模型):将规则应用于字段。相同输入,相同裁决,并带有逐条断言的审计追踪。
规则引擎一直值得信赖;它们从未拥有的是像政策人员一样阅读政策、像审核员一样阅读内容的能力。这正是 Claude 所提供的部分。
这个示例是 Northwind 的广告创意审核,Northwind 是一个虚构的媒体网络。另外两个领域——市场列表和社区内容——复用了每一行代码。
%%capture
%pip install -U "anthropic>=0.109.0" python-dotenv

import json
import pathlib

from dotenv import load_dotenv

load_dotenv()

from engine import evaluate, validate_document
from pipeline import compile_policies, compile_single_rule, extract_fields

DATA = pathlib.Path("data")


def show(obj, limit=2000):
    s = json.dumps(obj, indent=2)
    print(s[:limit] + ("\n… (truncated)" if len(s) > limit else ""))
步骤 1:定义提取模式
这条流水线中的一切都构建在模式之上,所以我们从这里开始。模式是模型与规则引擎之间的契约:它是关于一段内容所能知晓的全部事实的完整集合。有两个设计要点比什么都重要:
- 字段描述承担双重职责。 它们既是 Claude 在运行时遵循的提取指令,也是编译器读取以决定某个策略条款映射到哪个字段的依据。撰写它们时,要像在向一位细心的审阅者做简报。
- 字段可以有意为 null。 像
apr_disclosed这样的字段是boolean | null,因为“无法判断”是一个合法答案,而引擎对它的处理方式与false不同(详见下文的三值逻辑)。
字段混合了客观事实(price_or_rate_shown)与有界判断(text_coverage)。模式正是你决定允许多少判断的地方。
schema = json.loads((DATA / "ad_creatives" / "schema.json").read_text())

for name, spec in schema["properties"].items():
    t = " | ".join(spec["type"]) if isinstance(spec["type"], list) else spec["type"]
    t = f"enum[{', '.join(spec['enum'])}]" if "enum" in spec else t
    print(f"{name:<36} {t}")
print(f"\n{len(schema['properties'])} fields")
上下文模式
规则所需的信息并非都能从内容本身读取。广告将在哪里投放、在哪个渠道投放、广告主是受管理客户还是自助客户:你的平台在任何审核开始之前就已经知道这些信息。这些是关于投放位置的事实,而非关于内容的事实。
这些信息放在第二个更小的模式中,称为上下文模式。你的代码在请求裁决时将它们传入,并且永远不会为它们提取任何内容。在步骤 2 中,你将看到如何将规则限制到特定的上下文,例如“仅在新泽西州”。
context_schema = json.loads((DATA / "ad_creatives" / "context.json").read_text())
show({k: v.get("enum", v["type"]) for k, v in context_schema["properties"].items()})
第 2 步:规则语言
在让 Claude 编译任何内容之前,我们先看看它需要产出什么。
一个编译后的规则集是一份 JSON 文档:
{
  "derived_fields": { /* LLM-judged booleans the compiler needed, see Step 4 */ },
  "rules": [
    {
      "id": "5.1_nj_gambling_helpline",
      "policy_ref": "5.1",
      "policy_text": "Gambling creatives running in New Jersey must display the 1-800-GAMBLER helpline.",
      "action": "block",                       // block = reject; flag = human review
      "scope": {                               // WHERE the rule applies (context ∪ fields)
        "all": [
          {"field": "state", "op": "eq", "value": "NJ"},
          {"field": "ad_category", "op": "eq", "value": "gambling"}
        ]
      },
      "when": {                                // the VIOLATION (fields only)
        "not": {"field": "disclaimer_text", "op": "regex", "value": "1-800-GAMBLER"}
      }
    }
  ],
  "uncompilable": [ /* clauses that map to no field and no judgment; surfaced, not dropped */ ]
}
条件通过 all / any / not 对叶子断言(eq, neq, gt, gte, lt, lte, in, not_in, contains, not_contains, regex, exists)进行组合。三个设计选择至关重要:
when表示违规(规则触发意味着策略被违反),这与 linter 和防火墙规则的约定一致。追踪信息读作“因 X 而触发”。- 作用域与违规分离。“酒类广告必须包含免责声明”是两个陈述:*针对谁*,以及*哪里不对*。作用域还可以读取提取永远无法获知的放置上下文。
- 三值逻辑。缺失值求值为*未知*,而一条本应触发但无法确认的规则会产出
needs_review,而非一个自信的判定。
第 3 步:规则引擎
现在是做决定的部分。引擎(engine.py,约 200 行)是 (rules, fields, context) 的纯函数,没有模型,也没有 I/O。这是你的合规团队可以进行单元测试的部分,也是为什么两段相同的内容永远不会得到不同裁决的原因。它的核心:
def evaluate_rule(rule, fields, context=None):
    rr = RuleResult(rule["id"], rule.get("action", "flag"), "clear")
    if "scope" in rule:
        rr.scope_result = _eval(rule["scope"], {**fields, **(context or {})}, rr.scope_trace)
        if rr.scope_result is False:
            rr.outcome = "out_of_scope"
            return rr
    w = _eval(rule["when"], fields, rr.trace)
    if rr.scope_result is None:  # can't confirm applicability: only a definite pass is safe
        rr.outcome = "clear" if w is False else "unknown"
    else:
        rr.outcome = "fired" if w is True else "clear" if w is False else "unknown"
    return rr

def evaluate(rules, fields, context=None):
    results = [evaluate_rule(r, fields, context) for r in rules]
    fired   = [r for r in results if r.outcome == "fired"]
    unknown = [r for r in results if r.outcome == "unknown"]
    if any(r.action == "block" for r in fired): decision = "block"
    elif fired:                                 decision = "flag"
    elif unknown:                               decision = "needs_review"
    else:                                       decision = "approve"
    ...
_eval 遍历条件树,将每个断言追加到跟踪记录中(带有其 all/any/not 结构),并以 SQL 传播 null 的方式传播未知值。engine.py 还包含 validate_document,即编译器在步骤 5 中修复循环所使用的静态检查器。
试一试
目前还没有涉及任何模型,所以我们可以直接试用这个引擎。手动编写一条规则和一个字段字典,然后观察追踪过程,包括当值为 null 时以及当上下文改变作用域时会发生什么。
demo_rules = [
    {
        "id": "bonus_cap_flag",
        "policy_text": "Sign-up bonuses over $1000 are flagged for review.",
        "action": "flag",
        "when": {"field": "bonus_amount_usd", "op": "gt", "value": 1000},
    },
    {
        "id": "nj_bonus_cap_block",
        "policy_text": "In New Jersey, sign-up bonuses over $1000 are blocked.",
        "action": "block",
        "scope": {"field": "state", "op": "eq", "value": "NJ"},
        "when": {"field": "bonus_amount_usd", "op": "gt", "value": 1000},
    },
]

fields = {"bonus_amount_usd": 1500}

print("── California:")
print(evaluate(demo_rules, fields, {"state": "CA"}).explain())
print("\n── New Jersey — same fields, different scope:")
print(evaluate(demo_rules, fields, {"state": "NJ"}).explain())
print("\n── Bonus amount unreadable (null) — three-valued logic routes to review:")
print(evaluate(demo_rules, {"bonus_amount_usd": None}, {"state": "NJ"}).explain())
第 4 步:LLM 断言
到目前为止,引擎只比较值。但有些政策条款无法归结为对可提取事实的比较:*“酒精类广告创意不得描绘任何看起来未满 25 岁的人。”* 没有任何字段能说明这一点。从引擎内部调用模型会破坏我们刚刚构建的一切,因此编译器改为制造一个字段:一个 derived_fields 条目,其 judge 指令是一个精确的是/否问题,像任何其他字段一样被引用:
"derived_fields": {
  "depicted_person_apparent_under_25": {
    "type": ["boolean", "null"],
    "judge": "True if any person depicted appears to be under 25. Null if no people or indeterminate.",
    "source_policy": "1.1"
  }
},
// rule: {"all": [{"field": "people_depicted", "op": "eq", "value": true},
//                {"field": "depicted_person_apparent_under_25", "op": "eq", "value": true}]}
判断与其他所有字段在同一次抽取调用中完成,因此引擎保持纯净,null 仍然会路由到人工审核。注意上面的 people_depicted 门控:判断规则以其前置条件为门控,因此“创意中没有人物”会将该规则评估为 *clear*,而不是把每一张风景照都送去审核。
编译器按顺序尝试这些:对现有字段的操作符,然后是派生的判断字段,最后是 uncompilable(用于需要外部数据的子句,例如游戏许可证注册表查询)。
第 5 步:编译策略文档
有了模式、规则语言和引擎,我们就可以编译真正的策略了。它的写法与策略团队实际撰写的方式一致:面向人类的散文式条款。在编译之前先阅读它;注意第 1.1 条中关于 25 岁以下的界限(需要判断),第 1.2 条中的许可界限(无法编译),以及第 5 节中的区域规则(作用域)。
policies = (DATA / "ad_creatives" / "policies.md").read_text()
print(policies)
编译器提示词携带 schema、上下文 schema 以及规则格式规范,其中包含六条编译规则(将作用域与违规拆分;一个列出多个值的子句编译为一条 in 规则,而非多份副本;多个要求变为多条规则;优先使用运算符,其次是派生字段,最后是 uncompilable;绝不虚构字段)。
使其具备生产级形态的关键在于 pipeline.compile_policies 中的修复循环:validate_document 对输出进行静态校验,任何问题(虚构的字段、超出其集合的枚举值、泄漏到 when 中的上下文键)都会作为仅修复的回合返回给 Claude。幻觉无法在与校验器的接触中存活。
for round_no in range(max_repair_rounds + 1):
    doc = _parse_json_reply(claude_reply(messages))
    problems = validate_document(doc, schema, context_schema)
    if not problems:
        return doc, attempts
    messages += [assistant(reply), user("Fix ONLY these problems: " + json.dumps(problems))]
compiled, attempts = compile_policies(policies, schema, context_schema)

for a in attempts:
    status = "clean" if not a["problems"] else json.dumps(a["problems"])
    print(f"round {a['round']}: {status}")
print(
    f"\n{len(compiled['rules'])} rules · {len(compiled.get('derived_fields', {}))} derived fields · "
    f"{len(compiled.get('uncompilable', []))} uncompilable"
)
print("\nrule ids:", ", ".join(r["id"] for r in compiled["rules"]))
print("\nderived fields:")
for name, spec in compiled.get("derived_fields", {}).items():
    print(f"  {name}: {spec['judge'][:110]}")
print("\nuncompilable:")
for u in compiled.get("uncompilable", []):
    print(f"  [{u['policy_ref']}] {u['policy_text'][:80]}… → {u['reason'][:100]}")
验证器能捕获什么
要了解修复循环在防御什么,可以用三种不同的方式破坏一条规则,然后进行验证。在实际编译中,这些确切的错误消息会返回给 Claude 进行修复。
broken = {
    "derived_fields": {},
    "rules": [
        {
            "id": "bad1",
            "action": "block",
            "when": {"field": "creative_has_disclamer", "op": "eq", "value": True},
        },  # invented field
        {
            "id": "bad2",
            "action": "block",
            "when": {"field": "ad_category", "op": "eq", "value": "liquor"},
        },  # not in the enum
        {
            "id": "bad3",
            "action": "block",
            "scope": {"field": "ad_category", "op": "eq", "value": "gambling"},
            "when": {"field": "state", "op": "eq", "value": "NJ"},
        },  # context key in `when`
    ],
}
show(validate_document(broken, schema, context_schema))
与手写规则集对比
rules.golden.json 是我们对同一策略的手写编译版本。编译版本通常覆盖相同的条款,但往往更依赖派生字段(从语义上判断“是否有理性饮酒信息”,而不是使用脆弱的 regex)。可以说更好,但它将更多表面判断交给了模型判断;这种权衡需要由你来审查,这正是规则作为工件存在的意义。
在本笔记本的剩余部分,我们使用黄金规则集,这样结果在每次运行时都可复现;替换为 compiled 即可使用你自己的规则集。
golden = json.loads((DATA / "ad_creatives" / "rules.golden.json").read_text())
assert not validate_document(golden, schema, context_schema)

g_refs = {r["policy_ref"] for r in golden["rules"]}
c_refs = {r.get("policy_ref") for r in compiled["rules"]}
print("clause coverage — golden:", sorted(g_refs))
print(
    "missing vs golden:",
    sorted(g_refs - c_refs) or "none",
    "· extra:",
    sorted(c_refs - g_refs) or "none",
)

active = golden  # ← the ruleset used below
第 6 步:从内容中提取字段
我们已经有了规则。现在我们需要字段来对它们运行规则,这就是提取(pipeline.extract_fields):每段内容调用一次 Claude。这个调用会随内容量扩展,因此使用 Sonnet,而编译(每次策略变更时调用一次)使用 Opus。输出 schema 是提取 schema 加上规则集中被评判的字段,并通过结构化输出强制执行,因此字段会以带类型的形式返回:
response = _client().messages.create(
    model=EXTRACTOR_MODEL,
    system="You extract facts. You decide nothing about policy; report only what you observe.",
    messages=[{"role": "user", "content": [image_block, {"type": "text", "text": prompt}]}],
    output_config={"format": {"type": "json_schema",
                              "schema": build_extraction_schema(schema, derived_fields)}},
)
派生判断作为字段附带,其描述以 JUDGMENT: 开头,而 null 表示“确实无法判断”,绝不是“懒得判断”。完整源码:pipeline.py。
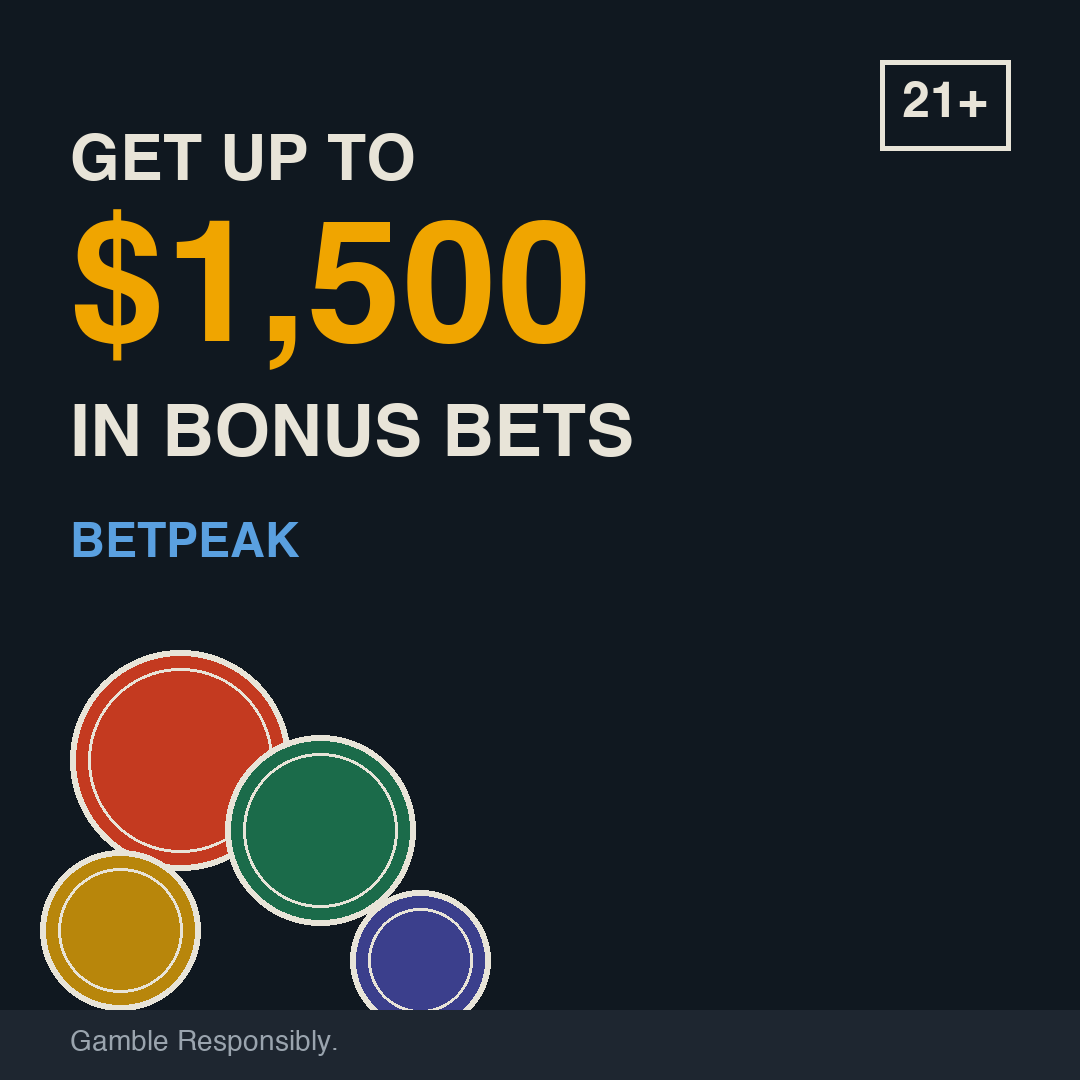
在一个合成的体育博彩创意上运行它。这里所有与政策相关的内容都是在合成图像时故意放置的:一个 $1,500 的奖金数字、一个 21+ 的徽章,以及一条小字说明写着 *“负责任地博彩。”* 但没有新泽西州要求的 1-800-GAMBLER 求助热线。
from IPython.display import Image as IPImage
from IPython.display import display

img_path = DATA / "ad_creatives" / "images" / "betpeak_bonus.png"
display(IPImage(str(img_path), width=380))

submission = {
    "headline": "Get up to $1,500 in bonus bets",
    "body": "New BetPeak members get up to $1,500 in bonus bets on signup. 21+.",
    "brand": "BetPeak",
    "targeting": {"min_age": 21, "geo": "US-NJ"},
}
fields = extract_fields(submission, schema, active.get("derived_fields", {}), image_path=img_path)
show(fields)
步骤 7:评估
字段已提取,规则已编译:现在判定只是一个函数调用。每条触发的规则都会指明其政策条款,每个断言都会显示预期值与实际值。而且由于评估是免费的,更改放置上下文不会重新调用模型:同一组字段在新泽西州和加利福尼亚州评估会得出不同的判定,原因你可以明确指出。
print("── New Jersey placement:")
print(
    evaluate(
        active["rules"],
        fields,
        {"country": "US", "state": "NJ", "channel": "display", "advertiser_tier": "managed"},
    ).explain()
)

print("\n── Same fields, California placement — zero model calls:")
print(
    evaluate(
        active["rules"],
        fields,
        {"country": "US", "state": "CA", "channel": "display", "advertiser_tier": "managed"},
    ).explain()
)
步骤 8:用自然语言添加规则
策略变更很少以重写文档的形式出现。它们通常以策略团队的一句话形式到来。pipeline.compile_single_rule 以相同的方式逐条编译:针对模式编译该句子(在合适时复用现有的派生字段),使用相同的修复循环进行验证,并将新增内容作为规则集的新版本追加。请注意,一个句子可以合理地编译为*多条*规则(通常标记,但在某个州阻止),并且编译器被告知不要合并或丢弃任何部分。
addition = compile_single_rule(
    "Sign-up bonus offers greater than $1000 must be flagged for review, "
    "and in New Jersey they are blocked outright.",
    active,
    schema,
    context_schema,
)
show(addition)

# Append as a new ruleset version (never edit in place; rulesets are versioned artifacts)
active_v2 = {
    "derived_fields": {**active["derived_fields"], **addition["derived_fields"]},
    "rules": active["rules"] + addition["rules"],
    "uncompilable": active.get("uncompilable", []),
}
assert not validate_document(active_v2, schema, context_schema)
print(f"\nruleset v2: {len(active_v2['rules'])} rules")
BetPeak 的创意广告宣传 1,500 美元奖金,因此新规则应能捕获它。我们之前运行的提取中并未包含派生判断,因此需针对 v2 的派生字段重新提取,然后进行评估。注意加利福尼亚州的标记与新泽西州的阻止。
fields_v2 = extract_fields(submission, schema, active_v2["derived_fields"], image_path=img_path)
print("── New Jersey, ruleset v2:")
print(
    evaluate(
        active_v2["rules"],
        fields_v2,
        {"country": "US", "state": "NJ", "channel": "display", "advertiser_tier": "managed"},
    ).explain()
)
第 9 步:尝试另一个领域
除了三个数据文件之外,上面没有任何内容提到广告。一个领域就是
schema.json + context.json + policies.md。这里还有两个:
product_listings:第三方市场商品列表(假冒信号、ugc:社区评论和评价(骚扰、PII、垃圾信息、按表面范围限定的
医疗声明、平台外支付、卖家层级和地区规则)
脏话规则)
分别编译每个领域,并端到端运行一个代表性样本。(编译后的规则集缓存在
evaluation/compiled/ 下,因此重新运行时不会重新编译。)
CACHE = pathlib.Path("evaluation/compiled")
CACHE.mkdir(parents=True, exist_ok=True)


def load_domain(name):
    d = DATA / name
    return {
        "dir": d,
        "schema": json.loads((d / "schema.json").read_text()),
        "context": json.loads((d / "context.json").read_text()),
        "policies": (d / "policies.md").read_text(),
        "samples": [
            json.loads(line)
            for line in (d / "samples.jsonl").read_text().splitlines()
            if line.strip()
        ],
    }


def rules_for(name, dom):
    if name == "ad_creatives":
        return golden
    cache = CACHE / f"{name}.json"
    if cache.exists():
        return json.loads(cache.read_text())
    doc, attempts_ = compile_policies(dom["policies"], dom["schema"], dom["context"])
    cache.write_text(json.dumps(doc, indent=2))
    return doc


for name in ["product_listings", "ugc"]:
    dom = load_domain(name)
    doc = rules_for(name, dom)
    assert not validate_document(doc, dom["schema"], dom["context"])
    s = dom["samples"][1]  # a violating sample from each domain
    f = extract_fields(s["submission"], dom["schema"], doc.get("derived_fields", {}))
    v = evaluate(doc["rules"], f, s["context"])
    print(f"═══ {name}: {len(doc['rules'])} rules · sample: {s['name']}")
    print("   " + v.explain().replace("\n", "\n   "), "\n")
步骤 10:衡量效果
最后,整个流程的效果如何?每个领域都提供了 samples.jsonl:包含提交内容(其中一些带有创意图片)以及在该领域策略下的预期决策。提取是唯一非确定性的阶段,因此这实际上是一个提取评估,而这正是你在生产环境中应该投入调优精力的地方(字段描述、评判指令、图像质量)。
为了让这个 notebook 的执行成本保持低廉,下面的单元格默认每个领域运行 2 个样本。在你的环境中设置 RUN_FULL_EVAL=1(或运行 evaluation/run_eval.py)以获取完整的 22 个样本表格。下面提交的输出来自一次完整运行。
import os

FULL = os.environ.get("RUN_FULL_EVAL") == "1"
PER_DOMAIN = None if FULL else 2  # token-light default; RUN_FULL_EVAL=1 for all samples

totals = {"correct": 0, "n": 0}
for name in ["ad_creatives", "product_listings", "ugc"]:
    dom = load_domain(name)
    doc = rules_for(name, dom)
    samples = dom["samples"][:PER_DOMAIN] if PER_DOMAIN else dom["samples"]
    correct = 0
    print(
        f"═══ {name} — {len(samples)} of {len(dom['samples'])} samples"
        + ("" if FULL else "  (subset — set RUN_FULL_EVAL=1 for all)")
    )
    for s in samples:
        image = dom["dir"] / s["image"] if s.get("image") else None
        f = extract_fields(
            s["submission"], dom["schema"], doc.get("derived_fields", {}), image_path=image
        )
        v = evaluate(doc["rules"], f, s["context"])
        ok = v.decision == s["expected"]
        correct += ok
        mark = "✓" if ok else "✗"
        fired = ", ".join(r.rule_id for r in v.fired) or "—"
        print(
            f"  {mark} {s['name']:<38} expected {s['expected']:<12} got {v.decision:<12} fired: {fired}"
        )
    print(f"  → {correct}/{len(samples)}\n")
    totals["correct"] += correct
    totals["n"] += len(samples)

print(
    f"TOTAL: {totals['correct']}/{totals['n']} decisions correct "
    f"({100 * totals['correct'] / totals['n']:.0f}%)"
)
一个边界案例
有一个 UGC 样本确实处于边界地带:一个新账户发帖说 *“我在我的博客上写了一篇更长的回复:[链接]”*。预期结果是 flag(新账户链接审核),但根据运行情况,提取器有时会将其判定为 promotional: true,从而升级为 block。无论哪种情况,提取本身都没有错;只是 schema 让边界变得模糊。
这里的教训在于修复路径:你不需要改动规则或引擎,而是细化字段描述并重新运行评估。这里的提示工程影响范围狭窄且可衡量:一个字段、一段描述、表格中的一个数字。
将其投入生产
编译在每次策略变更时运行一次;抽取是每份内容一次调用,因此在规模化时你只需优化一个提示词(将 schema 放入缓存前缀,通过 Batch API 运行回填)。针对新的规则集版本或假设情景重新评估已有的抽取结果是免费的。
保持规则集不可变,并为每次审核记录 (content, extracted fields, ruleset version, context, verdict, trace);这能在数月之后回答审计者的“为什么?”,并让你在采纳拟议规则集之前,用历史记录对其进行回放。将 needs_review 路由给人工,并关注其比率:某个字段上不断上升的 null 通常意味着描述需要改进。同时让限制保持可见:带有 uses_llm_fields 的规则依赖于模型判断,而 uncompilable 子句需要此流水线所不具备的系统。
何时使用此模式
适合:策略由你拥有且经常变更,裁决必须能向提交者或审计者解释,同一内容会在不同投放位置或策略版本之间被反复检查,并且策略的负责人不是工程师。
不适合:使用行业标准分类法的单类别检测(CSAM、暴力),此时专用分类器是正确选择;以及没有策略变更故事的一次性分类,此时一个普通的分类提示词更简单。
常见问题
常见错误包括:虚构字段名,验证器会报invented field并触发修复循环;枚举值超出集合,如ad_category填liquor;把上下文键如state泄漏到when中,应放入scope;派生判断缺少前置条件门控,导致每张风景照都被送去审核,应先用people_depicted等字段门控;抽取器把确实无法判断误判为false而非null,导致三值逻辑失效。排查方法:先运行validate_document查看具体问题消息,再检查evaluate的trace逐条断言,确认scope_result与when的求值路径;对边界样本如新账户带链接的UGC,检查是抽取错误还是schema描述模糊,通常只需细化字段描述并重跑评估。生产优化:将schema放入缓存前缀,用Batch API运行回填,保持规则集不可变并记录content、extracted fields、ruleset version、context、verdict、trace以回答审计追问,将needs_review路由给人工并监控其比率,某字段null率上升通常意味着描述需改进,同时让uses_llm_fields与uncompilable保持可见。
企业应用扩展
该模式适合策略由你拥有且经常变更、裁决必须能向提交者或审计者解释、同一内容会在不同投放位置或策略版本间反复检查、且策略负责人不是工程师的场景。不适合使用行业标准分类法的单类别检测如CSAM或暴力,此时专用分类器是正确选择;也不适合没有策略变更故事的一次性分类,普通分类提示词更简单。扩展方向包括:用历史记录在采纳拟议规则集前进行回放,针对新规则集版本或假设情景免费重新评估已有抽取结果,把uncompilable子句接入外部数据源如游戏许可证注册表,以及通过compile_single_rule把策略团队的一句话增量编译为多条规则并作为新版本追加。
总结
本教程面向有编程基础的开发者,讲解如何用Claude把书面内容策略编译为确定性、可审计的规则,并构建端到端审核管道。管道将Claude限制在策略编译与字段抽取两个阶段,裁决由无模型的规则引擎完成,从而保证相同输入得到相同决策,并输出逐条断言的证据链。内容涵盖提取模式设计、带作用域与三值逻辑的JSON规则语言、验证器驱动的修复循环、LLM断言、图像字段抽取、自然语言加规则、跨领域复用与标注样本评估,并给出生产化建议。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:S_CANDIDATE
- 难度:高级
- 验证等级:V1
- 原文作者:aravind-ant
- 原文日期:2026-08-13
- 来源许可:MIT
- 来源版本:
24b98f73983a8d84277e2fa26e13f539644b5778 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员