使用OpenAI API比较语音转文本方法
技术背景
语音转文本(STT)是构建语音助手、实时字幕、会议记录等应用的基础能力。OpenAI提供了多种STT接口,从简单的文件上传到实时流式处理,每种方法在延迟、复杂度、功能上差异显著。开发者常面临选择困难:是追求低延迟还是简单集成?是处理离线文件还是实时音频流?本教程旨在通过对比分析,帮助开发者理解各方法的适用场景和工程权衡,从而做出合理的技术选型。
核心原理
四种方法的核心原理如下:
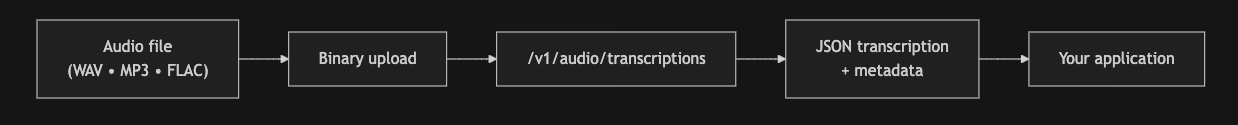
- 文件上传阻塞式:将完整音频文件通过HTTP POST发送至
/audio/transcriptions端点,服务端一次性处理,返回完整转录文本。优点是简单,缺点是必须等待全部处理完成,延迟随音频时长线性增加。 - 文件上传流式:同样上传完整文件,但设置
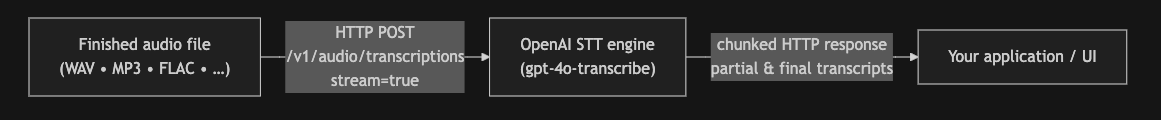
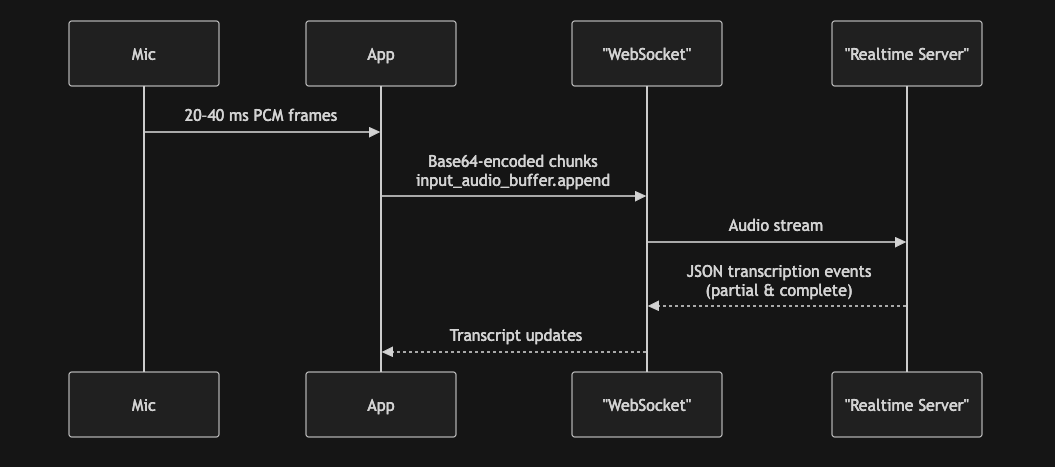
stream=True,服务端以SSE(Server-Sent Events)流式返回部分转录结果(delta)和最终结果(text)。客户端可实时显示增量,提升用户体验,但底层仍需完整文件。 - Realtime WebSocket:建立WebSocket连接,客户端将音频分块(约128ms)以base64编码的PCM16格式实时发送,服务端通过VAD(语音活动检测)自动识别断句,返回增量转录事件(
conversation.item.input_audio_transcription.delta)和完成事件(.completed)。延迟极低(300-800ms),但需处理连接管理、格式转换和会话限制(30分钟)。 - Agents SDK VoicePipeline:基于OpenAI Agents SDK,封装了音频输入流、VAD、缓冲、重连等复杂逻辑,开发者只需定义Agent和工作流,即可实现实时转录并集成到智能体对话中。目前仅支持Python测试版。
架构分析
系统架构设计思想:
- 分层解耦:四种方法可视为不同抽象层次。文件上传是同步REST调用,流式是异步HTTP流,Realtime是长连接WebSocket,Agents SDK则提供高层封装。开发者应根据需求选择合适抽象层。
- 数据流:
- 文件上传:客户端→HTTP请求→OpenAI服务→转录文本。
- 流式:客户端→HTTP请求(stream=True)→SSE流→增量文本。
- Realtime:客户端→WebSocket连接→发送音频块→接收事件流→转录文本。
- Agents SDK:音频输入→VoicePipeline(内部处理VAD、缓冲)→Agent(LLM)→文本输出。
- 关键设计决策:
- Realtime方法中,音频必须为24kHz单声道PCM16,因此需要重采样和格式转换(使用
resampy和soundfile)。 - 流式发送时采用实时节流(
asyncio.sleep)模拟真实音频流,避免服务端缓冲溢出。 - 使用
nest_asyncio解决Jupyter环境中的事件循环冲突。 - Agents SDK的
VoicePipeline封装了音频输入流(StreamedAudioInput),开发者只需提供音频块,SDK处理其余。
完整实战教程
概述
本笔记本为初学者提供了一份清晰、实用的指南,帮助他们快速上手使用OpenAI API进行语音转文本(STT)。你将探索多种实用方法、它们的用例和注意事项。
通过本教程,你将能够根据具体需求选择并应用合适的转录方法。
*注意:*
- *本笔记本为简单起见使用WAV音频文件。它不演示实时麦克风流(例如来自Web应用或直接麦克风输入)。*
- *本笔记本使用WebSockets连接到Realtime API。或者,你也可以使用WebRTC,详见OpenAI文档。*
📊 快速概览
| 模式 | 到首个 token 的延迟 | 最适合的场景(实际示例) | 优势 | 主要限制 |
|--------------------------------|---------------------------|--------------------------------------------------------------|-----------------------------------------------------------|-----------------------------------------------------------|
| 文件上传 + stream=False(阻塞) | 秒级 | 语音信箱、会议录音 | 设置简单 | • 无部分结果,用户需等待文件处理完成才能看到内容 <br>• 每次请求最大 25 MB(长音频需分块) |
| 文件上传 + stream=True | 亚秒级 | 移动应用中的语音备忘录 | 设置简单,通过 token 流提供“实时”体验 | • 仍需完整文件 <br>• 需自行实现进度条 / 分块上传 |
| Realtime WebSocket | 亚秒级 | 网络研讨会中的实时字幕 | 真正的实时;接受连续音频流 | • 音频必须是 pcm16、g711_ulaw 或 g711_alaw <br>• 会话 ≤ 30 分钟,需重连并拼接 <br>• 需自行处理说话人轮次格式以生成完整转录 |
| Agents SDK VoicePipeline | 亚秒级 | 内部帮助台助手 | 实时流式传输,易于构建智能体工作流 | • 仅限 Python 测试版 <br>• API 可能变化 |
安装(一次性)
为了设置你的环境,请在新的 Python 环境中取消注释并运行以下单元格:
!pip install --upgrade -q openai openai-agents websockets sounddevice pyaudio nest_asyncio resampy httpx websocket-client
这会安装跟随笔记本所需的所有必要软件包。
身份验证
在继续之前,请确保您已将 OpenAI API 密钥设置为名为 OPENAI_API_KEY 的环境变量。您通常可以在终端或笔记本环境中设置它:export OPENAI_API_KEY="your-api-key-here"
通过运行下一个单元格来验证您的 API 密钥是否设置正确。
# ─── Standard Library ──────────────────────────────────────────────────────────
import asyncio
import struct
import base64          # encode raw PCM bytes → base64 before sending JSON
import json            # compose/parse WebSocket messages
import os
import time
from typing import List
from pathlib import Path

# ─── Third-Party ───────────────────────────────────────────────────────────────
import nest_asyncio
import numpy as np
from openai import OpenAI
import resampy         # high-quality sample-rate conversion
import soundfile as sf # reads many audio formats into float32 arrays
import websockets      # asyncio-based WebSocket client
from agents import Agent
from agents.voice import (
    SingleAgentVoiceWorkflow,
    StreamedAudioInput,
    VoicePipeline,
    VoicePipelineConfig,
)
from IPython.display import Audio, display
# ───────────────────────────────────────────────────────────────────────────────
nest_asyncio.apply()

# ✏️  Put your key in an env-var or just replace the call below.
OPENAI_API_KEY = os.getenv("OPENAI_API_KEY")

client = OpenAI(api_key=OPENAI_API_KEY)
print("✅ OpenAI client ready")
1 · 使用音频文件的语音转文本
*model = gpt-4o-transcribe*
使用场景
* 您有一个完整的音频文件(最大 25 MB)。支持以下输入文件类型:mp3、mp4、mpeg、mpga、m4a、wav 和 webm。
* 适用于批量处理任务,如播客、呼叫中心录音或语音备忘录。
* 不需要实时反馈或部分结果。
工作原理
 #### 优势
- 易于使用: 单个 HTTP 请求——非常适合自动化或后端脚本。
- 准确性: 一次性处理整个音频,提高上下文和转录质量。
- 文件支持: 支持 WAV、MP3、MP4、M4A、FLAC、Ogg 等格式。
局限性
- 无部分结果: 必须等待处理完成才能看到任何转录。
- 延迟随时长增加: 录音时间越长,等待时间越长。
- 文件大小限制: 最大 25 MB(约 30 分钟,16-kHz 单声道 WAV)。
- 仅限离线使用: 不适用于实时场景,如实时字幕或对话式 AI。
让我们先预览一下音频文件。我已经从这里下载了音频文件。
AUDIO_PATH = Path('./data/sample_audio_files/lotsoftimes-78085.mp3')  # change me
MODEL_NAME = "gpt-4o-transcribe"

if AUDIO_PATH.exists():
    display(Audio(str(AUDIO_PATH)))
else:
    print('⚠️ Provide a valid audio file')
现在,我们可以调用STT端点来转录音频。
if AUDIO_PATH.exists():
    with AUDIO_PATH.open('rb') as f:
        transcript = client.audio.transcriptions.create(
            file=f,
            model=MODEL_NAME,
            response_format='text',
        )
    print('\n--- TRANSCRIPT ---\n')
    print(transcript)
2 · 带音频文件的语音转文字:流式
*model = gpt-4o-transcribe*
使用场景
- 您已经有一个完整的录音文件。
- 您需要即时获取转录结果(部分或最终),结果到达时即可获得。
- 部分反馈能改善用户体验的场景,例如上传较长的语音备忘录。
- 实时感: 用户几乎立即看到转录更新。
- 进度可见性: 中间转录显示进行中的进度。
- 改善用户体验: 即时反馈让用户保持参与。
 #### 优势
局限
- 需要预先提供完整音频文件: 不适用于实时音频流。
- 实现开销: 您必须自行处理流式逻辑和进度更新。
if AUDIO_PATH.exists():
    with AUDIO_PATH.open('rb') as f:
        stream = client.audio.transcriptions.create(
            file=f,
            model=MODEL_NAME,
            response_format='text',
              stream=True
)

for event in stream:
    # If this is an incremental update, you can get the delta using `event.delta`
    if getattr(event, "delta", None):
        print(event.delta, end="", flush=True)
        time.sleep(0.05) # simulate real-time pacing

    # When transcription is complete, you can get the final transcript using `event.text`
    elif getattr(event, "text", None):
        print()
        print("\n" + event.text)
3 · 实时转录 API
*model = gpt-4o-transcribe*
使用场景
* 实时场景下的实时字幕(例如会议、演示)。
* 需要内置的语音活动检测、噪声抑制或令牌级对数概率。
* 熟悉处理 WebSockets 和实时事件流。
工作原理
 #### 优势
- 超低延迟: 通常为 300–800 毫秒,可实现近乎实时的转录。
- 动态更新: 支持部分和最终转录结果,提升用户体验。
- 高级功能: 内置语音活动检测、降噪功能,并可选择详细的日志概率。
局限性
- 集成复杂: 需要管理 WebSocket、Base64 编码和健壮的错误处理。
- 会话限制: 会话时长限制为 30 分钟。
- 格式受限: 仅接受原始 PCM 格式(不支持 MP3 或 Opus);对于 pcm16,输入音频必须是 16 位 PCM,采样率为 24kHz,单声道,小端字节序。
TARGET_SR     = 24_000
PCM_SCALE     = 32_767
CHUNK_SAMPLES = 3_072                 # ≈128 ms at 24 kHz
RT_URL        = "wss://api.openai.com/v1/realtime?intent=transcription"

EV_DELTA      = "conversation.item.input_audio_transcription.delta"
EV_DONE       = "conversation.item.input_audio_transcription.completed"
# ── helpers ────────────────────────────────────────────────────────────────
def float_to_16bit_pcm(float32_array):
    clipped = [max(-1.0, min(1.0, x)) for x in float32_array]
    pcm16 = b''.join(struct.pack('<h', int(x * 32767)) for x in clipped)
    return pcm16

def base64_encode_audio(float32_array):
    pcm_bytes = float_to_16bit_pcm(float32_array)
    encoded = base64.b64encode(pcm_bytes).decode('ascii')
    return encoded

def load_and_resample(path: str, sr: int = TARGET_SR) -> np.ndarray:
    """Return mono PCM-16 as a NumPy array."""
    data, file_sr = sf.read(path, dtype="float32")
    if data.ndim > 1:
        data = data.mean(axis=1)
    if file_sr != sr:
        data = resampy.resample(data, file_sr, sr)
    return data

async def _send_audio(ws, pcm: np.ndarray, chunk: int, sr: int) -> None:
    """Producer: stream base-64 chunks at real-time pace, then signal EOF."""
    dur = 0.025 # Add pacing to ensure real-time transcription
    t_next = time.monotonic()

    for i in range(0, len(pcm), chunk):
        float_chunk = pcm[i:i + chunk]
        payload = {
            "type":  "input_audio_buffer.append",
            "audio": base64_encode_audio(float_chunk),
        }
        await ws.send(json.dumps(payload))
        t_next += dur
        await asyncio.sleep(max(0, t_next - time.monotonic()))

    await ws.send(json.dumps({"type": "input_audio_buffer.end"}))

async def _recv_transcripts(ws, collected: List[str]) -> None:
    """
    Consumer: build `current` from streaming deltas, promote it to `collected`
    whenever a …completed event arrives, and flush the remainder on socket
    close so no words are lost.
    """
    current: List[str] = []

    try:
        async for msg in ws:
            ev = json.loads(msg)

            typ = ev.get("type")
            if typ == EV_DELTA:
                delta = ev.get("delta")
                if delta:
                    current.append(delta)
                    print(delta, end="", flush=True)
            elif typ == EV_DONE:
                # sentence finished → move to permanent list
                collected.append("".join(current))
                current.clear()
    except websockets.ConnectionClosedOK:
        pass

    # socket closed → flush any remaining partial sentence
    if current:
        collected.append("".join(current))

def _session(model: str, vad: float = 0.5) -> dict:
    return {
        "type": "transcription_session.update",
        "session": {
            "input_audio_format": "pcm16",
            "turn_detection": {"type": "server_vad", "threshold": vad},
            "input_audio_transcription": {"model": model},
        },
    }

async def transcribe_audio_async(
    wav_path,
    api_key,
    *,
    model: str = MODEL_NAME,
    chunk: int = CHUNK_SAMPLES,
) -> str:
    pcm = load_and_resample(wav_path)
    headers = {"Authorization": f"Bearer {api_key}", "OpenAI-Beta": "realtime=v1"}

    async with websockets.connect(RT_URL, additional_headers=headers, max_size=None) as ws:
        await ws.send(json.dumps(_session(model)))

        transcripts: List[str] = []
        await asyncio.gather(
            _send_audio(ws, pcm, chunk, TARGET_SR),
            _recv_transcripts(ws, transcripts),
        )  # returns when server closes

    return " ".join(transcripts)
transcript = await transcribe_audio_async(AUDIO_PATH, OPENAI_API_KEY)
transcript
4 · Agents SDK 实时转录
*模型 = gpt-4o-transcribe, gpt-4o-mini*
使用场景
* 利用 OpenAI Agents SDK 以最少设置实现实时转录和合成。
* 希望将转录直接集成到代理驱动的工作流中。
* 倾向于对音频输入/输出、WebSocket 和缓冲进行高级管理。
工作原理
 优势
- 样板代码极少:
VoicePipeline处理重采样、VAD、缓冲、令牌认证和重连。 - 无缝代理集成:支持通过实时音频转录与 GPT 代理直接交互。
局限性
- 仅限 Python 测试版: 尚不支持其他语言;API 可能会发生变化。
- 控制力较弱: 微调 VAD 阈值或数据包调度需要深入 SDK 内部。
# ── 1 · agent that replies in French ---------------------------------------
fr_agent = Agent(
    name="Assistant-FR",
    instructions=
        "Translate the user's words into French.",
    model="gpt-4o-mini",
)

# ── 2 · workflow that PRINTS what it yields --------------------------------
class PrintingWorkflow(SingleAgentVoiceWorkflow):
    """Subclass that prints every chunk it yields (the agent's reply)."""

    async def run(self, transcription: str):
        # Optionally: also print the user transcription
        print()
        print("[User]:", transcription)
        print("[Assistant]: ", end="", flush=True)
        async for chunk in super().run(transcription):
            print(chunk, end="", flush=True)   # <-- agent (French) text
            yield chunk                        # still forward to TTS


pipeline = VoicePipeline(
    workflow=PrintingWorkflow(fr_agent),
    stt_model=MODEL_NAME,
    config=VoicePipelineConfig(tracing_disabled=True),
)

# ── 3 · helper to stream ~40 ms chunks at 24 kHz ---------------------------
def load_and_resample(path: str, sr: int = 24_000) -> np.ndarray:
    """Return mono PCM-16 as a NumPy array."""
    data, file_sr = sf.read(path, dtype="float32")
    if data.ndim > 1:
        data = data.mean(axis=1)
    if file_sr != sr:
        data = resampy.resample(data, file_sr, sr)
    return data

def audio_chunks(path: str, target_sr: int = 24_000, chunk_ms: int = 40):
    # 1️⃣ reuse the helper
    audio = load_and_resample(path, target_sr)

    # 2️⃣ float-32 → int16 NumPy array
    pcm = (np.clip(audio, -1, 1) * 32_767).astype(np.int16)

    # 3️⃣ yield real-time sized hops
    hop = int(target_sr * chunk_ms / 1_000)
    for off in range(0, len(pcm), hop):
        yield pcm[off : off + hop]

# ── 4 · stream the file ----------------------------------------------------
async def stream_audio(path: str):
    sai = StreamedAudioInput()
    run_task = asyncio.create_task(pipeline.run(sai))

    for chunk in audio_chunks(path):
        await sai.add_audio(chunk)
        await asyncio.sleep(len(chunk) / 24_000)   # real-time pacing

    # just stop pushing; session ends automatically
    await run_task        # wait for pipeline to finish
await stream_audio(AUDIO_PATH)
结论
在本笔记本中,你探索了多种使用 OpenAI API 和 Agents SDK 将语音转换为文本的方法,从简单的文件上传到完全交互式的实时流式传输。每种工作流在不同场景下都有其优势,因此请选择最符合你产品需求的那一种。
关键要点
- 将方法与用例相匹配:
- 权衡取舍: 延迟、实现工作量、支持的格式和会话限制因方法而异。
- 保持最新: 模型和 SDK 持续改进;新功能定期发布。
• 离线批处理任务 → 基于文件的转录。
• 近实时更新 → HTTP 流式传输。
• 对话式、低延迟体验 → WebSocket 或 Agents SDK。
后续步骤
- 尝试运行笔记本!
- 将你选择的工作流集成到你的应用程序中。
- 向我们发送反馈!社区见解有助于推动下一轮模型升级。
参考资料
* 探索 Transcriptions API 文档。
* 阅读 Realtime 指南。
* 探索 Agents SDK 参考。
* 探索 Agents SDK 语音管道参考。
常见问题
常见错误及排查:
- API密钥未设置:确保环境变量
OPENAI_API_KEY已设置,否则客户端初始化失败。 - 音频格式不支持:文件上传支持mp3、wav等,但Realtime仅接受PCM16,需用
resampy重采样至24kHz。 - 文件大小超限:文件上传最大25MB,长音频需分块或使用Realtime。
- WebSocket连接失败:检查网络,确保使用正确的URL和认证头(
Authorization: Bearer)。 - 事件循环冲突:在Jupyter中需调用
nest_asyncio.apply()。 - 流式处理中未收到增量:确认
stream=True,并正确处理事件类型(delta和text)。 - Agents SDK版本兼容:API可能变化,确保安装最新版
openai-agents。
生产环境优化:
- 缓存:对重复音频文件使用缓存,减少API调用。
- 并发控制:使用异步客户端或线程池处理多个请求,但注意API速率限制。
- 音频预处理:降噪、静音裁剪可提升转录准确率。
- 错误重试:实现指数退避重试机制,处理瞬时故障。
- 监控:记录延迟、错误率,使用OpenAI提供的日志和指标。
企业应用扩展
进一步学习方向:
- 探索OpenAI Realtime API的WebRTC连接方式,适用于浏览器端实时音频。
- 结合TTS(文本转语音)构建完整的语音对话系统。
- 使用Agents SDK的VoicePipeline集成自定义工具和函数调用,实现复杂智能体。
- 研究流式转录的说话人分离(diarization)功能,用于会议记录。
- 考虑多语言支持,测试不同模型的转录效果。
- 优化音频传输:使用Opus编码降低带宽,但需注意Realtime仅支持PCM16等格式。
总结
本教程面向有编程基础的开发者,系统比较了四种OpenAI语音转文本(STT)方法:文件上传阻塞式、文件上传流式、Realtime WebSocket和Agents SDK VoicePipeline。通过对比延迟、适用场景、优势和限制,帮助读者根据实际需求选择合适方案。教程包含完整代码示例、环境配置、核心原理讲解、架构设计分析、常见错误排查及生产环境优化建议,强调从工程实践角度理解各方法的权衡。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:中级
- 验证等级:V1
- 原文作者:minh-hoque
- 原文日期:2025-04-29
- 来源许可:MIT
- 来源版本:
5bbd95650a4f94fe117cf610cb3951382156e7f3 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员