GPT-4o 与 GPT-4o mini 简介
技术背景
在 GPT-4o 之前,ChatGPT 语音模式依赖三个独立模型分别处理文本、视觉和音频,导致信息割裂、延迟高、上下文不一致。GPT-4o 将文本、视觉和音频统一到一个神经网络中训练,实现原生多模态理解与生成。GPT-4o mini 是轻量版,准确率高于 GPT-3.5 Turbo,速度相当,成本更低,适合大规模多模态应用。当前 API 中 gpt-4o-mini 支持 {text, image} 输入、{text} 输出;音频输入可通过 gpt-4o-audio-preview 预览使用。该技术适用于图像问答、视频摘要、跨模态检索、智能助手等场景,但受限于音频尚未正式集成、视频需帧采样、成本与延迟随输入规模增长。
核心原理
GPT-4o 的核心是单一多模态 Transformer,将文本 token、图像 patch、音频频谱统一映射到共享表示空间,由同一解码器生成文本、音频或图像输出。API 调用遵循 Chat Completions 协议:system 消息设定角色,user 消息可包含 text 和 image_url 内容块,模型返回 assistant 消息。图像支持 Base64 内联或 URL 两种格式,Base64 适合本地文件,URL 适合公开资源。视频处理采用帧采样:用 OpenCV 按固定间隔抽取帧并编码为 Base64,用 MoviePy 提取音频,再分别或联合送入模型。音频转录使用 gpt-4o-audio-preview 的 input_audio 类型,将 Base64 音频数据与格式传入,模型输出转录文本。联合摘要和问答将帧序列与转录文本同时放入 user 消息,使模型在一次请求中融合视觉与听觉上下文,从而获得更准确、更全面的结果。
架构分析
系统分为四层:输入层负责文本、图像、视频、音频的采集与预处理;编码层将图像转为 Base64 或 URL,视频抽帧并编码,音频提取并 Base64 编码;模型层通过 OpenAI SDK 调用 gpt-4o-mini 或 gpt-4o-audio-preview,利用 Chat Completions 接口组织多模态消息;输出层解析 choices[0].message.content,按 Markdown 渲染或进一步处理。关键设计决策包括:统一使用 Chat Completions 协议降低接入成本;图像 detail 参数控制分辨率与成本;视频按秒采样平衡帧数与上下文长度;音频转录与摘要分离,便于复用和调试;联合输入时把转录文本作为 text 块与图像块并列,让模型自行对齐跨模态信息。该架构支持从简单图像问答到复杂视频理解的平滑扩展。
完整实战教程
GPT-4o(“o”代表“omni”)和 GPT-4o mini 是原生多模态模型,旨在处理文本、音频和视频输入的组合,并能生成文本、音频和图像格式的输出。GPT-4o mini 是 GPT-4o 的轻量级版本。
背景
在 GPT-4o 之前,用户可以通过语音模式与 ChatGPT 交互,该模式使用三个独立的模型运行。GPT-4o 将这些能力整合到一个在文本、视觉和音频上训练的单一模型中。这种统一的方法确保所有输入——无论是文本、视觉还是听觉——都由同一个神经网络连贯处理。
GPT-4o mini 是这个全能模型家族的下一个迭代,提供了更小、更便宜的版本。该模型比 GPT-3.5 Turbo 具有更高的准确性,同时速度一样快,并支持多模态输入和输出。
当前 API 能力
目前,gpt-4o-mini 模型支持 {text, image} 输入,输出 {text},与 gpt-4-turbo 的模态相同。作为预览,我们还将使用 gpt-4o-audio-preview 模型来展示通过 GPT-4o 模型进行的转录。
入门指南
为 Python 安装 OpenAI SDK
%pip install --upgrade openai
配置 OpenAI 客户端并提交测试请求
要设置客户端以供我们使用,我们需要创建一个 API 密钥来配合我们的请求。如果您已经有可用的 API 密钥,请跳过这些步骤。
您可以通过以下步骤获取 API 密钥:
- 创建一个新项目
- 在您的项目中生成 API 密钥
- (推荐,但非必需)将您的 API 密钥设置为所有项目的环境变量
完成设置后,让我们从向模型发送一个简单的 {text} 输入开始我们的第一个请求。我们将在第一个请求中同时使用 system 和 user 消息,并从 assistant 角色接收响应。
from openai import OpenAI
import os

## Set the API key and model name
MODEL="gpt-4o-mini"
client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY", "<your OpenAI API key if not set as an env var>"))
completion = client.chat.completions.create(
  model=MODEL,
  messages=[
    {"role": "system", "content": "You are a helpful assistant. Help me with my math homework!"}, # <-- This is the system message that provides context to the model
    {"role": "user", "content": "Hello! Could you solve 2+2?"}  # <-- This is the user message for which the model will generate a response
  ]
)

print("Assistant: " + completion.choices[0].message.content)
图像处理
GPT-4o mini 可以直接处理图像,并根据图像采取智能操作。我们可以提供两种格式的图像:
- Base64 编码
- URL
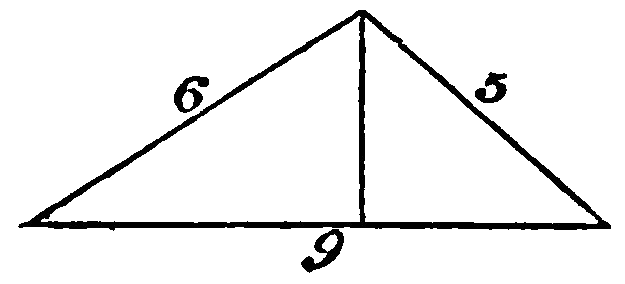
让我们先查看我们将要使用的图像,然后尝试将此图像以 Base64 和 URL 链接两种方式发送到 API
from IPython.display import Image, display, Audio, Markdown
import base64

IMAGE_PATH = "data/triangle.png"

# Preview image for context
display(Image(IMAGE_PATH))
Base64 图像处理
# Open the image file and encode it as a base64 string
def encode_image(image_path):
    with open(image_path, "rb") as image_file:
        return base64.b64encode(image_file.read()).decode("utf-8")

base64_image = encode_image(IMAGE_PATH)

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": "You are a helpful assistant that responds in Markdown. Help me with my math homework!"},
        {"role": "user", "content": [
            {"type": "text", "text": "What's the area of the triangle?"},
            {"type": "image_url", "image_url": {
                "url": f"data:image/png;base64,{base64_image}"}
            }
        ]}
    ],
    temperature=0.0,
)

print(response.choices[0].message.content)
URL 图像处理
response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": "You are a helpful assistant that responds in Markdown. Help me with my math homework!"},
        {"role": "user", "content": [
            {"type": "text", "text": "What's the area of the triangle?"},
            {"type": "image_url", "image_url": {
                "url": "https://upload.wikimedia.org/wikipedia/commons/e/e2/The_Algebra_of_Mohammed_Ben_Musa_-_page_82b.png"}
            }
        ]}
    ],
    temperature=0.0,
)

print(response.choices[0].message.content)
视频处理
虽然无法直接将视频发送到 API,但如果对视频进行帧采样,然后将这些帧作为图像提供,GPT-4o 就能理解视频。
由于 API 中的 GPT-4o mini 尚不支持音频输入(截至 2024 年 7 月),我们将结合使用 GPT-4o mini 和 Whisper 来处理所提供视频的音频和视觉内容,并展示两个用例:
- 摘要生成
- 问答
视频处理的环境配置
我们将使用两个 Python 包来进行视频处理——opencv-python 和 moviepy。
它们依赖 ffmpeg,因此请务必提前安装。根据你的操作系统,你可能需要运行 brew install ffmpeg 或 sudo apt install ffmpeg。
%pip install opencv-python
%pip install moviepy
将视频处理为两个组成部分:帧和音频
import cv2
from moviepy import *
import time
import base64

# We'll be using the OpenAI DevDay Keynote Recap video. You can review the video here: https://www.youtube.com/watch?v=h02ti0Bl6zk
VIDEO_PATH = "data/keynote_recap.mp4"
def process_video(video_path, seconds_per_frame=2):
    base64Frames = []
    base_video_path, _ = os.path.splitext(video_path)

    video = cv2.VideoCapture(video_path)
    total_frames = int(video.get(cv2.CAP_PROP_FRAME_COUNT))
    fps = video.get(cv2.CAP_PROP_FPS)
    frames_to_skip = int(fps * seconds_per_frame)
    curr_frame=0

    # Loop through the video and extract frames at specified sampling rate
    while curr_frame < total_frames - 1:
        video.set(cv2.CAP_PROP_POS_FRAMES, curr_frame)
        success, frame = video.read()
        if not success:
            break
        _, buffer = cv2.imencode(".jpg", frame)
        base64Frames.append(base64.b64encode(buffer).decode("utf-8"))
        curr_frame += frames_to_skip
    video.release()

    # Extract audio from video
    audio_path = f"{base_video_path}.mp3"
    clip = VideoFileClip(video_path)
    clip.audio.write_audiofile(audio_path, bitrate="32k")
    clip.audio.close()
    clip.close()

    print(f"Extracted {len(base64Frames)} frames")
    print(f"Extracted audio to {audio_path}")
    return base64Frames, audio_path

# Extract 1 frame per second. You can adjust the `seconds_per_frame` parameter to change the sampling rate
base64Frames, audio_path = process_video(VIDEO_PATH, seconds_per_frame=1)
## Display the frames and audio for context
display_handle = display(None, display_id=True)
for img in base64Frames:
    display_handle.update(Image(data=base64.b64decode(img.encode("utf-8")), width=600))
    time.sleep(0.025)

Audio(audio_path)
示例 1:摘要生成
现在我们已经有了视频帧和音频,让我们运行几个不同的测试来生成视频摘要,以比较使用不同模态模型的结果。我们预期看到,结合视觉和音频输入上下文生成的摘要将最为准确,因为模型能够利用视频中的全部上下文信息。
- 视觉摘要
- 音频摘要
- 视觉 + 音频摘要
视觉摘要
视觉摘要仅通过向模型发送视频帧来生成。仅凭帧,模型很可能捕捉到视觉方面的信息,但会遗漏演讲者讨论的任何细节。
response = client.chat.completions.create(
    model=MODEL,
    messages=[
    {"role": "system", "content": "You are generating a video summary. Please provide a summary of the video. Respond in Markdown."},
    {"role": "user", "content": [
        "These are the frames from the video.",
        *map(lambda x: {"type": "image_url",
                        "image_url": {"url": f'data:image/jpg;base64,{x}', "detail": "low"}}, base64Frames)
        ],
    }
    ],
    temperature=0,
)
print(response.choices[0].message.content)
结果符合预期——模型能够捕捉视频画面的高层特征,但会遗漏语音中提供的细节。
音频摘要
音频摘要通过将音频转录文本发送给模型来生成。仅凭音频,模型可能偏向音频内容,并会遗漏演示和视觉画面提供的上下文。
GPT-4o 的 {audio} 输入目前处于预览阶段,但不久将整合到基础模型中。因此,我们将使用 gpt-4o-audio-preview 模型来处理音频。
#transcribe the audio
with open(audio_path, 'rb') as audio_file:
    audio_content = base64.b64encode(audio_file.read()).decode('utf-8')

response = client.chat.completions.create(
            model='gpt-4o-audio-preview',
            modalities=["text"],
            messages=[
                    {   "role": "system",
                        "content":"You are generating a transcript. Create a transcript of the provided audio."
                    },
                    {
                        "role": "user",
                        "content": [
                            {
                                "type": "text",
                                "text": "this is the audio."
                            },
                            {
                                "type": "input_audio",
                                "input_audio": {
                                    "data": audio_content,
                                    "format": "mp3"
                                }
                            }
                        ]
                    },
                ],
            temperature=0,
        )

# Extract and return the transcription
transcription = response.choices[0].message.content
print (transcription)
看起来不错。现在让我们总结一下,并用 Markdown 格式化。
#summarize the transcript
response = client.chat.completions.create(
            model=MODEL,
            modalities=["text"],
            messages=[
                {"role": "system", "content": "You are generating a transcript summary. Create a summary of the provided transcription. Respond in Markdown."},
                {"role": "user", "content": f"Summarize this text: {transcription}"},
            ],
            temperature=0,
        )
transcription_summary = response.choices[0].message.content
print (transcription_summary)
音频摘要偏向于演讲中讨论的内容,但相比视频摘要,其结构化程度要低得多。
音频 + 视觉摘要
音频 + 视觉摘要通过同时向模型发送视频中的视觉和音频内容来生成。当同时发送这两者时,模型能够一次性感知整个视频,因此有望更好地进行摘要。
## Generate a summary with visual and audio
response = client.chat.completions.create(
    model=MODEL,
    messages=[
    {"role": "system", "content":"""You are generating a video summary. Create a summary of the provided video and its transcript. Respond in Markdown"""},
    {"role": "user", "content": [
        "These are the frames from the video.",
        *map(lambda x: {"type": "image_url",
                        "image_url": {"url": f'data:image/jpg;base64,{x}', "detail": "low"}}, base64Frames),
        {"type": "text", "text": f"The audio transcription is: {transcription}"}
        ],
    }
],
    temperature=0,
)
print(response.choices[0].message.content)
将视频和音频结合后,我们能够利用视频中视觉和音频元素的信息,为事件生成更详细、更全面的摘要。
示例 2:问答
对于问答,我们将使用与之前相同的概念,对处理后的视频提出问题,同时运行相同的 3 项测试来展示结合输入模态的优势:
- 视觉问答
- 音频问答
- 视觉 + 音频问答
QUESTION = "Question: Why did Sam Altman have an example about raising windows and turning the radio on?"
qa_visual_response = client.chat.completions.create(
    model=MODEL,
    messages=[
    {"role": "system", "content": "Use the video to answer the provided question. Respond in Markdown."},
    {"role": "user", "content": [
        "These are the frames from the video.",
        *map(lambda x: {"type": "image_url", "image_url": {"url": f'data:image/jpg;base64,{x}', "detail": "low"}}, base64Frames),
        QUESTION
        ],
    }
    ],
    temperature=0,
)
print("Visual QA:\n" + qa_visual_response.choices[0].message.content)
qa_audio_response = client.chat.completions.create(
    model=MODEL,
    messages=[
    {"role": "system", "content":"""Use the transcription to answer the provided question. Respond in Markdown."""},
    {"role": "user", "content": f"The audio transcription is: {transcription}. \n\n {QUESTION}"},
    ],
    temperature=0,
)
print("Audio QA:\n" + qa_audio_response.choices[0].message.content)
qa_both_response = client.chat.completions.create(
    model=MODEL,
    messages=[
    {"role": "system", "content":"""Use the video and transcription to answer the provided question."""},
    {"role": "user", "content": [
        "These are the frames from the video.",
        *map(lambda x: {"type": "image_url",
                        "image_url": {"url": f'data:image/jpg;base64,{x}', "detail": "low"}}, base64Frames),
                        {"type": "text", "text": f"The audio transcription is: {transcription}"},
        QUESTION
        ],
    }
    ],
    temperature=0,
)
print("Both QA:\n" + qa_both_response.choices[0].message.content)
比较这三个答案,最准确的答案是通过同时使用视频中的音频和视觉信息生成的。Sam Altman 在主题演讲中并未讨论提高窗口或开启收音机,但提到了模型在单个请求中执行多个功能的改进能力,同时他身后展示了相关示例。
结论
整合音频、视觉和文本等多种输入模态,显著提升了模型在多样化任务上的表现。这种多模态方法能够实现更全面的理解和交互,更贴近人类感知和处理信息的方式。
目前,API 中的 GPT-4o 和 GPT-4o mini 支持文本和图像输入,音频功能即将推出。在此期间,请使用 gpt-4o-audio-preview 处理音频输入。
常见问题
常见错误包括:API 密钥未设置或无效,需检查环境变量 OPENAI_API_KEY;图像路径错误或格式不支持,应确认文件存在且为 PNG/JPEG;Base64 编码遗漏前缀 data:image/png;base64,;视频处理缺少 ffmpeg,需 brew install ffmpeg 或 sudo apt install ffmpeg;帧数过多导致 token 超限,应降低采样率或使用 detail: low;音频格式不匹配,input_audio 需指定 mp3 等正确格式;模型名称拼写错误,如 gpt-4o-mini 与 gpt-4o-audio-preview 混用;请求超时或速率限制,应增加重试与退避。排查时先打印请求体、检查响应状态码与错误信息,再逐步缩小输入范围。生产环境建议:使用异步客户端与连接池,缓存转录结果,压缩图像与音频,设置超时与重试,监控 token 消耗与延迟,对敏感数据做脱敏,并考虑将音频转录与摘要拆分为独立服务以提升可维护性。
企业应用扩展
未来可扩展方向包括:接入正式版音频输入,减少对预览模型的依赖;使用流式响应降低首字延迟;结合向量数据库实现多模态 RAG;对长视频采用分层摘要与关键帧选择;引入函数调用与结构化输出,将多模态理解结果直接写入业务系统;利用 GPT-4o mini 的成本优势做大规模预处理,再用 GPT-4o 做精修;探索图像生成与编辑的闭环工作流;在边缘侧做轻量抽帧与编码,云端只做推理,以优化带宽与隐私。开发者应持续关注 OpenAI 官方文档的模态支持矩阵与定价变化,及时调整架构。
总结
本文面向有编程基础的开发者,系统讲解 GPT-4o 与 GPT-4o mini 的多模态 API 工程实践。内容涵盖模型背景、统一神经网络架构、文本与图像请求、Base64 与 URL 图像处理、视频帧采样与音频转录、视觉/音频/联合摘要及问答对比,并给出环境准备、完整代码分析、常见错误排查与生产优化建议,帮助读者掌握多模态应用的设计与落地方法。
- --
内容来源与验证
- 内容等级:PREMIUM_A
- 质量等级:A
- 难度:中级
- 验证等级:V1
- 原文作者:justonf
- 原文日期:2024-07-18
- 来源许可:MIT
- 来源版本:
f3c21bbf7c2cf115859b42238c888e8ba7837642 - 查看原文
站内还有更多完整实战教程
加入会员,解锁全部教程、完整代码与持续更新内容。
加入会员